- @shibing624


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
相信大家对如下的类别都很熟悉,很多网站都有类似如下的功能,“商品推荐”,”猜你喜欢“。在实体店中我们有导购来为我们服务,在网络上我们需要同样的一种替代物,如果简简单单的在数据库里面去捞,去比较,几乎是完成不了的,这时我们就需要一种协同推荐算法,来高效的推荐浏览者喜欢的商品。一:概念协同过滤算法(Collaborative Filtering),SlopeOne的思想很简单,就是用均值化的思想来掩盖
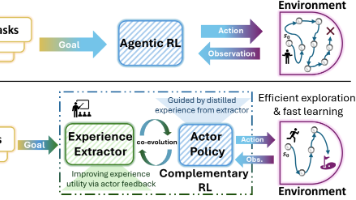
阿里巴巴与港科大团队提出Complementary RL框架,借鉴人脑互补学习系统理论,通过双系统协同进化解决LLM智能体样本效率低下的问题。该框架让策略执行器与经验提取器在强化学习过程中相互促进:执行器优化决策,提取器则根据经验对执行器的实际帮助效果自我改进。实验显示,在单任务场景中性能提升约10%,多任务场景下3任务和6任务混合训练分别带来6.6%和8.1%的提升,且任务多样性越高优势越显著。
过程奖励学习(PRL)通过将稀疏的最终奖励分解为细粒度的过程奖励,显著提升了大语言模型的推理能力。该方法基于严格的数学推导,将未来期望收益与KL成本相结合,定义了每个推理步骤的过程奖励。PRL无需额外训练奖励模型或进行昂贵的蒙特卡洛搜索,可直接集成到现有GRPO框架中。实验表明,PRL不仅提高了平均推理准确率,还拓宽了模型的推理能力边界,为解决强化学习中的信用分配问题提供了高效且理论严谨的解决方案

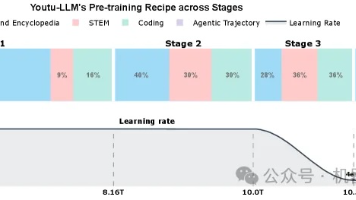
腾讯优图发布Youtu-LLM轻量级大语言模型,仅20亿参数却超越80亿参数模型的性能表现。该研究通过创新架构设计释放了轻量级模型的潜力,在保持高效推理的同时实现了更强的任务处理能力。论文已在arXiv发布,相关代码和模型权重已在GitHub和Hugging Face开源。这一突破为边缘计算场景下的高效AI部署提供了新思路。
MIT团队提出递归语言模型(RLM),突破大语言模型处理长文本的瓶颈。RLM创新性地将长文本作为外部环境变量,让模型通过编写代码递归调用子模型处理信息,实现10M+ token级别的超长文本处理能力。相比传统方法,RLM采用"分而治之"策略,避免了上下文窗口限制和二次方计算成本增长,性能提升可达100倍。该技术借鉴外存算法思想,使模型能像程序员一样按需查阅信息,而非硬记全部内容

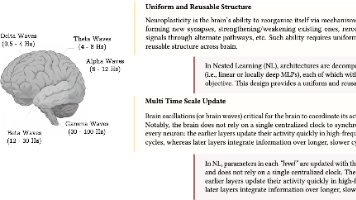
嵌套学习(Nested Learning)是一种全新的机器学习范式,它将模型、优化器和记忆统一看作多层级、并行的优化问题系统,每个组件按自身更新频率分层。基于这一视角,论文提出了 **HOPE**(Higher-Order Continuum Memory Processor)模块,模仿人脑多频率工作机制,实现了真正的持续学习能力,在语言建模、长上下文推理等任务上全面超越现有模型。
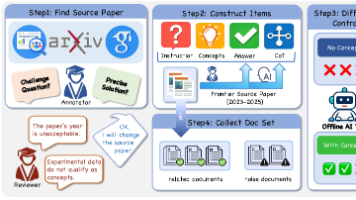
摘要 最新研究DeR2揭示了一个反直觉现象:当大语言模型在RAG(检索增强生成)场景下获得完整参考文档时,其推理表现反而比闭卷测试更差。通过构建包含16个学科领域、严格校准难度的评测数据集,研究发现: 在四种控制设定(仅指令/仅概念/仅相关文档/完整文档集)下,14个前沿模型的平均得分呈现"开卷不如闭卷"现象(完整文档51.1% vs 仅指令55.9%) 主要归因于两大问题:推
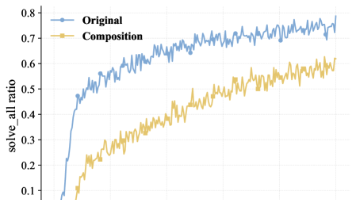
本文提出了一种名为Composition-RL的创新方法,通过将简单数学题拼接组合成复杂题目来提升大模型的推理能力。该方法利用顺序提示词组合(SPC)技术,自动将两道独立数学题合并为一道新题,并保持答案可验证性。实验表明,这种组合显著降低了"全对"样本比例,使训练数据更具挑战性。在多种模型规模(1.5B-30B)的测试中,该方法平均提升8.3个点,在AIME24竞赛题上准确率提
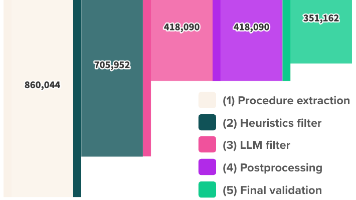
AI2和华盛顿大学团队推出How2Everything框架,系统评估大模型"教人做事"的能力。该研究从98万网页中自动化挖掘出35万份高质量操作指南,覆盖14个主题领域。创新性地提出"关键失败"评估标准,通过二元判定(可用/不可用)取代传统评分,更精准识别步骤遗漏、危险动作等致命错误。研究还训练出8B参数的How2Judge评估模型,与GPT-5评估一致性达
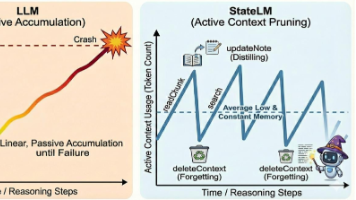
《冥想盆范式:让大模型学会管理自己的上下文》摘要 本文提出StateLM框架,赋予大语言模型自主记忆管理能力。受《哈利·波特》中冥想盆启发,该框架包含外部笔记本和deleteContext操作两个核心组件,使模型能主动压缩关键信息到外部存储并清理冗余上下文。通过两阶段训练(监督学习模仿专家轨迹+强化学习优化决策),StateLM仅需1/4的上下文窗口即可超越传统长上下文模型。在2M token极端