- @qq_55953518


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
我们使用扩散概率模型展示了高质量的图像合成结果,这是一种受非平衡热力学考虑启发的潜在变量模型。我们最好的结果是通过对加权变分界进行训练获得的,该边界是根据扩散概率模型和与朗之万动力学的去噪分数匹配之间的新联系设计的,我们的模型自然承认渐进式有损解压缩方案,可以解释为自回归解码的泛化。在无条件 CIFAR10 数据集上,我们获得了 9.46 的 Inception 分数和 3.17 的最新 FID

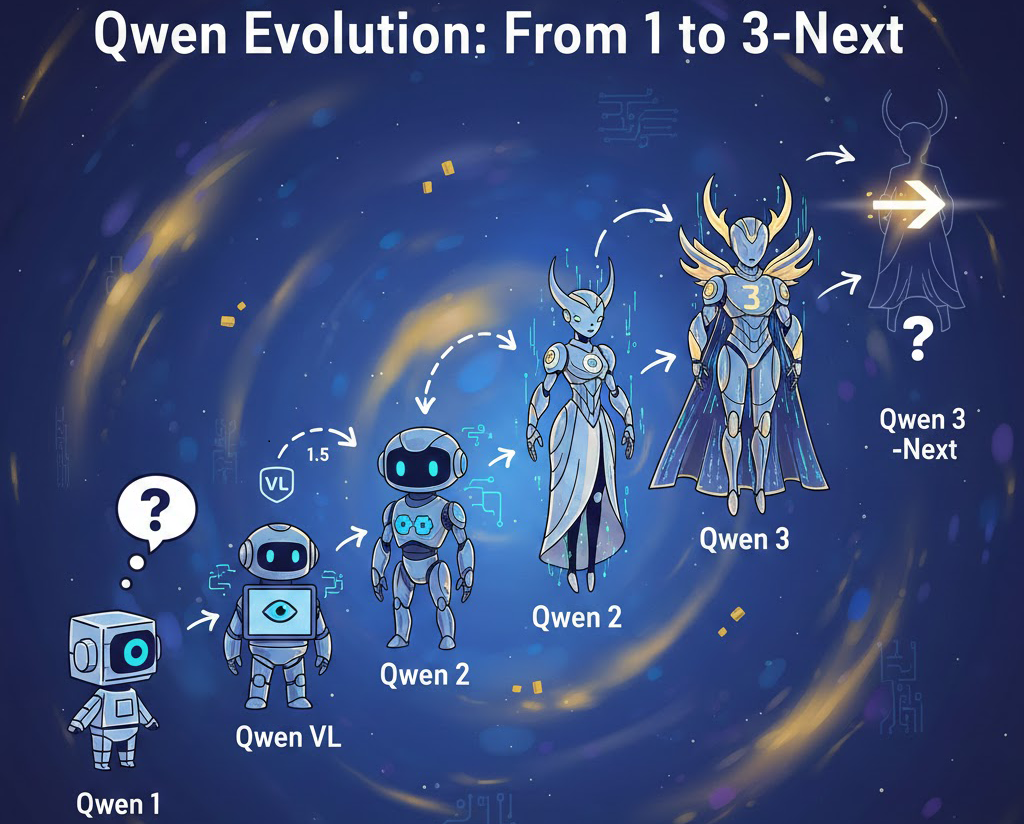
摘要:阿里云通义千问(Qwen)系列模型从初代到3.0版本实现了跨越式发展。Qwen1.0奠定中英双语基础架构,采用RoPE位置编码;1.5版本突破32K长上下文并增强多语言能力;2.0引入SwiGLU激活函数和GQA注意力机制,支持128K上下文;2.5通过双阶段强化学习优化指令遵循;3.0创新性采用双模式思考机制(深度/快速)和MoE稀疏架构。技术演进呈现三大趋势:基础架构从稠密到超稀疏MoE
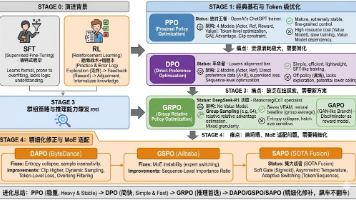
摘要:大模型对齐技术经历了从PPO到SAPO的四阶段演进。PPO作为传统强化学习方法稳定但资源消耗大;DPO简化流程但缺乏探索性;GRPO通过组采样优化实现高效推理训练;最新DAPO/GSPO/SAPO方案则针对长文本和MoE模型进行优化,通过动态采样、序列级约束和软门控等创新解决熵坍塌和稳定性问题。这一演进路径展现了从复杂到精简再到精细化的发展趋势,使大模型在保持性能的同时显著提升了训练效率。
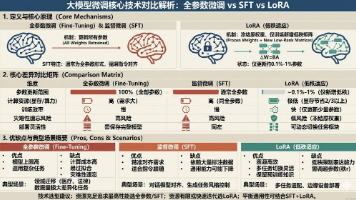
本文对比分析了三种大模型微调技术:全参数微调(更新所有参数)、监督微调(SFT,侧重指令对齐)和LoRA(低秩适应,仅训练少量参数)。全参数微调适合领域重构但成本高,SFT擅长指令对齐,LoRA则资源友好但表达能力受限。建议资源充足时采用全参数微调或SFT,资源有限时选择LoRA,或结合SFT与LoRA实现通用性与专业性的平衡。技术选择应基于具体任务需求、数据特点和算力条件。
摘要:随着大语言模型应用形态的演进,传统NLP评估指标已无法满足需求。本文提出"LLM-as-a-judge"新范式,通过大模型作为裁判进行语义评估,并针对三类主流应用给出具体评估方案:多轮对话系统侧重相关性、知识留存和安全性;RAG系统需分别评估检索质量和生成质量;智能体则需测试工具调用准确率和任务完成度。文中还推荐了RAGAS、DeepEval等开源评估框架,强调评估体系需

本文深入解析LeetCode第11题"盛最多水的容器",通过分析题目核心公式和暴力解法的局限性,重点介绍了双指针优化算法。文章详细阐述了"谁短动谁"的移动策略原理,并给出严谨数学证明,说明该策略能确保最优解。最后提供了Java代码实现和复杂度分析,指出这道题是贪心算法与双指针结合的经典案例,关键在于理解如何通过移动短板指针来高效缩小搜索空间。
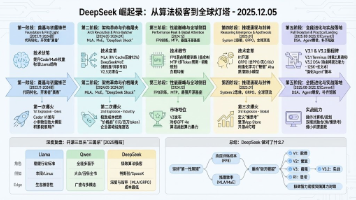
摘要: DeepSeek(深度求索)从2023年至今完成了从追赶者到AGI领跑者的蜕变,其发展分为五个阶段: V1阶段(2023-2024初):聚焦代码与数学能力,以DeepSeek Coder V1在开发者圈层引爆,击败千亿参数模型。 V2阶段(2024年中):通过MLA(多头潜在注意力)和MoE架构实现极致成本优势,发动“价格战”成为企业首选。 V3阶段(2024年底):采用FP8训练和MTP
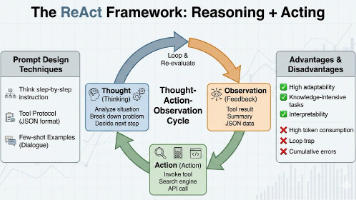
本文深入解析了AIAgent领域的两种主流执行逻辑:ReAct(推理与行动)和Plan-and-Execute(规划与执行)。ReAct采用"思考-行动-观察"的迭代循环,具有灵活性和适应性强的特点,适合处理动态环境;而Plan-and-Execute采用先规划后执行的线性流程,执行效率高但适应性较差。文章通过对比分析两者的优劣势,并以天气查询任务为例展示了不同执行逻辑的行为差
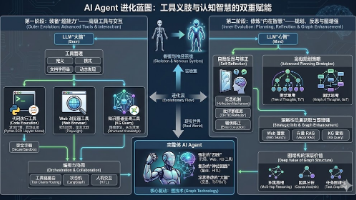
本文探讨了构建高级AIAgent的两大关键进化维度:通过集成工具链赋予"超能力",以及通过反思与规划策略提升认知智慧。在工具层面,重点分析了代码执行、Web浏览器和知识图谱三大"神器"的功能与协同机制,强调结构化定义和动态路由的重要性。在认知层面,提出自我反思机制和复杂规划策略(树状/图状思考),并阐释了知识图谱在推理优化中的核心价值。最终呈现了一个兼具强大
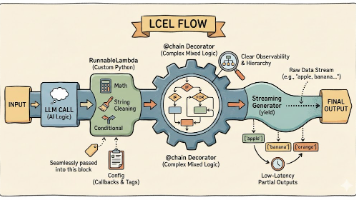
摘要:LangChain表达式语言(LCEL)是AI应用开发的重要工具,提供了10个核心特性解决生产级问题:1)数据流控制(RunnablePassthrough、RunnableParallel);2)运行时参数绑定;3)自定义逻辑嵌入;4)混合开发装饰器;5)流式处理支持;6)容错回退机制;7)记忆管理;8)动态路由决策;9)可视化调试工具。LCEL实现了从脚本开发到声明式编排的转变,通过标准