- @qq_45745941


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
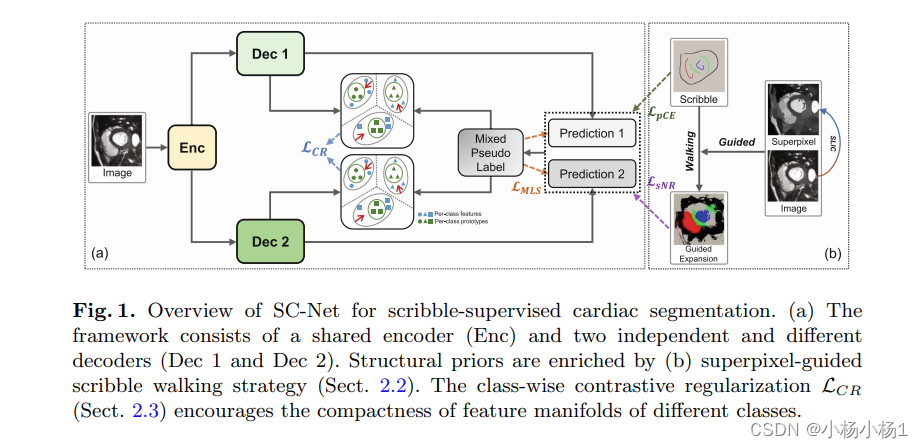
基于深度学习的分割通常需要大量数据和密集的手动描绘,这既耗时又昂贵。因此,弱监督学习试图利用稀疏的注释(如涂鸦)进行有效训练,引起了相当大的关注。然而,这种涂鸦监督本质上缺乏足够的结构信息,导致了两个关键挑战:(i)虽然在dice分数指标上取得了良好的性能,但现有方法难以执行令人满意的局部预测,因为在训练期间无法获得所需的结构先验;(ii)由于稀疏和极不完全的监督,类特征分布不可避免地不那么紧凑,
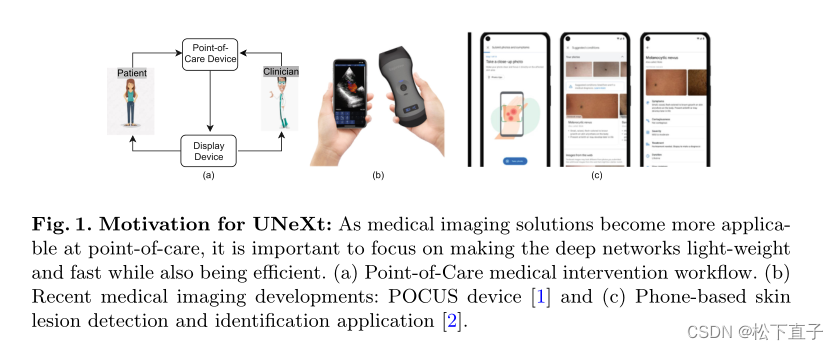
UNeXt:一种基于卷积多层感知器(MLP)的图像分割网络。在早期的卷积阶段和潜在阶段的MLP阶段。我们提出了一个标记化的MLP块,其中我们有效地标记和投影卷积特征,并使用MLP对表征进行建模向MLP反馈的同时改变输入的通道,以便专注于学习局部依赖性。在潜在空间中使用标记化MLP减少了参数的数量和计算复杂性,同时能够产生更好的表示来帮助分割。该网络还包括各级编码器和解码器之间的跳过连接。
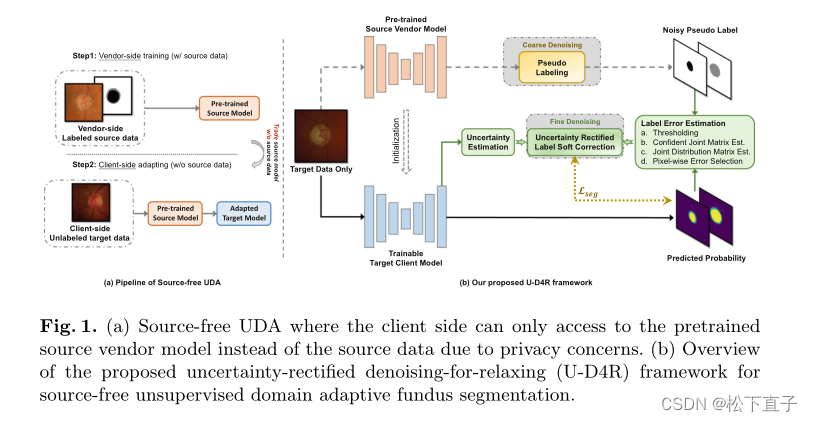
最近,无监督域自适应(UDA)被积极探索用于具有域差异的多点眼底图像分割。尽管放宽了对目标标签的要求,但典型的UDA仍然需要标记的源数据来在适应过程中实现分布对齐。不幸的是,由于隐私问题,供应商方在临床实践中往往无法向目标客户方提供源数据,这使得适应更具挑战性。为了解决这一问题提出了一种新的不确定性校正去噪放松(U-D4R)框架,旨在完全放松源数据,并将预训练的源模型有效地适应目标域考虑到目标域上
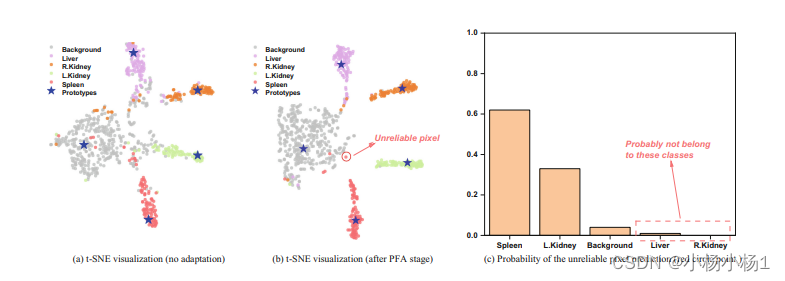
无监督域适应(UDA)因其能够将从有标记的源域中学习到的知识迁移到无标记的目标域而备受关注。然而,典型的UDA方法需要同时访问源域和目标域的数据,这在源数据由于隐私问题而不可用的医学场景中受到很大限制。为了解决无源数据问题,我们提出了一种新颖的两阶段无源域适应(SFDA)框架,用于医学图像分割。在域适应过程中,只能使用经过良好训练的源分割模型和未标记的目标数据。方法原型锚定特征对齐阶段首先利用预训
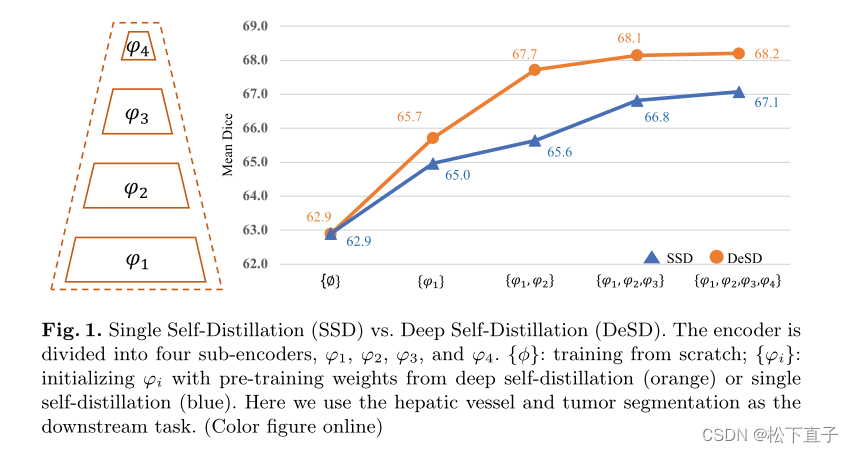
背景自监督学习(SSL)能够在几乎没有注释的情况下实现高级性能,已被证明在医学图像分割中是成功的。通常,SSL依赖于测量在最深层获得的特征的相似性来吸引正对的特征或排斥负对的特征,然后可能遭受浅层的弱监督。本文方法以深度自蒸馏(DeSD)的方式重新制定了SSL,以提高浅层和深层的表示质量。DeSD模型由在线学生网络和动量教师网络组成,两者都由多个子编码器堆叠。对学生网络中的每个子编码器产生的特征进
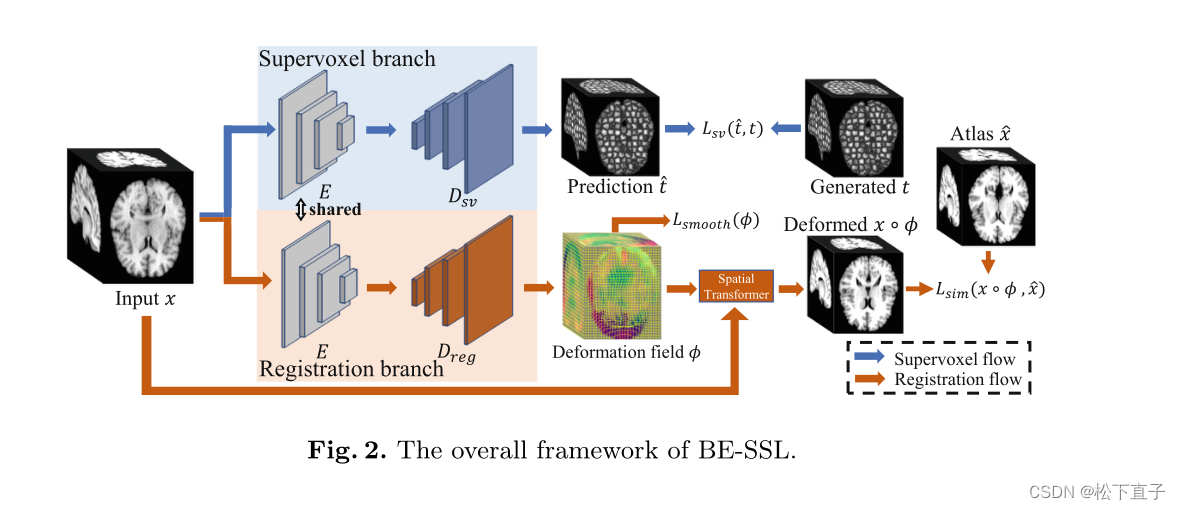
边界增强自监督学习(BE-SSL)利用超体素分割和配准作为两个相关的代理任务。前者通过重构超体素转换的距离变换图来获取边界信息,后一项任务通过在配准中对齐组织和器官,进一步用语义增强边界。代码链接。
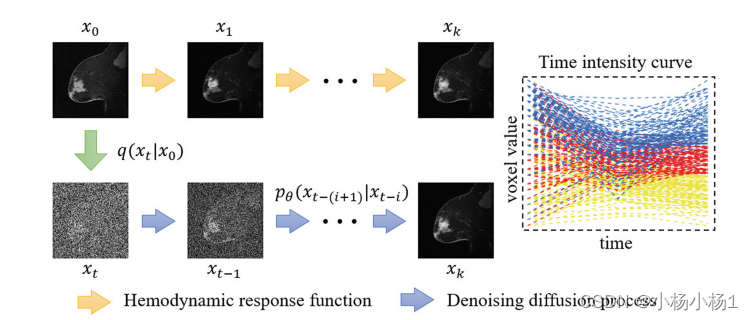
针对现有方法需要完整时间序列数据(尤其是增强后图像)的问题,DKM仅利用预增强图像就能进行有效的乳腺癌分割。DKM隐式地利用了DCE-MRI的血流动力学先验信息,通过建立血流动力学响应函数(HRF)与去噪扩散过程(DDP)之间的关系来实现高质量的分割。DKM由扩散模块(DM)和分割模块(SM)组成,DM可以学习到癌症的血流动力学信息,并提供一个潜在的动力学编码来辅助SM进行分割。实验结果表明,与现
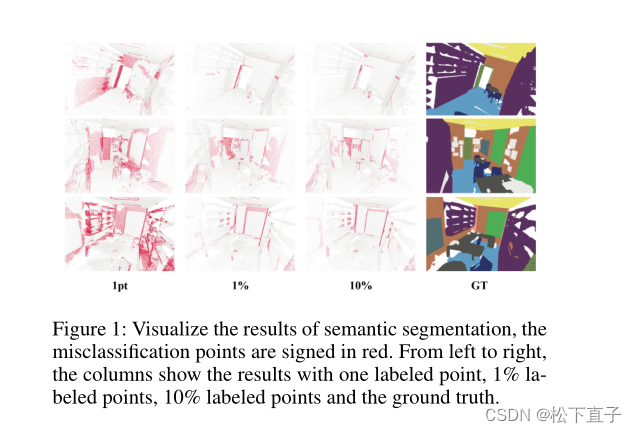
值得注意的是,通道L中的值被复制到每个点的3倍,以保持与分割任务的输入相同的维度。具体来说,对于每个类,根据类赋值矩阵S,选择前k个无标记点,得到mask Mk∈{0,1}N×C,其中mkic = 1表示第i个点的嵌入是与类c相似的前k个点,N是无标记点的个数。此外,为了学习每个点的局部颜色分布,我们引入了一个局部感知正则化项。因此,我们使用标记点为未标记点分配伪标签,并进一步提供额外的监督信息来
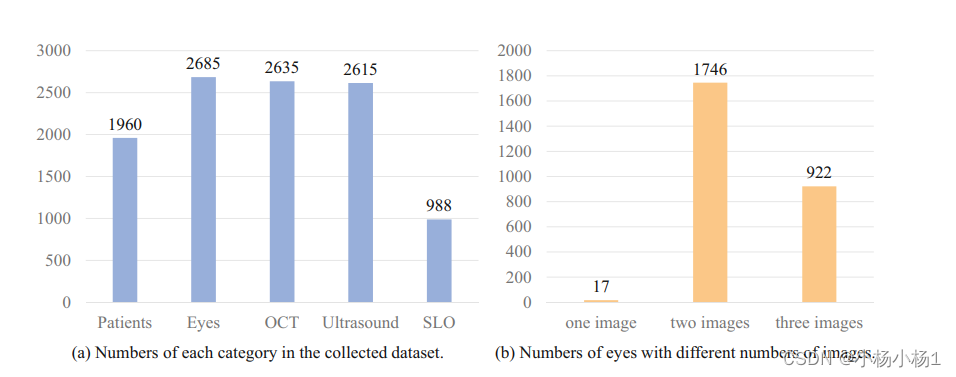
论文提出了一种新颖的框架,利用掩码自注意力机制来预测白内障手术后的视力情况。该方法使用术前图像和患者人口统计数据作为输入,利用多模态信息,这与现有仅依赖单一模态数据的方法不同。该方法还针对不完整的多模态数据问题,采用注意力掩码机制来提高鲁棒性。该框架首先使用高效的Transformer提取每个模态的特征,然后利用注意力融合网络结合多模态信息。该方法在1960名白内障手术患者的数据集上进行了评估代码
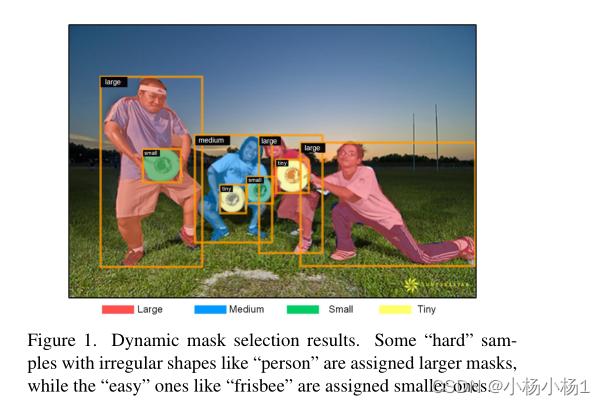
具有代表性的实例分割方法大多采用固定分辨率的mask来分割不同的对象实例,例如28×28网格。然而,低分辨率mask会丢失丰富的细节,而高分辨率mask则会产生二次计算开销。预测每个实例的最优二进制mask是一项具有挑战性的任务。本文方法为不同的对象建议动态选择合适的掩码开发了一种具有自适应特征聚合的双层特征金字塔网络(FPN),以逐步提高掩模网格的分辨率,确保对象的高质量分割。