


- @qq_37555071


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文是转载文章,转载自从MobileNet看轻量级神经网络的发展,删除了文中冗余的部分,并加入许多自己的理解,通过引入具体的计算更清晰的反映出轻量级神经网络MobileNet的本质。文章目录前言MobileNet的优势MobileNet各版本介绍MobileNetV1网络结构MobileNetV2网络结构MobileNetV3网络结构MobileNet各版本特性深度卷积(Depthwise con
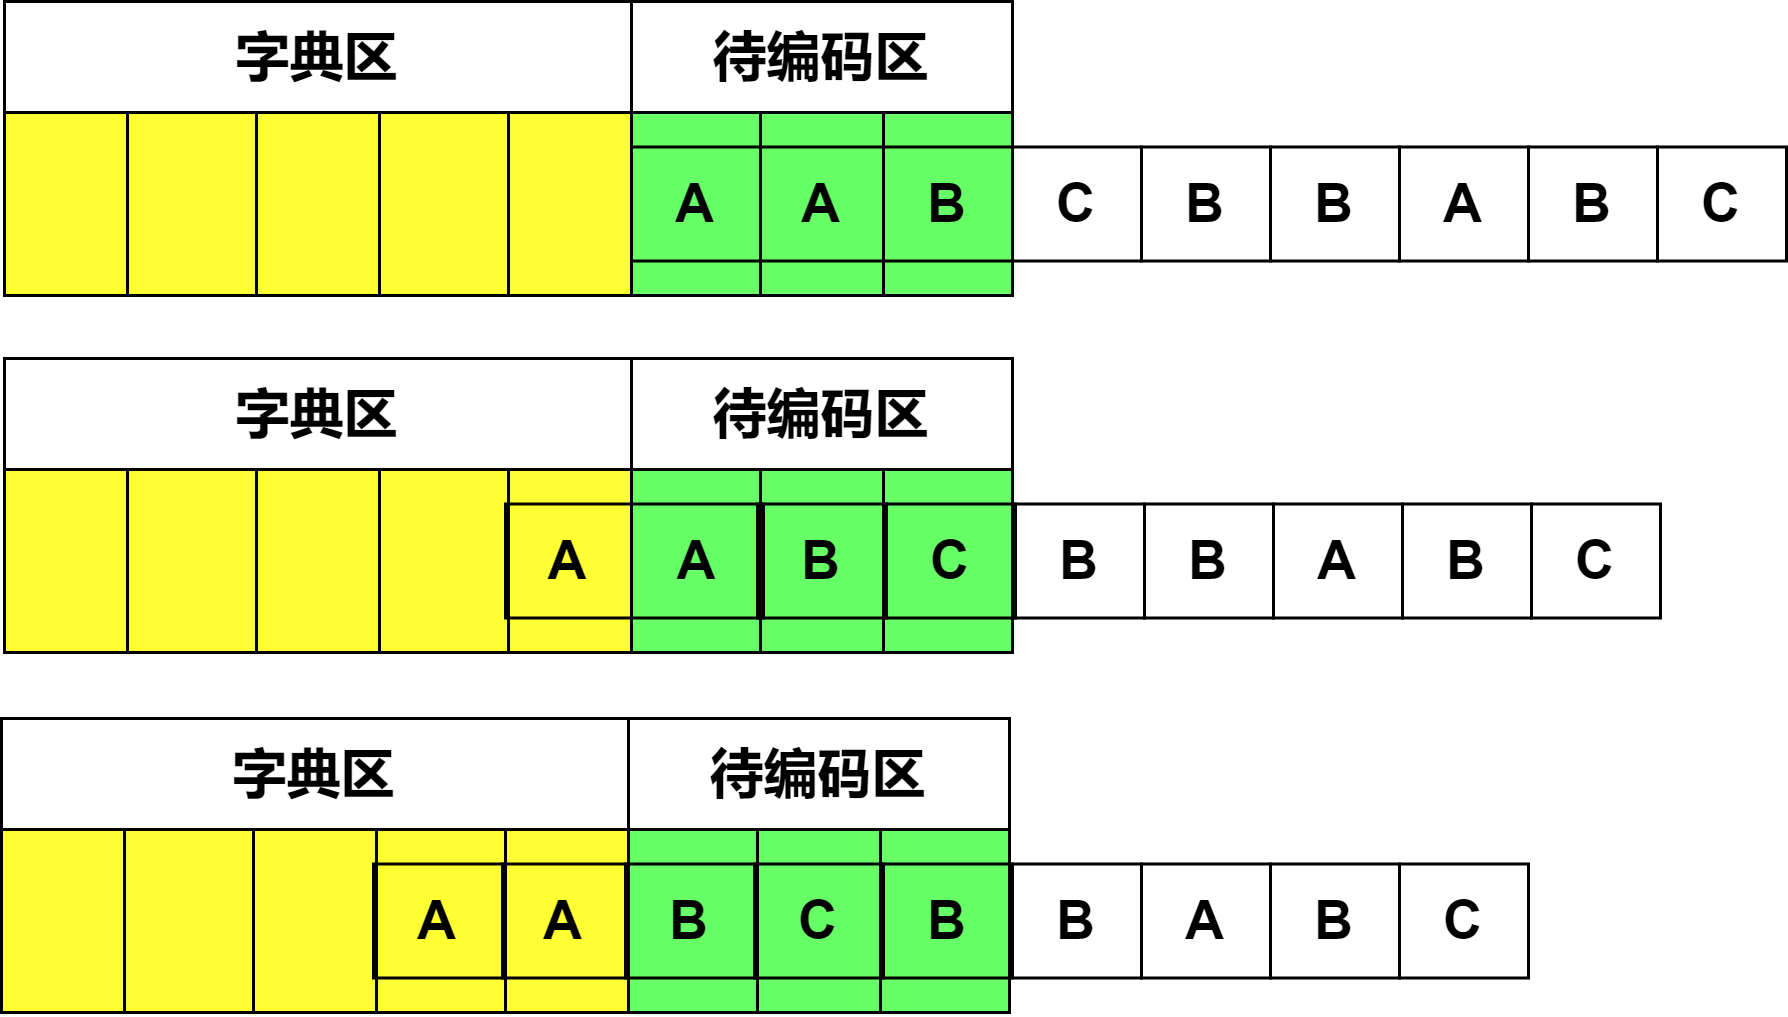
字典编码本质上是将在字典中出现过的字符串使用一个索引值代替,以此来达到压缩目的。基于字典的压缩算法有很多,LZ77和LZ78是最原始的两个算法,后者是前者的变体,原理基本上相似。本文对LZ77字典编码的压缩和解压缩流程进行介绍。...
文章目录1. Flume的定义2. Flume基础架构3. Flume Agent内部原理4. ExecSource、Spooldir Source、Taildir Source的区别5. Flume事务机制6. Flume常用拓扑结构6.1 简单串联6.2 复制和多路复用6.3 负载均衡和故障转移6.4 聚合功能7. 你是如何实现Flume数据传输的监控的8. 你公司采用的Source类型是什么
文章目录一、什么是BDD100K二、数据预处理三、环境配置四、修改模型结构五、迁移学习六、训练BDD100K七、评估性能八、结语一、什么是BDD100KBDD100K是伯克利发布的开放式驾驶视频数据集,其中包含10万个视频和10个任务(因为把交通灯的颜色也区分了出来,实际上是13类分类任务),目的是方便评估自动驾驶图像识别算法的的进展。该数据集具有地理,环境和天气多样性,从而能让模型能够识别多种场
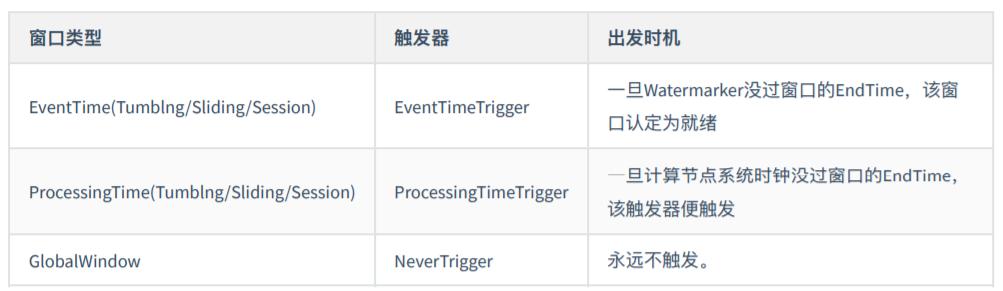
Trigger(触发器)决定了什么时候窗口准备就绪了,一旦窗口准备就绪就可以使用WindowFunction(窗口计算操作)进行计算。每一个 WindowAssigner(窗口分配器) 都会有一个默认的Trigger。如果默认的Trigger不满足用户的需求,用户可以自定义Trigger。
文章目录一、什么是BDD100K二、数据预处理三、环境配置四、修改模型结构五、迁移学习六、训练BDD100K七、评估性能八、结语一、什么是BDD100KBDD100K是伯克利发布的开放式驾驶视频数据集,其中包含10万个视频和10个任务(因为把交通灯的颜色也区分了出来,实际上是13类分类任务),目的是方便评估自动驾驶图像识别算法的的进展。该数据集具有地理,环境和天气多样性,从而能让模型能够识别多种场
文章目录1. 简述hadoop1与hadoop2 的架构异同2. 请介绍一下hadoop的HDFS3. Hadoop的运行模式有哪些4. Hadoop生态圈的组件并做简要描述5. 解释“hadoop”和“hadoop生态系统”两个概念6. 请介绍HDFS的组成架构7. HDFS的文件块大小有什么影响8. HDFS的写(上传)数据流程9. 机架感知(副本存储节点选择策略)10. HDFS的读数据流程
spark.default.parallelism是指RDD任务的默认并行度,Spark中所谓的并行度是指RDD中的分区数,即RDD中的Task数。当初始RDD没有设置分区数(numPartitions或numSlice)时,则分区数采用spark.default.parallelism的取值。Spark作业并行度的设置代码如下:val conf = new SparkConf().set("sp
强烈建议先看一遍hadoop伪分布式集群搭建,然后再按本文的hadoop完全分布式集群搭建进行配置。集群规划四台服务器,分别为layne1~4,分布如下:layne1作为NameNode服务器layne2作为SecondaryNameNode和DataNode服务器layne3、layne4作为DataNode服务器HDFS完全分布式搭建详细步骤如下:1、四台服务器之间互相均可以免密登录可参考我之
文章目录神经网络CNN卷积神经网络CNN的由来局部感受野共享权重池化CNN的结构光栅化LeNet5详解LeNet5-C1层LeNet5-S2层LeNet5-C3层LeNet5-S4层LeNet5-C5层LeNet5-F6层LeNet5-OUTPUT层计算公式LeNet5实战定义网络模型初始化模型参数训练测试准确率预测结果神经网络神经网络可以看成一个端到端的黑盒,中间是隐藏层(可以很深),两边是输入