


- @qq_35338741


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
1:在本地创建一个文件夹名为mat-governance-scala里面进行框架的搭建以及基础类的开发2:在本地创建.gitignore文件,内容如下,表示这些文件不上传到gittarget/project/out/### IntelliJ IDEA ###.idea*.iws*.iml*.iprsrc/test/src/main/scala/META-INF/3:新建README文件新建上就行了
设计背景当企业发展到一定规模时候有了不同的业务线以及数据规模,因为业务的快速发展。这个时候一些数据问题就会出现。问题点1:数据脏乱差,各部门生产线数据重复冗余,还不可:复用用存在数据孤岛2:数据开发部门的业务来自各部门各产品线,需求不明确,每天业务量繁复,日常工作可能成了sqlboy到处捞数据,而且在业务方面还没有业务部门了解的深入,有点缘木求鱼的意思。这个时候数据中台也就应运...

代码日常运行都没问题突然报错如下pymongo.errors.CursorNotFound: cursor id 1598856597812 not found根据异常找到报错位置如下def initMaterialOrgAll(self):materialAndEnterpriseIdList = formmongodbUtil.findAll("form_ins_d0fd94e7-df33-4
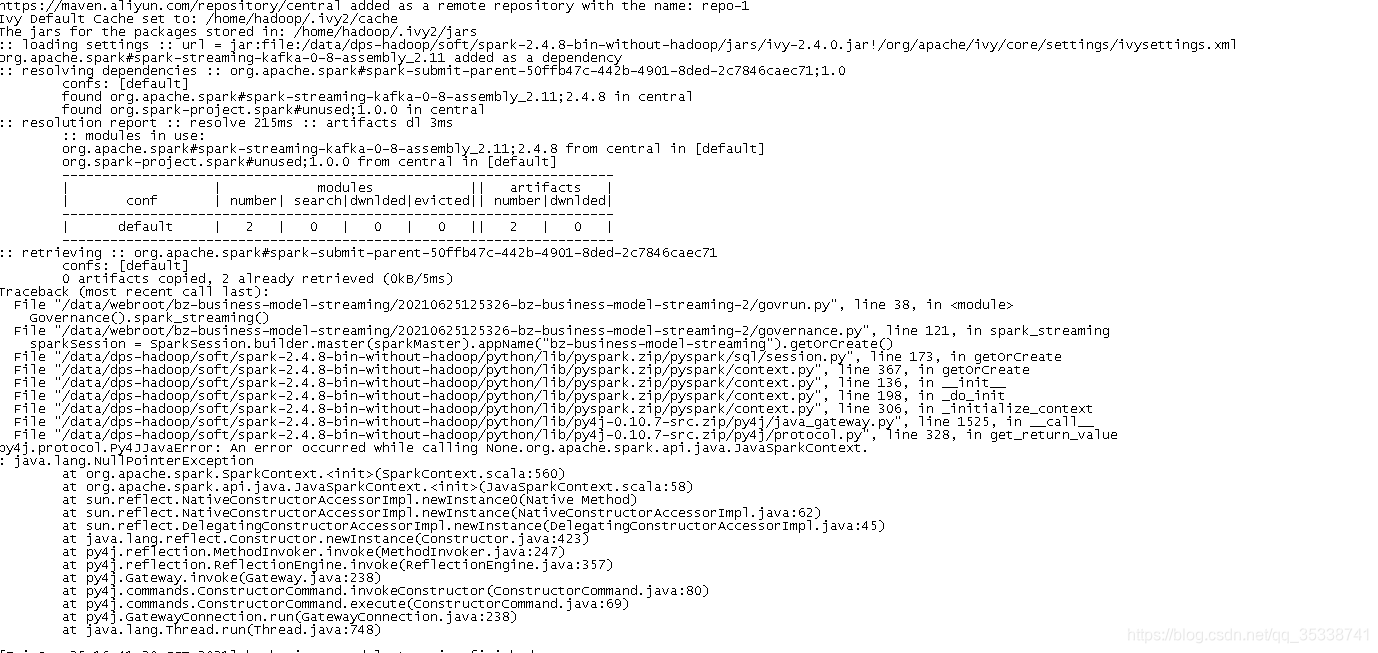
最近公司上云,所有大数据环境都迁移到云上。在进行项目迁移时候发现运行报错py4j.protocol.Py4JJavaError: An error occurred while calling None.org.apache.spark.api.java.JavaSparkContext.: java.lang.NullPointerExceptionat org.apache.spark.Spa
目录背景1:scala版本2:pyspark版本注意:以下都是采坑点RabbitMQ启用MQTT功能背景平常我们会实时监听kafka的数据,并且与流处理框架比如sparkstreaming和flink进行连接进行消费处理,这一套非常成熟且有官方工具包。但是目前有业务场景需要接收rabbitmq的数据,这就比较麻烦了,因为不想kafka有直接的kafkautils能创建流。在sspark1.6以前的
Exception in thread "main" org.apache.hadoop.hbase.client.RetriesExhaustedException: Can't get the locationsat org.apache.hadoop.hbase.client.RpcRetryingCallerWithReadReplicas.getRegionLocations(RpcRe