- @penriver


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
ZenDiscoveryZenDiscovery是ES自己实现的一套用于节点发现和选主等功能的模块7.x之后的ES采用Raft算法进行选主,没有依赖Zookeeper等工具, 详见官方文档涉及的配置如下:discovery.seed_hosts: [“host1”, “host2”]Pass an initial list of hosts to perform discovery when th
1. OkHttp1.1. 概述OkHttp现在应该算是最火的Http第三方库,Retrofit底层也是使用OkHttpOkHttp官网地址:http://square.github.io/okhttp/OkHttp GitHub地址:https://github.com/square/okhttp1.3. 出现背景网络访问的高效性要求,可以说是为高效而生1.3. 特性提供了对 HTTP/2 的支
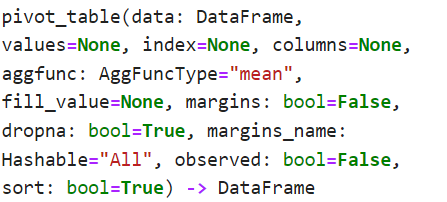
python3学习--使用pandas 数据透视表分析数据--入门示例
1. Unirest1.1. 介绍Unirest 是一套跨语言轻量级HTTP开发库由Kong团队维护,此团队同时维护着另一个著名开源网关项目API Gateway Kong.Unirest 支持多种语言,如Node、Ruby、Java、PHP、Python、Objective-C、.NET 等,可发起 GET, POST, PUT, PATCH, DELETE, HEAD, OPTIONS 请求作
本文针对spark的spark.sql.hive.caseSensitiveInferenceMode的参数含义及使用进行梳理、总结1. 参数含义Spark 2.1.1引入了一个新的配置项:spark.sql.hive.caseSensitiveInferenceMode,默认值是NEVER_INFER,保持与spark 2.1.0一致的行为。但是Spark 2.2.0将此配置的默认值更改为INF
经常听到有人讲:spark写hive 分区表时,原本想覆盖一个分区的数据,但因为错误的编码导致整个表的分区被覆盖。本文针对此问题进行测试。1. 测试结论需要指定如下参数:"spark.sql.sources.partitionOverwriteMode", "dynamic" "hive.exec.dynamic.partition.mode", "nonstrict"saveAsTable方法会
当使用Spark -submit提交Spark应用程序时,经常需要在类路径中包含多个第三方jar, Spark支持多种方式向类路径中添加依赖jar。1. 将jar添加到classpath可以使用spark-submit、spark-defaults.conf和SparkConf属性将多个第三方jar添加到类路径中,在使用这些选项之前,您需要了解这些选项如何应用的优先级。下面是它们按顺序应用的优先级
正常情况下,循环依赖是很少见的,当一个程序包含多个模块,模块之间就可能出现循环依赖,一般情况下,根据错误信息也能解决循环依赖。本文描述一个实际工作中,解决子模块循环依赖的问题1. 原因工作中,基于一个开源项目进行扩展,增加了数据融合相关的逻辑,并把这一块单独放在一个子模块A中。但子模块A需要用到子模块core中定义的一些接口,反过来,子模块core启动时,需要把子模块A实现的逻辑加入,造成子模块A
1. 插件目前很多框架,都采用框架+插件的模式开发。如DataX、FlinkX通过插件支持众多异构数据源, Skywalking通过插件实现针对很多软件如redis、mysql、dubbo等方法执行信息采集。本文针对 skywalking agent 插件加载流程进行源码解析,理解插件的接口定义、加载机制针对skywalking agent的插件开发指导,请参考:https://github.co
**具身智能**作为人工智能发展的一个重要分支,正在迅速崭露头角,成为科技界和大众关注的热门话题,同时在各个领域中展现出巨大的潜力和吸引力**具身智能是由“本体”和“智能体”耦合而成且能够在复杂环境中执行任务的智能系统**。本文讲解具身智能(Embodied AI)的概念、核心要素、难点及突破性进展