


- @paixiaoxin


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文提出了一种新颖的令牌增长方案Token Expansion(ToE),用于加速视觉Transformer(ViT)的训练。ToE通过“初始化-扩展-合并”流程,保持原始Transformer中间特征分布的完整性,防止在加速训练过程中丢失关键可学习信息。实验表明,ToE能够在不损失精度的情况下加速ViT的训练,甚至在某些情况下还能提高性能。此外,ToE可以无缝集成到现有的高效训练框架中,无需调整
本文探讨了如何从视觉变换器(ViT)的角度重新设计轻量级卷积神经网络(CNN),以提高其在移动设备上的性能和效率。研究者们通过将轻量级ViT的高效架构设计整合到标准的轻量级CNN(如MobileNetV3)中,提出了一种新的轻量级CNN家族——RepViT。实验表明,RepViT在各种视觉任务中均优于现有的轻量级ViT模型,并在iPhone 12上实现了超过80%的top-1准确率和1.0 ms的
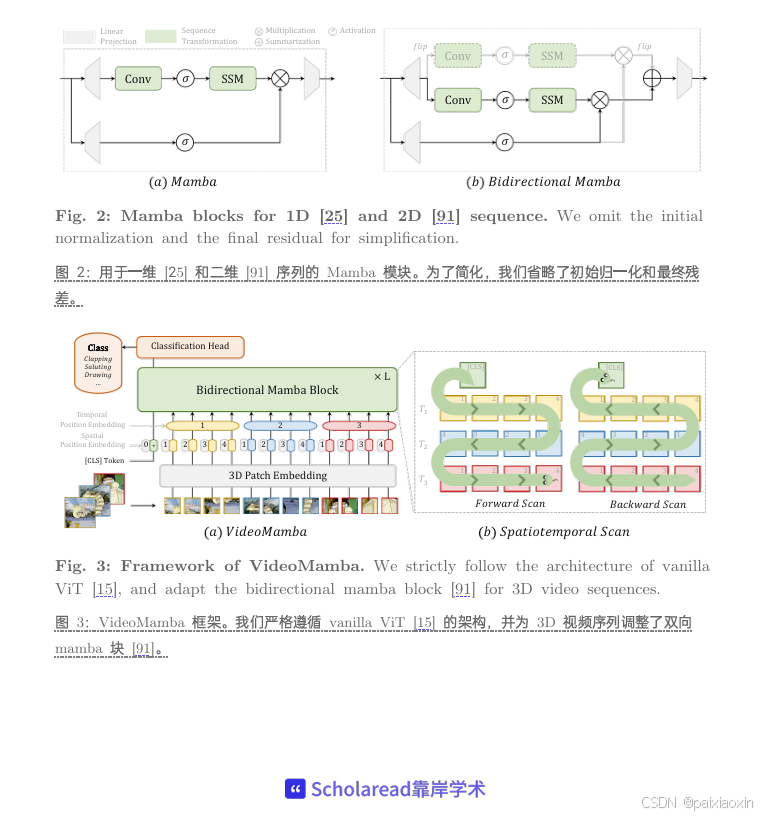
本文提出了VideoMamba,一种基于状态空间模型(SSM)的视频理解模型,旨在解决视频理解中的局部冗余和全局依赖问题。VideoMamba通过其线性复杂度算子,实现了高效的长期建模,这对于高分辨率长视频的理解至关重要。该模型在无需大量数据集预训练的情况下,展现了在视觉领域的可扩展性、对短期动作的敏感性、在长期视频理解中的优越性以及与其他模态的兼容性。广泛的评估表明,VideoMamba在处理短
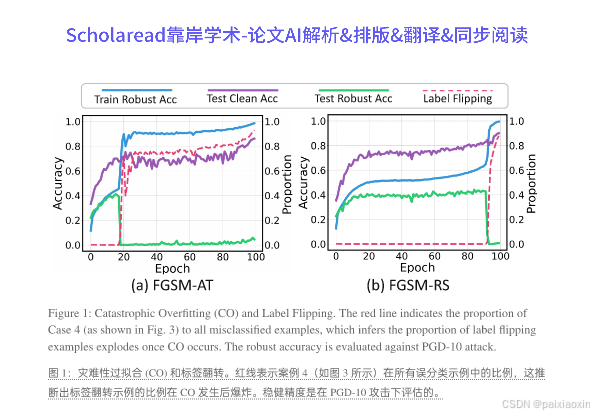
本文提出了一种新的对抗训练方法——基于分类的快速对抗训练(TDAT),旨在提高神经网络的鲁棒性并解决单步对抗训练中的灾难性过拟合(CO)问题。研究表明,CO的发生与对抗样本的分类有关,TDAT通过联合优化学习目标、损失函数和初始化方法,显著提升了神经网络的鲁棒性,减少了误分类样本的影响,并在训练过程中有效防止CO的发生。
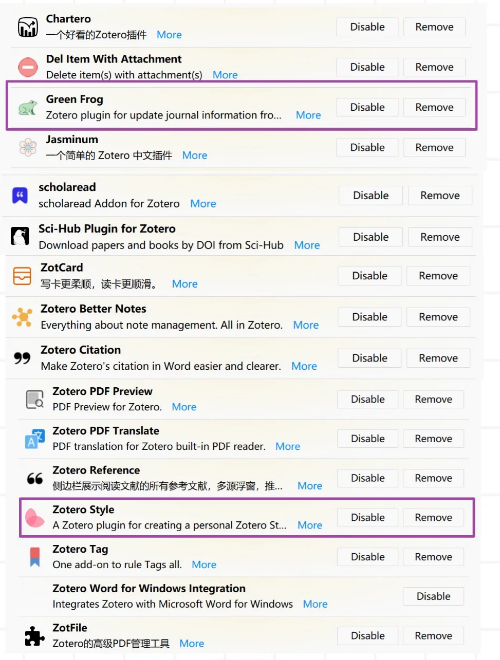
以下插件排序按照星标量进行排序,常用的插件大概是前20的样子,可以根据自己的需求进行插件的安装。顺带提一句,插件不是越多越好,装多了可能会出现软件卡顿的情况。插件版本:1.2.9一款手机、平板、电脑全平台同步阅读、翻译文献的工具,界面简洁直观,提供逐段对照的全文翻译,在遇到引用文献时还能直接查看摘要,一键添加到自己的阅读列表。可以直接从知网、谷歌学术等抓取参考文献信息,并下载pdf保存在zoter

以下插件排序按照星标量进行排序,常用的插件大概是前20的样子,可以根据自己的需求进行插件的安装。顺带提一句,插件不是越多越好,装多了可能会出现软件卡顿的情况。插件版本:1.2.9一款手机、平板、电脑全平台同步阅读、翻译文献的工具,界面简洁直观,提供逐段对照的全文翻译,在遇到引用文献时还能直接查看摘要,一键添加到自己的阅读列表。可以直接从知网、谷歌学术等抓取参考文献信息,并下载pdf保存在zoter
许多人在使用Zotero时,会选择Zotif插件来管理影响因子。然而由于Zotif插件经常存在问题,以及其配置和设置很复杂,今天就为大家介绍一种快速配置Zotero期刊标签和影响因子的方法。这个方法主要涉及到包括Zotero Style和小绿蛙(Green Frog)两个插件。通过这个方法,可以更便捷地管理文献哦~
本文介绍了一种名为 DeepCache 的新型训练无关范式,旨在加速扩散模型。DeepCache 通过利用扩散模型反向去噪过程中相邻步骤的固有时序冗余,缓存并检索跨相邻去噪阶段的特征,从而减少冗余计算。该方法利用 U-Net 的结构特性,在更新低级特征的同时重用高级特征,实现了显著的加速效果。实验表明,DeepCache 在不牺牲图像生成质量的前提下,显著提高了扩散模型的推理速度,并且优于现有的需

本文提出了一种新颖的双重扩散过程模型——残差去噪扩散模型(RDDM),该模型将传统的单去噪扩散过程分解为残差扩散和噪声扩散。RDDM通过引入残差,将原本不适用于图像恢复的去噪扩散模型扩展为一个统一且可解释的模型,适用于图像生成和恢复任务。具体来说,残差扩散表示从目标图像到退化输入图像的方向性扩散,而噪声扩散表示扩散过程中的随机扰动。RDDM能够有效地统一需要不同确定性或多样性要求的任务,如图像生成
本文介绍了一种名为InstanceDiffusion的图像生成模型,该模型能够在文本到图像的扩散模型中实现精确的实例级控制。InstanceDiffusion支持对每个实例进行自由形式的语言条件描述,并允许灵活地指定实例位置,如单点、涂鸦、边界框或复杂的实例分割掩码等。该模型通过三个主要改进来实现精确的实例级控制:UniFusion块、ScaleU块和多实例采样器。InstanceDiffusio