


- @mynameisgt


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
一般在论文的写作中,需要有算法流程图,现讲述两种伪代码算法流程图的实现:algorithm,algorithme2第一个:algorithm%导包\usepackage{algorithm}\usepackage{algorithmic}完整代码:\documentclass{article}\usepackage{algorithm}\usepackage{algorithmic}\begin{
你好,我是影子,曾先后在🐻、新能源、老铁就职,现在是一名AI研发工程师。目前新建了一个交流群,一个人走得快,一群人走得远,关注公众号后可获得个人微信,添加微信后备注“交流”入群。另外,本人长期维护一套飞书云文档笔记,涵盖后端、大数据系统化的面试资料,可私信免费获取。向量数据库,查询不同于传统的关系型数据库,执行相似性搜索而不是完全匹配。当给定一个向量作为查询时,向量数据库会返回与查询向量“相似”
由于数据没有null值,并且都是连续型数据,所以暂时不用对数据进行过多的处理,不够既然要建立模型,首先就要进行对housing分为训练集和测试集,取出了大概百分之20的数据作为测试集,剩下的百分之70为训练集。在选取的特征数量远小于第一个模型情况下,得分0.695,略小于第一个模型的0.7559。数据不存在相关性较小的属性,也不用担心共线性,故我们可以用线性回归模型去预测。试使用相关性最高的3个特
文章目录一、Kerberos概述1.kerberos简介2.Kerberos术语3.Kerberos认证原理二、Kerberos安装1.安装Kerberos相关服务2.修改配置文件3.初始化KDC数据库4.修改管理权限配置文件5.启动Kerberos相关服务6.创建Kerberos管理员用户三、Kerberos数据库操作1.登录数据库2.创建Kerberos主体3.修改主体密码4.删除Kerber
在下面的BiRNN类中,虽然文本序列的每个词元经由嵌入层(self.embedding)获得其单独的预训练GloVe表示,但是整个序列由双向循环神经(self.encoder)编码。我们将使用预训练的Glove模型来表示每个词元,并将这些词元表示送入多层双向循环神经网络以获得文本序列表示,该文本序列表示将被转换为情感分析输出,对于相同的下游应用,我们将考虑不同的架构选择。我们使用这些预训练的词向量
问题情况:解决方案:下载一个修复工具,这里附上修复工具链接:链接:https://pan.baidu.com/s/1HxKLkd0NIgiQ5x1_BaI0_Q提取码:p1a81.下载工具后解压,2.以管理员身份运行DirectX Repair.exe文件3.工具=>选项=>扩展 | 点击开始扩展4.工具=>选项=>高级 | 点击确定5.回到主页|点击检测并修复6.此时就消
由于情感可以被分类为离散的极性或尺度(例如,积极的和消极的),我们可以将情感分析看作一项文本分类任务,它将可变长度的文本序列转换为固定长度的文本类别。在这两个数据集中,“积极”和“消极”标签的数量相同,表示不同情感积极性。情感分析(sentiment analysis)研究人民在文本中(如产品评论、博客评论和论坛讨论等)“隐藏”的情绪。正如我们所料,评论的长度各布不相同,为了每次处理小批量这样的评
飞书原文档链接地址:https://ik3te1knhq.feishu.cn/wiki/D8kSwC9tFi61CMkRdd8cMxNTnpg。
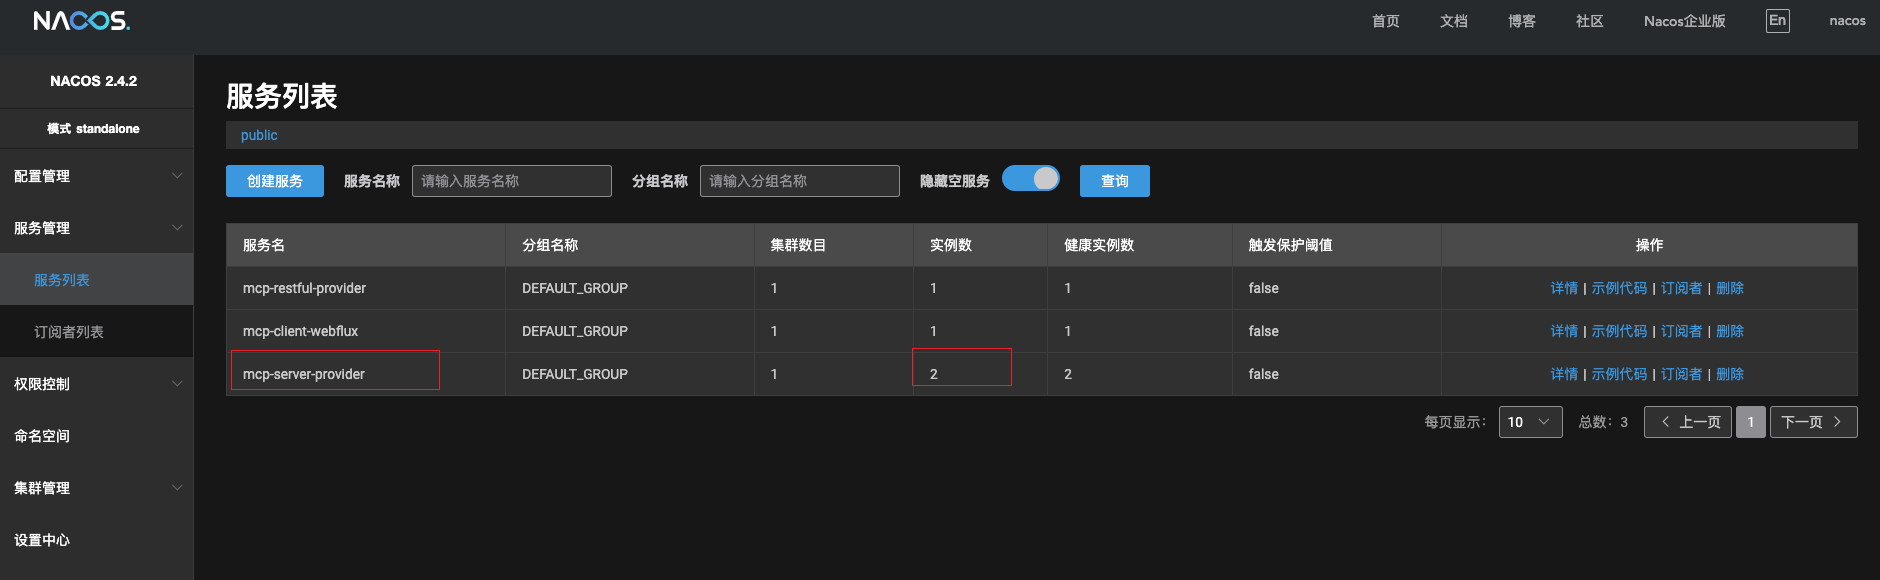
原文链接:Spring Ai Alibaba Graph:多节点并行—快速上手说明:本教程将采用2025年5月20日正式的GA版,给出如下内容版本:JDK21 + SpringBoot3.4.5 + SpringAI 1.0.0 + SpringAI Alibaba 1.0.0.2将陆续完成如下章节教程。本章是第十章(Graph构建智能体)下的Grpah节点并行—快速上手代码开源如下:https:
原文链接:Spring Ai Alibaba Graph 快速入门说明:本教程将采用2025年5月20日正式的GA版,给出如下内容版本:JDK21 + SpringBoot3.4.5 + SpringAI 1.0.0 + SpringAI Alibaba 1.0.0.2将陆续完成如下章节教程。本章是第十章(Graph构建智能体)下的Graph快速入门代码开源如下:https://github.co