- @m0_63947499


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
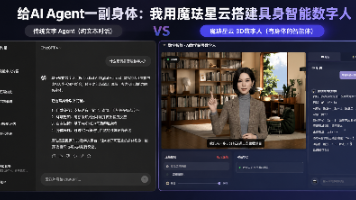
所有Agent都在卷"脑子",我开始思考——如果AI有一副身体,交互会变成什么样?
机器人可以用灯光反馈状态,例如用颜色区分等待和处理中。T1 Pro 的 SDK 提供两类相关接口:颈灯状态用于读取开关和亮度,LED 灯带服务用于选择灯效。弄清二者区别,才能知道应该订阅什么、调用什么。这篇从真实接口检查开始,再用四种装饰灯效做离线参数预演,最后展示有明确确认条件的调用入口。即使暂时没有机会操作机器人,也能先把程序跑通。

对机器人说一句“查询电量”,语音识别(ASR)先把听到的话变成文字,程序再按文本挑选业务功能。麻烦在于,识别结果是一条一条送来的。你可能先收到“查询电”,过一会儿才收到完整的“查询电量”,同一句话还可能重复送达。要是不加判断,来一条处理一条,同一次电量查询就会被执行好几遍。这篇文章就用 T1 Pro 的 SDK 写一个ASR 消息过滤器,只认最终文本,去掉重复结果,再检查置信度,最后做整句指令匹配

亮数据官号会持续更新产品介绍和技术实践,感兴趣的读者可以关注:https://brightdata.blog.csdn.net/https://www.bright.cn/products/datasets?utm_source=brand&utm_campaign=brnd-mkt_cn_csdn_qing202611

让机器人"听懂人话"这件事,我的第一反应是写一个规则引擎:把"挥挥手"“跳个舞"这些句子枚举进一张配置表,命中就调接口,没命中就回复"我不明白”。这个思路在演示里跑得通,规模一大就露馅:指令组合无穷、口语千变万化,规则表永远追不上用户的嘴。

两万块买回来的机器人,你会得到一个包装箱、一份说明书。但很多人不知道,机器人出厂时还自带另一份"自我介绍":一个记事本就能打开的文本文件。里面没有一张照片,全是数字和标签,却把这台机器人描述得清清楚楚:有哪些骨头、骨头之间怎么连接、每块多重、关节能弯到什么程度、碰撞时按什么形状计算。

拆开一台人形机器人,你会看到两块计算板、二十二个关节电机和一堆传感器——但软件上"谁管谁"这件事,官方参数页不会告诉你。Q1 的答案很有意思:它把机器人的"大脑"**物理上分成了两半**。管运动的叫运控板(文档里也称呼它"小脑板"),管思考的叫大脑板;而开发者自己那台电脑,是正式架构图里的第三个节点。三台设备没有主从服务器,靠一根局域网里的 FastDDS 总线平权互联。

千问六大AI套件,包括悬浮球、快捷框、划词、截屏、读屏和侧边栏,在任何场景下均可一键唤起千问能力,实现"边浏览边对话"的交互体验,上千万学生都在用它提高效率。别问我怎么知道的,问就是过来人。打开夸克,选择首页的“夸克PPT”,直接把你的文献综述文档(word、PDF、甚至脑图格式都支持)上传上去。你要是已有PPT初稿,可以选择夸克的“美化PPT”功能,各种风格的模板可选,潦草空白的PPT立马变得有
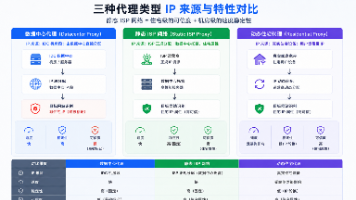
静态 ISP 代理是一种特殊的代理类型——IP 由正规互联网服务提供商分配,但托管于数据中心,兼顾了住宅 IP 的可信度和数据中心的速度。本文围绕 Dataify 静态 ISP 独享代理,设计了多线程并发压力测试、多目标站点可达性验证、反检测能力对比实验三组实测方案,并给出 SEO 关键词分析、电商价格监控两个业务场景的完整接入代码,供有高并发、高可信度需求的开发者参考。Dataify 官方地址D
做 Agent 的都知道,让大模型读文档,第一步是"把纸变成字"。这一步看起来很简单——OCR 发展了二十年,字符识别率早就过了 95%。但是当你拿到一张真实的财务底稿:合并单元格里藏着父子隶属关系,跨页长表的续接信号弱得像页脚的水印,嵌套表格里套着另一张子表——OCR 把每个字都认对了,但输出的字符串像被洗牌机搅过,列对不上、行挂错、表头飘到了正文里。Agent 拿到这堆"无主数字",引用时错得