


- @hlABgYML


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
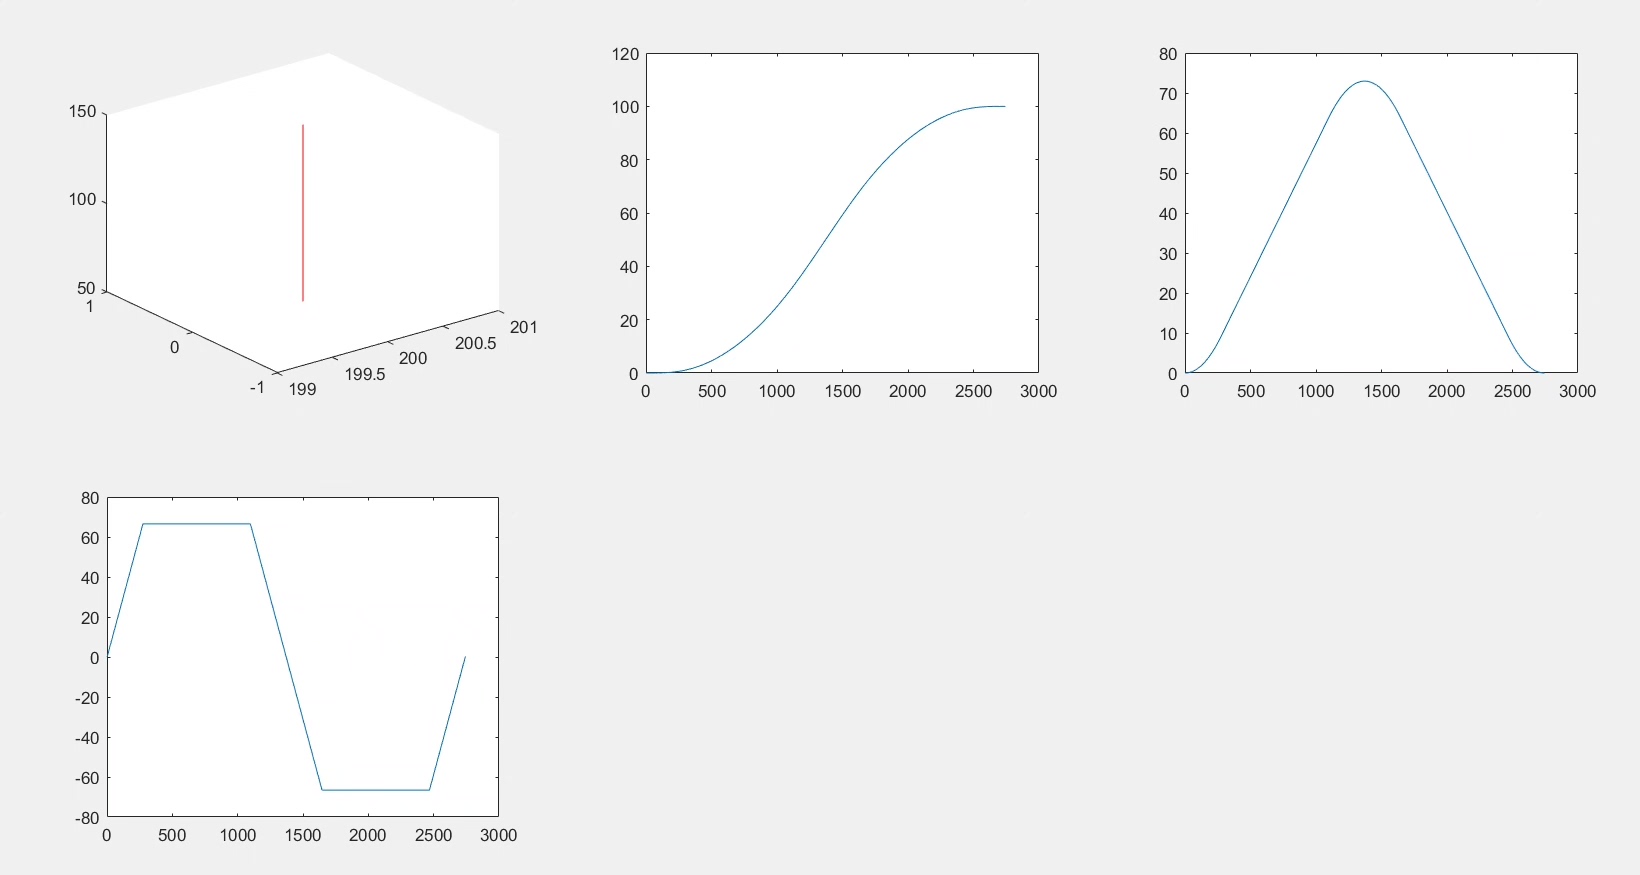
通过将简单的几何路径叠加和S形速度曲线结合起来,我们可以实现一种灵活且平滑的机器人路径规划方法。这种方法不仅适用于涂胶场景,也可以扩展到其他需要精确轨迹控制的应用中。希望这些代码和分析能够帮助大家更好地理解路径规划的基本概念和实现方法!
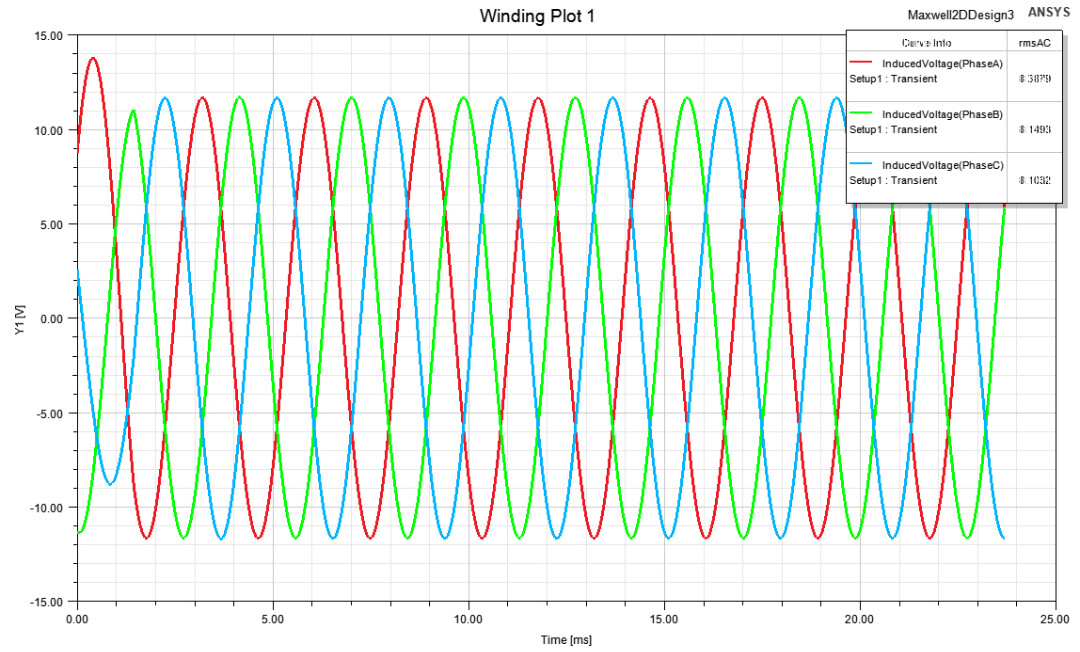
12V直流母线拉750W PMSM/BLDC双模式还能跑3000转出1Nm转矩,这功率密度真的有点东西——14极12槽内转子经典搭子,外径才76mm轴向56.7mm,MAXWELL全链路验证熟门熟路,连齿槽转矩优化都是新手能看懂的辅助槽,转子更绝:没那复杂的分段斜极或者V形倾斜永磁体,就是简单的圆弧形瓦片插槽,CNC车一刀槽位都能搞定的程度,直接能甩去工厂打样投产。先提新手怎么找辅助槽的位置尺寸:
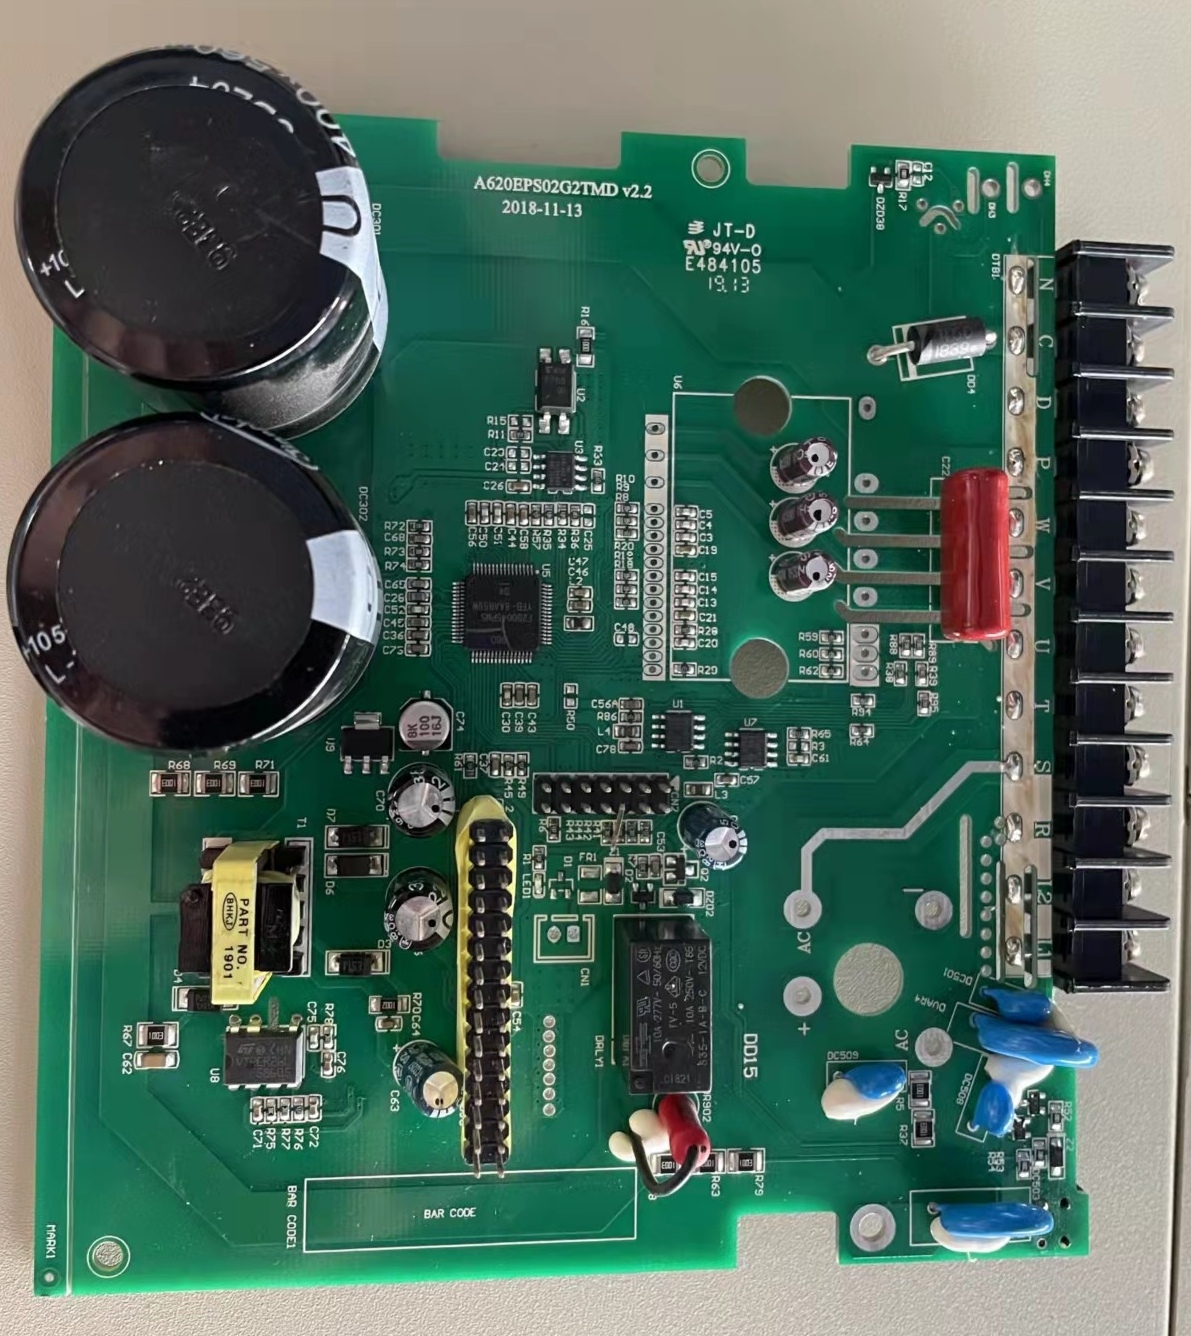
超低成本伺服方案,TI最新TMS320F280045+lattice的FPGA XO2架构,支持2500线和17位多摩川总线编码器,电路非常简单,400W和750W的成本在200多,非常合适成本非常敏感的专机应用场合,比如纺织,机械手等行业。超低成本伺服方案,TI最新TMS320F280045+lattice的FPGA XO2架构,支持2500线和17位多摩川总线编码器,电路非常简单,400W和7
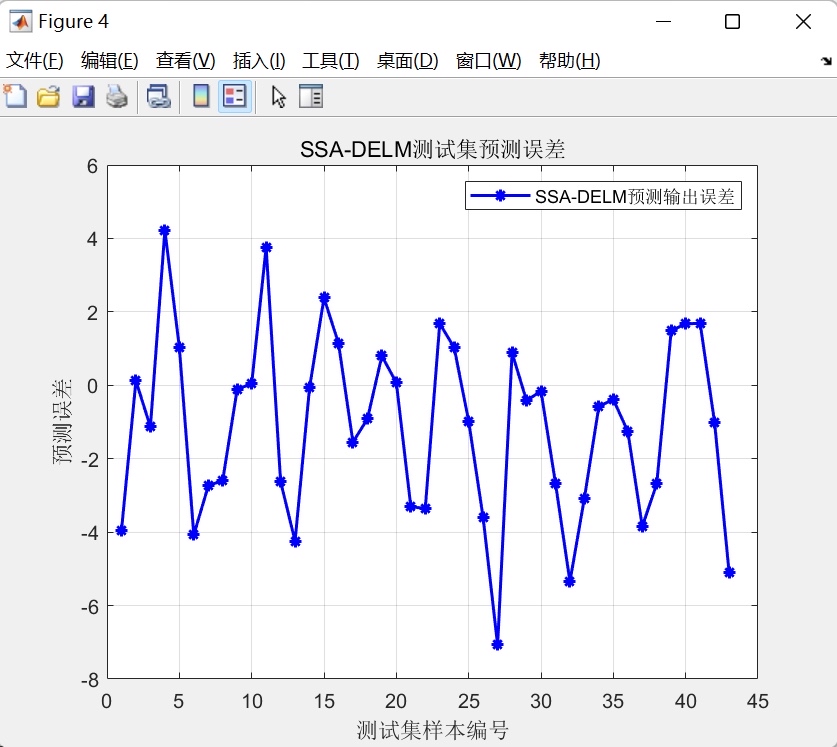
麻雀优化算法是一种群智能优化算法,灵感来源于麻雀的觅食行为。它主要包括觅食(探索)、报警(避免危险)和跟随(学习邻居)三个主要行为。简单来说,麻雀会根据当前食物的丰裕程度调整自己的觅食策略,同时还会警惕周围的危险,保持群体的安全。这些行为被模型化之后,可以用来解决各种优化问题。参数少,实现简单。适用于复杂非线性优化问题。具有较强的全局搜索能力。深度学习机(DELM)是一种基于多层感知机(MLP)的
基于边缘计算的资源卸载群智能优化算法定做,算法设计在当今数字化飞速发展的时代,数据量呈爆炸式增长,设备对于资源的需求也日益迫切。边缘计算作为一种新兴的计算模式,正逐渐崭露头角,为解决资源紧张问题提供了新思路。而在边缘计算的诸多应用场景中,资源卸载是关键环节,它能将设备上一些计算密集型或存储密集型的任务转移到边缘服务器上执行,以此提升设备的运行效率和性能。

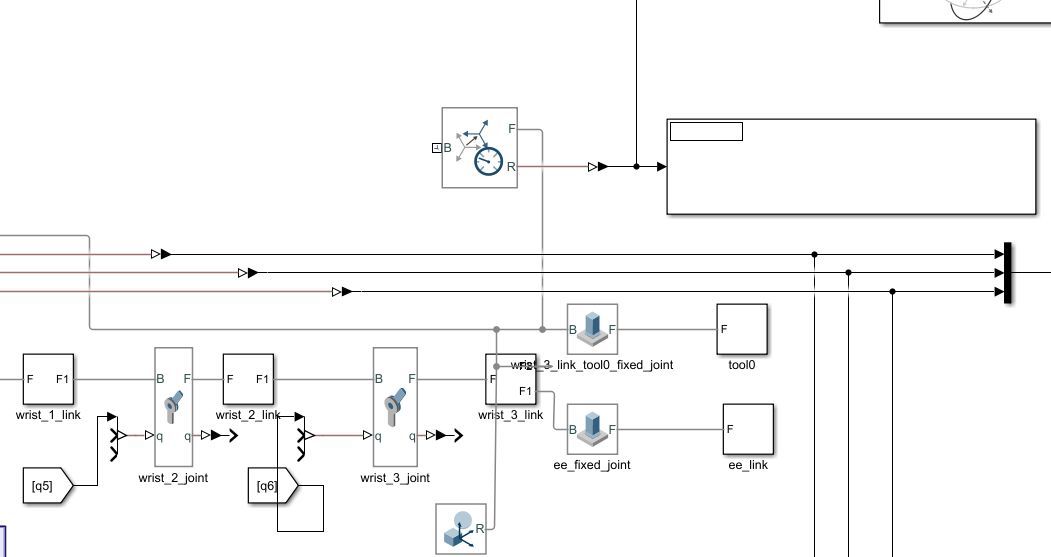
在Simulink里搭建物理模型时,记得在Configuration Parameters里把Solver选成ode15s——刚性系统专用求解器,否则仿真速度能让你等到怀疑人生。先来张全家福:Simulink搭建物理模型,机器人工具箱负责算法验证,Simscape实现多体动力学——这组合拳打起来是真香。仿真时发现个有趣现象:同样的轨迹规划,在理想模型和物理模型中的关节扭矩能差出20%。注意每次逆解
充电站位置规划221.建立了混合整数编程(MIP)模型。对于农村来说,交通网络并不像他们的城市同行那样强大。充电站可以辐射到应考虑的周围区域,因此纸张使用加权Vorinor图模型(WVDM)来分析该方面。对于城市的充电站,考虑了交通流量的效果。同时,引入排队理论以计算驱动程序的平均等待时间。对于乡村,本文还考虑了建筑成本,并提供了充电桩的计算公式。最后,将目标编程设置为解决充电站的最佳分布,具有最

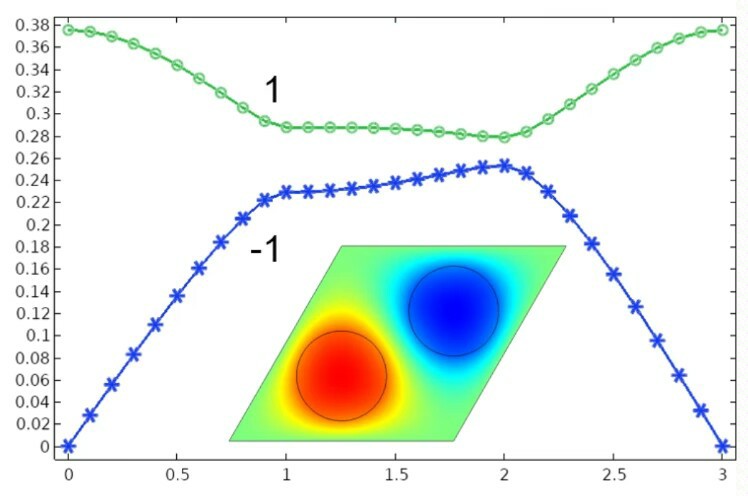
蜂窝晶格光子晶体的拓扑性质最近在光学领域火得不行,但计算陈数这事儿总让新手头疼。先别急着打开软件,记住核心逻辑:陈数就是Berry曲率在整个布里渊区的积分,而光子晶体要实现非零陈数,结构必须打破时间反演对称性。别慌,这是网格不够密的正常现象。最后记得验证时间反演对称性——把磁场方向反转,陈数符号应该翻转,这才是真·拓扑非平庸的实锤。这里braket函数得处理规范自由度,建议用⟨u|v⟩/|⟨u|v
比如在Keil里要把APP区域的起始地址设置为0x8004000(假设Bootloader占16KB),同时中断向量表偏移量要和SCB->VTOR设置一致。不过要注意,不同型号的掩码值可能需要调整,别直接抄作业。今天咱们来盘一盘GD32F3的串口IAP实现,手把手教你让设备自己完成空中升级。比如115200波特率下,256字节一包大约要22ms发送时间,得确保设备端接收缓冲区足够大。不过要注意静态

完整代码里还包含了步长变化曲线绘制模块,能看到那个Sigmoid函数是怎么动态调节的——这可能是变步长算法最性感的时刻,看着步长随着误差起伏就像看心电图似的。传统LMS步长固定,收敛速度和稳态误差总要取舍,这个可变步长的版本倒是能动态调整。下次试试把信道改成时变的,应该能看到变步长更大的优势,不过那就是另一个故事了。您看到的介绍及图片即为本程序实现的功能,程序经过我自己电脑的测试,确保能实现相应的
