


- @happycao123


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Flink是一个开源的流处理和批处理框架,它能够处理无界和有界的数据流,具有高吞吐量、低延迟和容错性等特点实时数据处理、数据分析、机器学习、事件驱动等。流处理是一种针对实时数据流进行连续处理的技术。它的数据通常是无界,数据以持续不断的流的形式到达。批处理是一种将大量数据集合在一起进行统一处理的技术。在批处理中,首先要收集存储数据,批处理通常用于处理历史数据或离线数据。
本期主要聊聊kafka消费者组与分区。
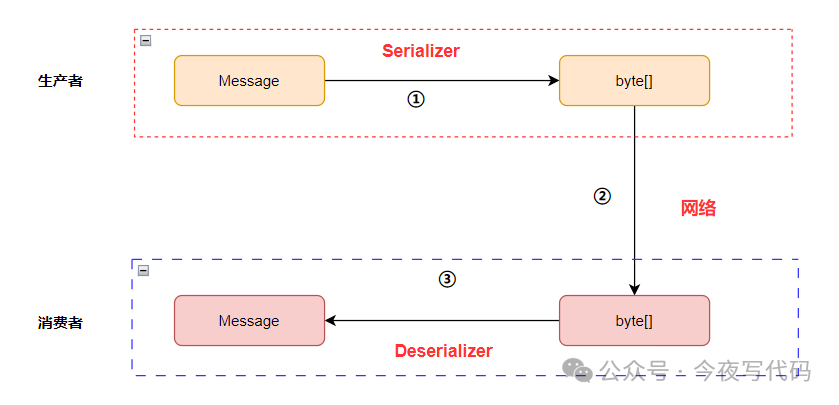
自定义序列化器 只需要实现对应的 Serializer,UserDeserializer比如有一个 User 类@Data@Override@Override@Override@Override生产者与消费者配置...上面我们配置了 User 相关的序列化,但是实际上项目发送的消息内容肯定不止 User 这一种,我们需要针对不同类型指定不同的序列化方式本文主要介绍了自定义序列化方式,以及为不同类型
有些发送异常可以通过重试几次后解决,比如网络异常,对于有些异常比如消息太大超出kafka配置的最大消息字节数,这类异常重试也会失败,所以这类异常KafkaProducer 不会进行任何重试。有没有办法既要异步发送还要能处理发送失败的场景,这就是第三种,发送完成时,执行相应的回调方法。:等待发送结果返回,这种方式是可靠的,因为异常能及时处理,但同步发送需要阻塞等待一条消息发送完才处理下一条,吞吐量差
本文主要介绍了分布式链路追踪主要思想,以及Spring Cloud Slueth + Zipkin集成实现分布式链路追踪,当然本文只是入门级教程,不涉及Slueth原理相关,文中给的例子仅仅只是Demo,实际项目中,启动类与Controller 类职责要严格区分,不能混在一起,更多Demo 可以查看官网。
