


- @feifeikon


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在机器学习中,有一些算法通过常被称为弱模型,这里所说的“弱模型”指的是像决策树这样简单的基本模型,也指的是那些精度相对较差的模型,也就是比随机模型好那么一点点的模型。先来思考一个问题:是否可以从大量相对较弱和简单的模型中通过某种手段而得到一个强大的模型?正如你想的一样,这个问题的答案显然是肯定的。集成方法就是其中的一类,集成学习的算法有很多,先从最简单的开始:AdaBoost。AdaBoost 采
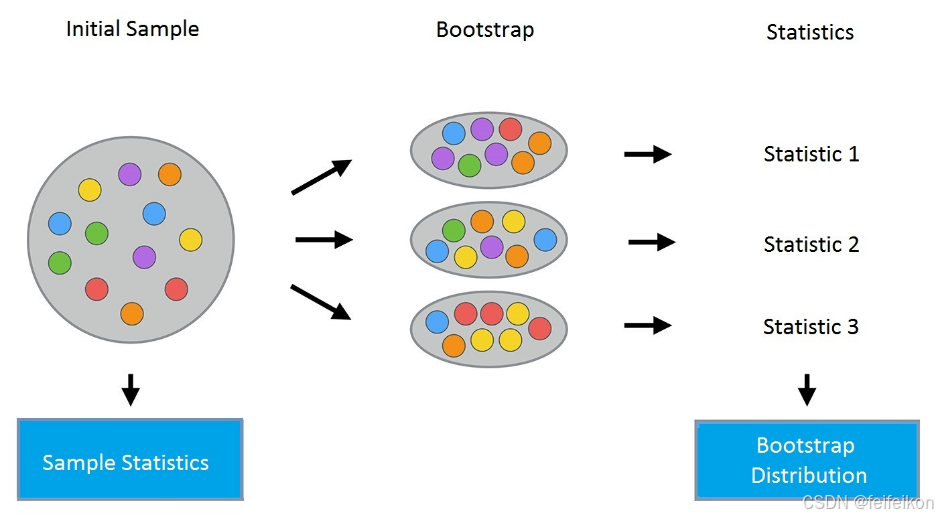
本文通过特征提取、特征转换、特征选择三个过程介绍数据预处理方法,特征提取将原始数据转换为适合建模的特征,特征转换将数据进行变换以提高算法的准确性,特征选择用来删除无用的特征。

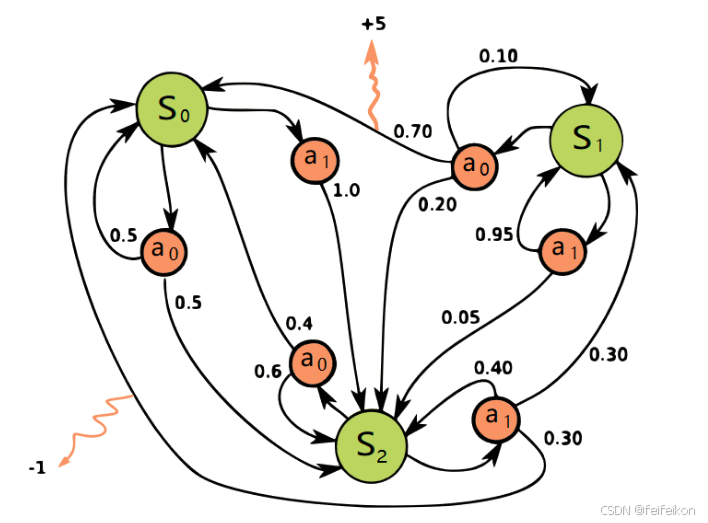
通过上文,我们已经知道不同状态出现的概率不一样(比如今天是晴天,那明天是晴天,还是雨天、阴天不一定),同一状态下执行不同动作的概率也不一样(比如即便在天气预报预测明天大概率是天晴的情况下,你大概率不会带伞,但依然不排除你可能会防止突然下雨而带伞)如下图所示,这个决策过程可视化了状态之间的转移以及采取的动作。且通过状态转移概率分布,我们可以揭示状态价值函数和动作价值函数之间的联系了。是奖励的集合)的
NLP发展史NLP发展脉络简要梳理如下:2001 - Neural language models(神经语言模型)2008 - Multi-task learning(多任务学习)2013 - Word embeddings(词嵌入)2013 - Neural networks for NLP(NLP神经网络)2015 - Attention(注意力机制)2015 - Memory-based n

GRPO的核心思想是通过组内相对奖励来优化策略模型,而不是依赖传统的批评模型(critic model)。具体来说,GRPO会在每个状态下采样一组动作,然后根据这些动作的相对表现来调整策略,而不是依赖一个单独的价值网络来估计每个动作的价值。这种方法的优势在于:减少计算负担:通过避免维护一个与策略模型大小相当的价值网络,GRPO显著降低了训练过程中的内存占用和计算代价。提高训练稳定性:GRPO通过组
一般来说,LoRA微调会集中在以下层:Attention层的查询、键、值和输出投影(q_proj, k_proj, v_proj, o_proj)
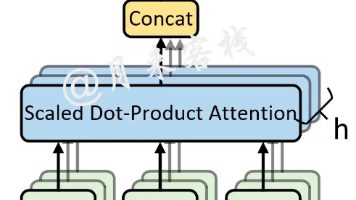
经过上面内容的介绍,我们算是在一定程度上对于自注意力机制有了清晰的认识,不过在上面我们也提到了自注意力机制的缺陷就是:**模型在对当前位置的信息进行编码时,会过度的将注意力集中于自身的位置,**因此作者提出了通过多头注意力机制来解决这一问题。同时,使用多头注意力机制还能够给予注意力层的输出包含有不同子空间中的编码表示信息,从而增强模型的表达能力。如图7所示,可以看到所谓的多头注意力机制其实就是将原
在进行Self - Attention之前,我们首先定义3个1×4的input。x = [
如HMM学习最佳范例中所说,有一类现象是确定性的现象,比如红绿灯系统,红灯之后一定是红黄、接着绿灯、黄灯,最后又红灯,每一个状态之间的变化是确定的。

钢材表面缺陷检测在钢铁生产中是确保质量的关键环节,传统的人工检测方式难以满足大 规模工业生产的需求。近年来,基于深度学习的缺陷检测方法因其高效性和准确性受到广泛关 注。然而,现有的深度学习模型如U-Net虽具备较好的分割性能,但由于参数量大、计算复杂 度高,限制了其在实际生产环境中的应用。为此,本文提出了一种基于轻量级U-Net的改进模 型,用于钢材表面缺陷检测。
