


- @crazyjinks


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
First of first,你要知道指令集(instruction set)是一个什么东西,指令集是计算机硬件和软件之间的桥梁,它定义了处理器可以执行的基本操作,操作系统和应用软件必须根据指令集来编写,才能在特定的处理器上运行。
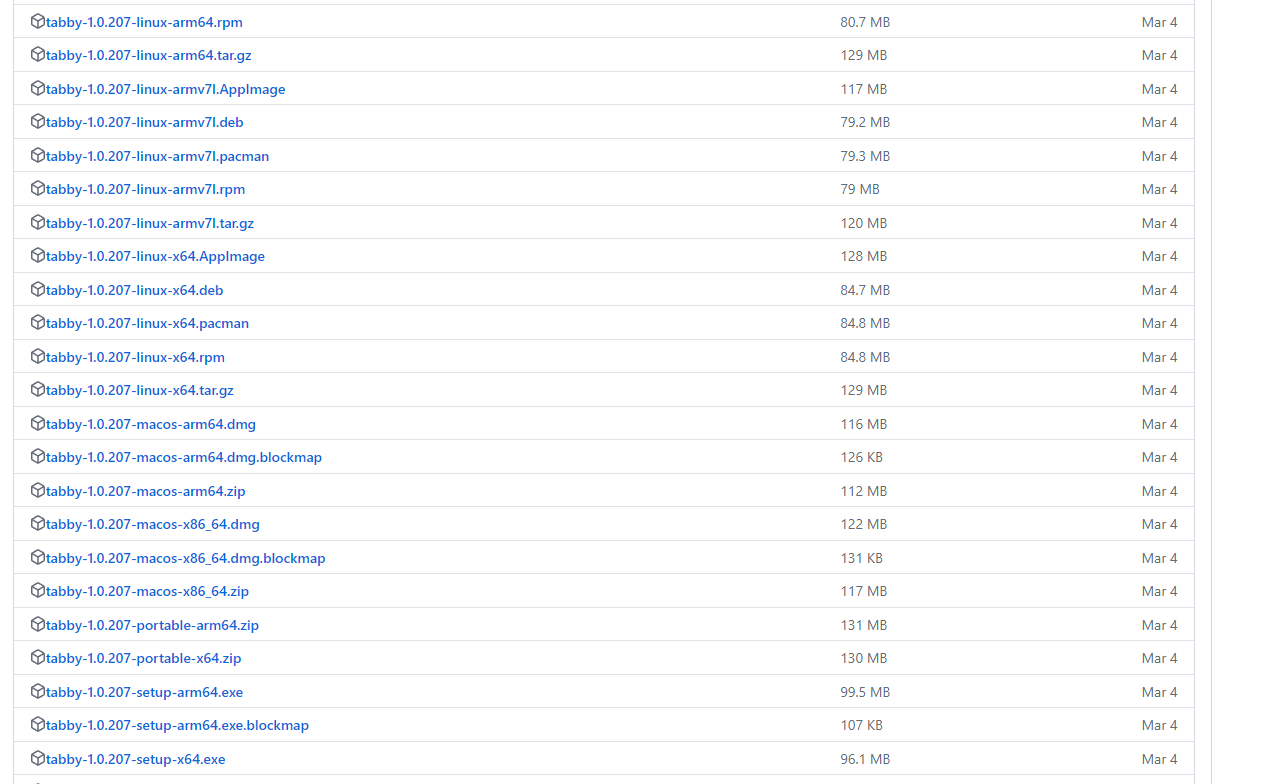
在Word中,插入的表格默认情况下,第一行不会被自动识别为标题行。要让Word中的表格跨页正常显示标题行,你可以按照以下步骤进行操作。
uname -i。

首先我们先理解几个基础概念,GPU驱动,CUDA,和镜像。nvidia-smi输出中的和字段。。根据你的 GPU 型号查询对应的最新驱动。查看系统/容器是否安装了 CUDA Toolkit (及nvccnvcc -V如果命令执行成功并显示版本信息,则表示已安装。print(torch.version.cuda) # 显示 PyTorch 链接的 CUDA 运行时版本或。
Overlay Mesh VPN 与反向代理不是竞品,是不同抽象层:frp 暴露「服务」,Headscale/Tailscale 组建「网络」。机器人舰队运维要的是后者。一句话记住控制面/数据面分离:Headscale 只做介绍人,∼90\sim 90\%∼90%的流量根本不经过你的服务器,所以一台 2C2G 小云主机能撑起上百台设备。能否 P2P 的判据是 NAT 的映射行为,而不是「有没有公网
选择合适的显卡部署大模型是一个需要综合考量的决策。核心原则是:明确需求场景,理解硬件特性,计算真实成本。不要被单一参数(如显存大小或理论算力)误导,也不要忽视功耗、稳定性、扩展性等"软性"因素。A10适合推理但不适合训练,A100的40GB和80GB版本差异主要在带宽和容量而非算力,消费级显卡虽然性价比高但有功耗和稳定性隐患——理解这些细节,才能做出真正符合需求的选择。希望本文能帮助你在大模型部署
词元(Token),是大语言模型处理文本的最小单位。AI 不认识"文字",它只认识"编号"。而词元就是文字在变成编号之前,被切分出来的那个"碎片"。要点一句话说明1词元是什么大模型处理信息的最小单位,不等于字,不等于词2词元怎么来的由分词器(Tokenizer)按照训练好的规则把文本切分而成3词元 ID 是什么每个词元在模型词表(词典)中的唯一编号,模型实际处理的就是这些 ID4为什么不按字/词切
把以上所有内容串起来,你需要记住的核心知识是这样的:打印的本质是格式转换。你的应用产生 PDF,打印机需要自己的"母语"(PostScript、PCL、SPL 等),CUPS 通过过滤器链完成这个转换。PPD 文件是这条链的"配方",它精确描述了打印机的能力和需要什么过滤器。专用驱动(如 ULD)提供了精确的 PPD 和正确的过滤器,所以排版精确。通用驱动使用通用的 PPD 和过滤器,对简单内容可
第一,模型是"石化"的。训练完成后能力就固定了,它不会进化、不会记忆、也不会自己调用任何程序,本质只是"文字进,文字出"。第二,它靠概率抽签。同样的输入之所以有不同输出,是因为它从一张固定的概率表里随机选词,温度控制随机的大小。第三,上下文就是它的全部世界。它就像一个大小固定的 U 盘,你们所有的交流都在里面进行。你放进去什么,直接决定它算出什么。所以,想要好的输出,先给出好的输入。