


- @cjzjolly


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
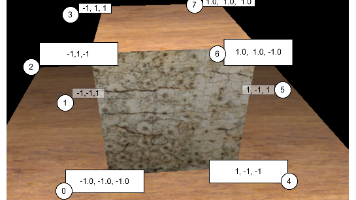
最近逛shadertoy看到有人把透视转换、光照、3D转2D光栅化转移到了fragShader实现,虽然感觉没啥实用性,过于麻烦,但觉得非常厉害又有趣,让我感觉看到了新鲜事物一样。拜读之后对他的代码有了一点个人理解,写一个笔记记录一下。
最近在学习JavaFX PC端软件开发,在Linux上显示一切正常,打算周末在macbook上接着实践时,发现UI跑起来却成了这样的一团乱码:部分UI出现了乱码。立即Google查找问题的解决方法,发现很多都是从文件编码格式之类的入手,然而我很确定我的文件编码方式是正确,这显然并不是我所出现的问题的解决办法。再看IDE是否有有意义的提示,果然发现了这么一个警告:2021-12-04 11:17:4
本文用于在无法获取压感的设备上实现书法效果,因此所有的书写效果的笔触粗细变化,均是通过速率进行确认。最后实现效果如下(不会书法,只能让大家体会一下效果),代码基于之前的文章https://blog.csdn.net/cjzjolly/article/details/88661286上进行修改而成:一、推导:在正常的情况下,使用Canvas和Path分段绘制用户的书写结果时...
为了方便一些对时间不敏感的大数据块的存放,尤其是在JNI环境中避免系统OOM,我打算给予MMAP做一套虚拟内存工具:首先来想一下申请连续块时的各种情况,方便编写仿malloc函数,各种增删情况如图:每个块开头用一个long来保存块总大小,寻找空间时见到这个标记即可立即跳过相应区域,如果有多个空间块则会因为连续踩到块大小标记产生连续跳跃,而当没有踩到该标记时——即内容为0时,逐地址遍历是否满足空间要
为了方便一些对时间不敏感的大数据块的存放,尤其是在JNI环境中避免系统OOM,我打算给予MMAP做一套虚拟内存工具:首先来想一下申请连续块时的各种情况,方便编写仿malloc函数,各种增删情况如图:每个块开头用一个long来保存块总大小,寻找空间时见到这个标记即可立即跳过相应区域,如果有多个空间块则会因为连续踩到块大小标记产生连续跳跃,而当没有踩到该标记时——即内容为0时,逐地址遍历是否满足空间要
偶尔会听到别人说,计算机的计算速度比人快多了,人连两位数乘法都要想半天,机器一瞬间就出来了。我觉得这个算法有失偏颇。首先,人脑在信息传递方面确实非常慢,比较快的神经冲动也大概只有不到3m/s,远无法和电场的传递速度相比。但人脑的带宽确实计算机无法比拟的,每个神经细胞都在做并行运算,所以总体算力上不算低,只是反应比较慢。我还可以再举一个人脑算力不低的例子,计算机呈现一个3D的图形,每个最终要被投射到
摘要:本文针对人脸识别工程中图像处理逻辑导致的严重功耗问题进行分析与优化。原方案存在NV21转JPEG再转Bitmap的低效流程,以及不必要的图像旋转操作。通过引入libyuv库在JNI层直接处理YUV到RGB的转换,并优化坐标转换算法,将640*480图像的转换时间从100ms降至2ms内,显著降低了CPU占用和功耗。关键改进包括:1)使用JNI直接处理Image对象;2)利用libyuv高效转
在写这个demo的过程中,除了最核心的shader是自己写之外,大部分代码片段都是AI帮忙直接生成,比以往实现类似难度的demo时间少了三分之一。尽管AI生成的代码有一些问题,我需要review通读后进行修改,也依然大幅度提高了效率,我在这个过程中感觉自己的作用更多的是在AI无法处理好的事情上,理解途中发生了什么,然后再用自己的知识、能力和经验解决,而假如我没有这些技能的话,AI输出的代码出了问题
感谢周志华先生写的《机器学习》这本书,还有网上的资源,使得我勉强能理解简单的人工神经网络的实现方法,觉得自己在这方面真是弱爆了。先贴一下BP神经网络的实现代码:package com.test.bpNeuronNetworkVer2;/*** Created by cjz on 2018/12/19.*/import java.io.File;import java.i...
Win10和11 git/Android Studio遇到filename too long问题的解决。
