


- @WenW1217


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
与Word无缝集成(自动插入/更新引文和参考文献列表);支持跨平台(Windows/macOS/iPad)及云端同步(EndNote Web);提供“期刊匹配”“AI 提取要点”等高级功能(EndNote 2025版);中文数据库(如知网)直连支持弱于国产工具(如NoteExpress)。。
在预测时,每个模型都对样本进行预测,得到 N(N-1)/2 个预测结果。然而,它可能会受到类别不平衡问题的影响,因为每个模型的样本分布可能不同。OvO 策略需要训练更多的模型,但它对于类别不平衡的情况更加稳健,因为每个模型只关注两个类别,样本分布相对平衡。在预测时,对于一个新样本,每个模型都会给出一个预测概率或类别标签。在预测速度上,OvR 策略需要计算所有模型的预测结果,而 OvO 策略只需要计
如下图,假设一共有 100 个样本,其中 90 个是正常未患病的人,10 个是患病的人,现在模型预测出 12 个患病的人,88 个未患病的人。是一个常见的机器学习任务,有许多指标来衡量二分类模型的性能,本文将从疾病预测的场景开始,分别介绍二分类的基础指标和综合指标,并进行对比。预测患病的人中,8 人真正患病(真阳性),4 人并未患病(假阳性)。预测未患病的人中,86 人未患病(真阴性),4 人患病

不同的阈值会导致分类结果的变化,当阈值较低时,模型更容易将样本判定为正例,这可能会提高召回率,但精确率可能会降低。相反,当阈值较高时,模型更谨慎地将样本判定为正例,这可能会提高精确率,但召回率可能会降低。精确率的目标是尽可能地减少将负样本错误的预测为正样本的情况,即减少**假阳性**的数量。在疾病预测的例子中,精确率表示模型能够将样本正确预测为患病的能力。F1 分数的取值范围为 0 到 1,其中分

在预测时,每个模型都对样本进行预测,得到 N(N-1)/2 个预测结果。然而,它可能会受到类别不平衡问题的影响,因为每个模型的样本分布可能不同。OvO 策略需要训练更多的模型,但它对于类别不平衡的情况更加稳健,因为每个模型只关注两个类别,样本分布相对平衡。在预测时,对于一个新样本,每个模型都会给出一个预测概率或类别标签。在预测速度上,OvR 策略需要计算所有模型的预测结果,而 OvO 策略只需要计
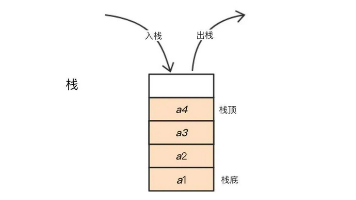
当我们浏览网页时,每次点击链接都会将新的页面加入到栈中,而当我们点击 “返回” 按钮时,就会将栈顶的页面弹出,这样就可以回到之前的页面了。队列的本质也是一个容器,它可以存储任何类型的数据,但是队列的大小也是固定的。栈的基本操作有两个,即入栈和出栈。栈的本质是一个容器,它可以存储任何类型的数据,但是栈的大小是固定的,因为它的元素只能在栈顶添加或删除。当一个进程需要运行时,就将它加入到队列的队尾,当操
我们发现,节点 还存在未被遍历的边( 和 ),因此我们从节点 出发,重复步骤 1。将结果序列中的一个 换成这个回路,此时的结果序列即为 ,而图也变成了下面的样子。将结果序列中的一个 换成这个回路,此时的结果序列即为 ,而图也变成了下面的样子。我们通过反证法简要说明一下,为什么步骤 1 中,如果遇到一个节点 不存在未被删除的边(即节点 的度数为 ),那么该节点必然是出发点。首先,假设 ,那么在遍历过
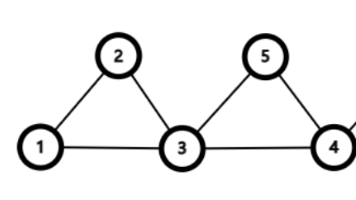
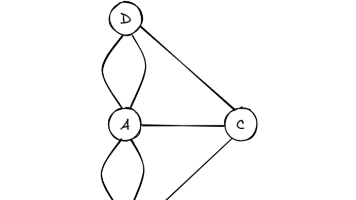
同样地,对于起点而言,离开起点需要“消耗”一条边,而回到起点需要“消耗”另一条边。因此,该节点的度数(连接该节点的边的数量,若一条边的两端是同一个节点则需计算两次)必须为偶数,才能保证我们不被“困在”该节点中。欧拉对哥尼斯堡七桥问题的分析更加抽象化。首先,欧拉将每片地区抽象为一个点,并将每座桥抽象为连接两点的一条线,得到如下抽象图形。与上一节中的分析类似,对于任意一个与起点不同的节点,进入该节点需
如果 pairs 的一个重新排列,满足对每一个下标 i(1 <= i < pairs.length)都有 endi-1 == starti,那么我们就认为这个重新排列是 pairs 的一个合法重新排列。然而,设 pair 的数量有 个,这样构建的图将有 条边(考虑 个 pair 满足 end == 1,另外 个 pair 满足 start == 1 的数据),无法满足本题的数据范围。更妙的是,我们
如果 pairs 的一个重新排列,满足对每一个下标 i(1 <= i < pairs.length)都有 endi-1 == starti,那么我们就认为这个重新排列是 pairs 的一个合法重新排列。然而,设 pair 的数量有 个,这样构建的图将有 条边(考虑 个 pair 满足 end == 1,另外 个 pair 满足 start == 1 的数据),无法满足本题的数据范围。更妙的是,我们