- @LLMliandanlu


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
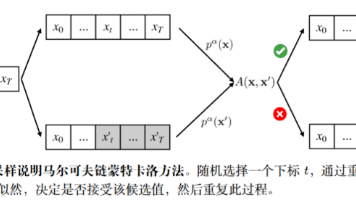
RL 后训练是否真正“学到”新能力? 文献质疑很多推理提升其实是对基座模型分布的“锐化”,并指出 RL 常出现多样性塌缩、pass@k→single‑shot 的再分配等现象(引言与相关工作)。作者转而追问:仅靠采样能否在推理时把这些能力“唤出”?避免 RL 的现实痛点:RL 需要可验证奖励、数据清洗与大规模超参搜索,训练不稳定且常牺牲多样性。本文欲在不训练的前提下,获取与 RL 相当的单次推理性
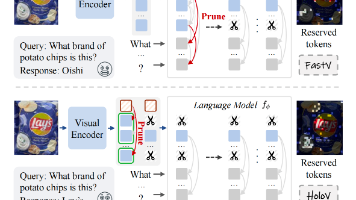
关键词:视觉令牌剪枝、多模态大语言模型、全局上下文保留、注意力机制偏差、HoloV框架、自适应令牌分配、视觉上下文重提取、位置偏差、注意力分散
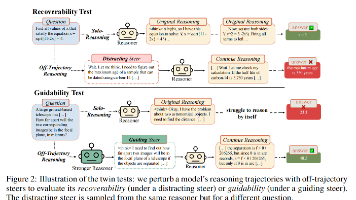
论文揭示了现有独立推理LLMs在协作场景中的根本局限性:即使是最强的模型也无法有效抵抗错误推理的干扰或利用正确推理的引导。这一发现挑战了传统基准测试对模型推理能力的评价标准,为构建真正具备协作能力的多智能体推理系统提供了重要理论基础和方法论创新。
架构革新(如Mamba在扩散模型中的应用、统一化基础模型设计)、效率提升(如知识蒸馏、无需训练框架)及垂直领域突破(如自动驾驶、医疗影像、遥感分析)等
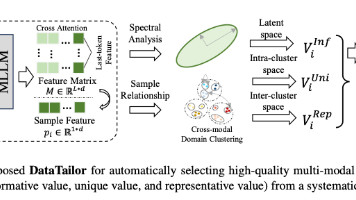
语言模型(Language Model, LM)在进行下游任务的后训练(Post-Training)时,常常面临灾难性遗忘(Catastrophic Forgetting)的问题,即模型在学习新任务的同时丢失了原有的知识能力。本文提出从策略数据(On-Policy Data) 的角度系统分析并缓解遗忘现象。通过在多类任务、多种模型上的实验,论文发现RL因其使用当前策略生成的数据进行训练,相较于SF
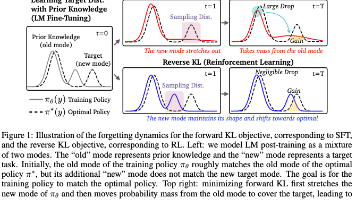
架构革新(如Mamba在扩散模型中的应用、统一化基础模型设计)、效率提升(如知识蒸馏、无需训练框架)及垂直领域突破(如自动驾驶、医疗影像、遥感分析)等
语言模型(Language Model, LM)在进行下游任务的后训练(Post-Training)时,常常面临灾难性遗忘(Catastrophic Forgetting)的问题,即模型在学习新任务的同时丢失了原有的知识能力。本文提出从策略数据(On-Policy Data) 的角度系统分析并缓解遗忘现象。通过在多类任务、多种模型上的实验,论文发现RL因其使用当前策略生成的数据进行训练,相较于SF
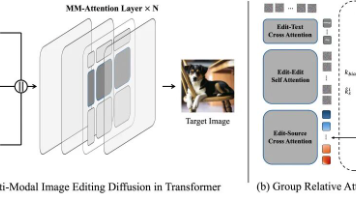
Diffusion Transformer、MM-Attention、可控图像编辑、GRAG、天津大学、快手Kolors、分组相对注意力引导(Group Relative Attention Guidance, GRAG)、多模态注意力(Multi-Modal Attention, MM-Attention)、图像编辑(Image Editing)、视觉语言模型(Vision-Language M
关键词:视觉令牌剪枝、多模态大语言模型、全局上下文保留、注意力机制偏差、HoloV框架、自适应令牌分配、视觉上下文重提取、位置偏差、注意力分散
一文看懂AI 智能体与代理性 AI 的核心差异