- @LLM_jingjinzhilu


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
我们还注意到,近期不少同学反馈Codex安装中遇到各种报错,我们整理了近期的真实问题反馈,按 Windows 和 Mac 分类,并附上经过验证的解决步骤。为避免各位在下载过程中遇到的困难,我们还准备了 Mac 和 Win 的安装包。如果你也在安装过程中出现问题,欢迎后台私信我【B636】,这份问题解决指南和安装包会免费发送给您。
本文提出了一种针对Scaffold联邦学习的新型后门攻击方法BadSFL,通过操纵控制变量机制将良性客户端转化为攻击"帮凶"。该方法结合GAN数据增强、多模态触发设计及控制变量优化策略,在非IID场景下实现了攻击效果的持久性和隐蔽性。实验表明,BadSFL在MNIST等数据集上后门成功率超过80%,攻击效果可持续60轮以上,是现有方法的3倍。研究首次揭示了Scaffold算法的
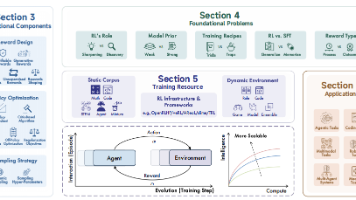
本文系统阐述了强化学习(RL)驱动大语言模型(LLMs)实现复杂推理能力突破的关键技术与应用。核心创新在于可验证奖励机制(RLVR),通过过程奖励和生成式奖励提供精细反馈,结合GRPO等高效策略优化算法和结构化采样策略,显著提升模型在数学推理、代码生成等任务中的规划与自我修正能力。文章深入探讨了RL与监督学习的本质差异,分析了从不同基模型训练的影响,并全面介绍了支撑RL训练的数据资源、交互环境和基
本文精选20篇大模型领域最新研究,涵盖12个核心方向。研究发现:AI偏见显著影响人类决策(90%受试者被影响);概念级记忆机制提升推理能力7.5%;LLM在电商推荐中实现36%加购率提升;中文虚假信息核查存在局限;阿拉伯文化理解准确率仅72.15%。同时,研究揭示了LLM在自动驾驶迁移性、隐私政策解析、人格行为一致性等方面的突破与挑战,为技术发展提供了重要参考。

本周精选12篇大模型领域前沿论文,覆盖模型压缩、多模态融合、训练优化和安全可靠性等方向。在模型压缩方面,ButterflyQuant提出可学习正交变换实现高效2位量化;ENSI创新结合加密方案与轻量架构,实现隐私安全推理加速;EvolKV通过进化搜索优化KV缓存管理。多模态领域,HumbleBench构建首个MLLM认知谦逊评估基准;MatCha发布材料科学专业理解测试;VIRAL提出视觉表征对齐
【大模型前沿研究速览】本周精选12篇论文聚焦LLM四大方向:1)安全防御:提出DeepRefusal框架,通过概率消融重建拒绝机制,攻击成功率降低95%;2)推理优化:FlowRL框架通过奖励分布匹配增强推理多样性,数学推理性能显著提升;3)跨模态应用:多模态LLM实现零样本视频时空定位,街景分析还原历史政策影响;4)系统部署:LEAP架构结合存内计算,能效较GPU提升71倍。另含参数高效微调、课

OpenAI团队提出GDPval基准,旨在前瞻性评估AI模型在真实经济任务中的能力。该基准涵盖美国9大GDP贡献行业的44个职业,包含1320个由资深专家设计的真实任务。研究发现,前沿模型(如Claude Opus4.1)在近48%的任务中表现达到或超越人类专家水平,且性能随时间线性提升。研究还验证了增加推理努力、任务上下文和引导能有效提升模型表现。该工作为量化AI的经济价值提供了新框架,并开源了

【大模型前沿论文速览】本周精选12篇论文涵盖六大方向:1)强化学习优化:提出概率平滑策略(PSPO)和树搜索方法(Tree-GRPO),解决梯度不连续与奖励稀疏问题;2)评估与偏见:TrustJudge框架提升LLM评估一致性,MFA智能体缓解文化偏见;3)代码任务:创新多指令评估基准与语法纠错方法(PoCO);4)安全隐私:揭示水印技术漏洞(RLCracker)和智能体工具风险(AutoMalT

本周精选12篇大模型前沿论文,聚焦5大研究方向:1)多智能体与语义网络建模,提出LLM辅助的AJAN框架建模方案;2)迭代优化与自调试,创新树引导策略优化和摘要式上下文管理;3)翻译与文本理解,开发质量感知解码和无监督短文本聚类方法;4)评估与鲁棒性,构建动态文本嵌入评估基准并揭示排序漏洞;5)工业应用,推出客服反馈飞轮、学术筛选工具和视频推荐系统。这些研究在提升大模型性能的同时,更注重降低使用门
本周精选 12篇大模型领域前沿论文,覆盖大模型安全与可信性、大模型评估与基准测试、大模型行业应用与落地、大模型技术架构与系统优化等方向。全部200多篇论文皆可扫码免费领取。➔➔➔➔点击查看原文,获取本期大模型周报合集llm词云图。