- @LLCHS


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文从概率统计角度揭示了机器学习中损失函数的本质联系:(1) 最小化交叉熵损失等价于最大似然估计,其梯度即为预测概率与真实标签的差值;(2) 交叉熵最小化也等同于最小化KL散度,衡量真实分布与预测分布的差异;(3) 在高斯噪声假设下,最小化均方误差等价于线性模型的最大似然估计。这些结论表明,常见的损失函数设计背后都有坚实的概率统计基础,不同视角(概率、优化、统计)最终导向相同的优化目标。
本文从多个角度分析L1和L2正则化的差异与联系。KKT优化视角显示L2均匀缩小权重而L1产生稀疏解;贝叶斯视角表明L2对应高斯先验,L1对应拉普拉斯先验;几何视角指出L1的菱形约束导致稀疏性。梯度下降视角解释L2是权重衰减,L1是常数推动。模型复杂度视角说明L2平滑降维,L1直接特征选择。实践建议:高维解释性需求选L1,特征相关用L2,深度学习推荐L2+早停。两种正则化本质是不同先验分布下的最大后
本文介绍了大模型训练的三个关键阶段:预训练(PT)、监督微调(SFT)和偏好优化(RLHF/DPO)。PT通过海量文本让模型掌握语言规律和世界知识;SFT通过少量高质量问答数据教会模型如何组织回答;RLHF/DPO则通过人类偏好进一步优化模型行为。文章重点剖析了SFT的数据格式(Alpaca/ChatML)、训练技巧(Loss Masking、Teacher Forcing)以及潜在风险(幻觉、遗
本文探讨了深度学习训练中的资源优化问题。首先分析了张量操作的内存效率,指出view/transpose等操作的zero-copy特性及contiguous问题。接着讨论了不同浮点格式(FP32/FP16/BF16)在显存占用和训练稳定性上的权衡。重点阐述了矩阵乘法的计算复杂度估算方法,推导出FLOPs计算公式,并解释了MFU指标的意义。文章还介绍了数据加载的优化技巧如memmap和pin_memo
本文介绍了大模型训练的三个关键阶段:预训练(PT)、监督微调(SFT)和偏好优化(RLHF/DPO)。PT通过海量文本让模型掌握语言规律和世界知识;SFT通过少量高质量问答数据教会模型如何组织回答;RLHF/DPO则通过人类偏好进一步优化模型行为。文章重点剖析了SFT的数据格式(Alpaca/ChatML)、训练技巧(Loss Masking、Teacher Forcing)以及潜在风险(幻觉、遗
本文概述了大模型评估的核心问题和主要测试方法。评估的本质是定义"模型变强"的标准,当前面临评估危机——传统基准饱和而盲测榜单可能被过拟合。文章将评估拆解为输入来源、调用方式、输出判断和结果解读四个环节。重点介绍了五种测试方式:知识类(如MMLU)、指令遵循类(如Chatbot Arena)、智能体类(如SWEBench)、纯推理类(如ARC-AGI)和安全类(如HarmBenc
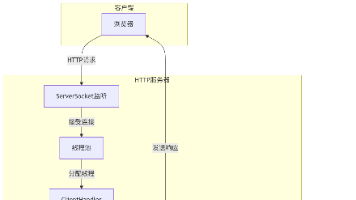
本项目使用Java Socket网络编程实现了一个简易的多线程HTTP服务器,支持GET、POST和HEAD三种HTTP请求方法,能够根据浏览器指定的URL返回服务器上相应的网页文件,并实现了日志记录和安全防护功能。参考了HTTP协议相关资料及Java Socket编程示例,核心代码均为自主编写。
本文深入探讨了分词器(Tokenizer)在大型语言模型中的关键作用与技术实现。文章首先解释了分词器作为文本预处理组件的重要性,它能决定模型处理文本的基本粒度。随后详细介绍了分词器的整体训练流程,包括数据预处理、多语言语料处理、预分词等关键步骤。重点分析了字符级、字节级、词级和BPE四种主流分词算法的原理与适用场景,其中BPE因其平衡性成为当前主流方法。文章还深入剖析了DeepSeek分词器中字节
本文概述了大模型评估的核心问题和主要测试方法。评估的本质是定义"模型变强"的标准,当前面临评估危机——传统基准饱和而盲测榜单可能被过拟合。文章将评估拆解为输入来源、调用方式、输出判断和结果解读四个环节。重点介绍了五种测试方式:知识类(如MMLU)、指令遵循类(如Chatbot Arena)、智能体类(如SWEBench)、纯推理类(如ARC-AGI)和安全类(如HarmBenc
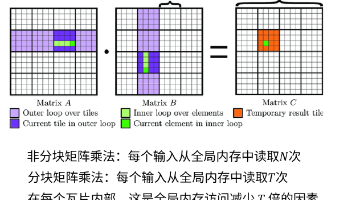
本文探讨了GPU如何成为大语言模型(LLM)的核心硬件,并分析了相关优化技术。首先对比了CPU与GPU的差异,指出GPU的大规模并行特性天然适合LLM的矩阵运算需求。随后详细解析了A100的层级结构、Tensor Core设计原理,以及GPU的SIMT执行模型和分层内存架构。重点阐述了常见优化手段:低精度计算减少数据搬运、算子融合降低中间结果存储、重计算节省显存、内存合并提高访问效率、分块提升数据