- @L698698S


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文剖析 Transformer 取代 RNN、LSTM,成为大模型标配的核心原因。传统循环网络串行执行,训练慢、长文本信息易衰减,建模能力受限。Transformer 通过自注意力实现序列并行计算,充分释放 GPU 算力;任意 Token 可直接交互,解决长距离依赖;多头注意力从多个子空间学习语义、语法与逻辑关系,表征能力更强。架构上天然适配大数据预训练与复杂推理,适合面试备考与原理入门,配套课

本文梳理NLP从N-gram、HMM统计模型,到机器学习、深度学习,再到Word2Vec、Transformer、预训练模型直至GPT大模型的完整演进路线。围绕各阶段核心思想,剖析每一代技术要解决的痛点,理清人工规则、特征工程、端到端学习、自监督预训练、规模涌现等关键变革,帮助开发者理解大模型技术迭代底层逻辑,适合面试复盘与体系化学习。

本文梳理NLP从N-gram、HMM统计模型,到机器学习、深度学习,再到Word2Vec、Transformer、预训练模型直至GPT大模型的完整演进路线。围绕各阶段核心思想,剖析每一代技术要解决的痛点,理清人工规则、特征工程、端到端学习、自监督预训练、规模涌现等关键变革,帮助开发者理解大模型技术迭代底层逻辑,适合面试复盘与体系化学习。
本文从概率视角讲解语言模型核心原理,区分通俗理解与标准数学定义,借助链式法则拆解序列联合概率的推导过程,搭配多组文本案例对比概率差异,清晰说明语言模型打分与下一词预测两种等价理解方式。同时对比传统N-gram统计语言模型与Transformer自回归大模型的差异,介绍PPL等评估指标与落地场景,梳理初学者常见认知误区,纠正“概率高等于事实正确”的错误想法。作为大模型入门基础,为后续学习预训练、RA

CV 领域研究逐步从 2D 多模态转向空间智能。2D 大模型缺少真实三维空间认知,三维视觉与大模型融合可构建能感知几何、做空间推理的空间基础模型。本文梳理三维重建与大模型的主流融合架构,解析无人机、车载自动驾驶、室内机器人落地方案,分析端侧推理、空间幻觉、动态场景漂移等落地难题,并介绍轻量化空间大模型、空间智能体等前沿方向,为相关技术产业化提供参考。

VLLM 是工业界主流高性能大模型推理框架。本文从 KV‑Cache 基础原理入手,指出传统 KV Cache 存在显存碎片化的痛点;重点解析两大核心技术:借鉴操作系统分页的 PageAttention 机制,依靠页池与页表优化 KV Cache 显存分配,缓解显存碎片;介绍连续批处理,对比传统静态批处理缺陷,通过区分 Prefill、Decode 阶段动态调度请求,提升 GPU 算力利用率。从内
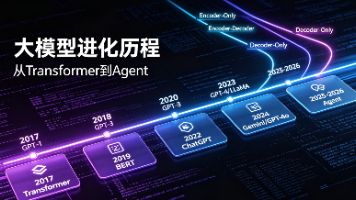
本文梳理 2017 至 2026 年大语言模型演进历程,对照 LLM 进化树,划分 Encoder‑Only、Encoder‑Decoder、Decoder‑Only 三大技术分支,按时间线拆解关键里程碑。从 Transformer 诞生、预训练范式建立,到 RLHF 催生 ChatGPT,再到开源浪潮、多模态突破。2025-2026 进入 Agent 时代,模型从被动问答转向自主执行复杂任务,同