- @AIGCmagic


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
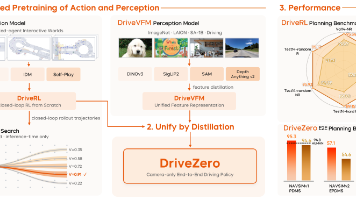
这套分解值得抄。感知吃图,动作吃交互,最后用蒸馏接到可上车的观察上。直接在像素上做强化学习,这条路他们写明了样本和仿真都贵。把老师做小、把世界做并行,是这篇里最能落地的工程选择。AlphaGo Zero的类比只能用一半。棋盘规则是完整的,驾驶世界仍然靠人类日志播种。越过的是轨迹标签,不是人类数据本身。意图扩增那组消融把边界画得很清楚,老师轨迹并不自动比人强,多样化的合法目标才把学生托过人类轨迹监督
三代名字换来换去,收束方向其实清楚。先有一个能预演未来交互的世界模型,再有一个能听指令动手的VLA,这一代把未来变化收成离散token塞进VLM,连续动作另外交给流匹配专家。动态区域这个压缩我觉得比生成整段未来视频更适合操作。手臂和物体动了才是策略要盯的,背景重建是视频模型的负担。短板也硬。64项任务只有演示视频,没有成功率,也没有和前代VLA-0那12类任务的对照。封面写全开源,仓库里WLA-B
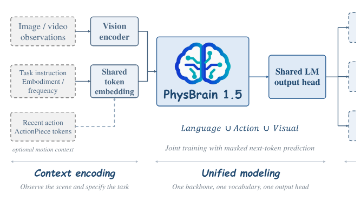
把动作和未来画面塞进语言词表这件事,PhysBrain 1.5做得最彻底的一点是不加任何专用头,连像素重建损失都不要。好处是训练和部署完全复用Qwen3-VL的基础设施。代价是一帧128乘128的未来状态要吐770个token,实时控制肯定不够用。动作那条线最值得抄的是「不统一坐标系,用动作历史做系统辨识」。跨本体数据清洗最烧人力的就是标定和坐标对齐,报告承认这活干不动,转而让模型自己从前一个动作
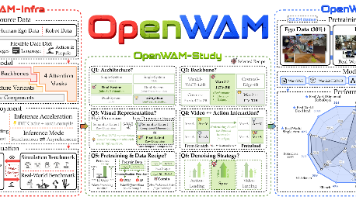
LIBERO再高0.1分说明不了多少。这件事值钱的地方,是把WAM预训练写成可反驳的实验。动作流必须看见世界,推理两路锁步走。具身预训练花出去的计算,回收主要在域外。短板也硬。LIBERO-Plus把像素级WAM的怕脏曝光了,相机33.8、噪声39.8,表征和单臂数据量一起卡住,再加几轮微调补不回来。附录还写了没吃UMI这类带动作的第一人称采集,后训练也基本没做。真机RoboDojo成功率24.4
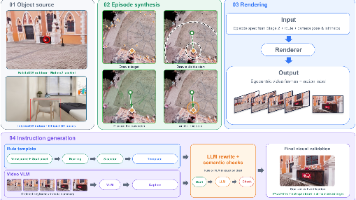
Real2Sim2Real值钱的地方,是一条回合里语言、画面、指点和动作必须说同一件事。场景捕获一次,目标、路线、视角、指令可以反复组合。这才解释得了扩环境比扩小时更有效。导航比操作更早吃到视觉语言模型的空间先验,我看就是输出停在图像平面和可通行空间里,预训练里本来就有。操作还要过接触这一关,报告没提供那部分监督,这条经验不能直接搬。短板也明白。仿真榜单的单目第一,挡不住全景方法在R2R上更高,也
把视觉和动作之间的接口单独拿出来训,比继续把表示做厚更对准这件事。打开直连视觉那条消融,是我觉得全篇最硬的证据,分布内分数还能更好看,分布外立刻往下掉。短板也清楚。语言扰动没有吃到同样的好处,真机每种分布外条件只有每任务10次,样本很瘦。图6里已经有任务在个别条件下比基线差,聚合涨幅不能当成每个场景都更稳。只留顶视时整体仍停在46.7%,换相机这一关还没过。基线也不是公开的微调权重,表格里的涨幅只
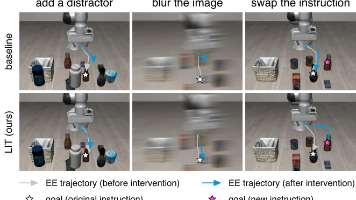
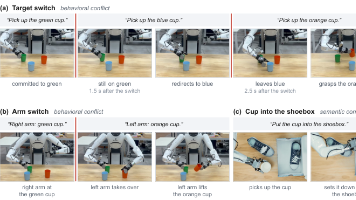
这篇文章最值得看的是那道闸。熟练的物体交互先验负责连续动作,通用模型只在目标、几何或进度跑偏时改写。14.4%的修正步换来成功率接近翻倍。改写落在关键节点,大模型并不包办每一步。对照并不干净。动作先验、动作接口、执行段长度同时变了,报告自己承认还没拆开各自贡献。十任务五次,统计精度有限。精选视频只说明行为机制,不能拿来估计失败类型的比例。延迟仍是报告写明的未解问题。仿真允许停下来想,真实物理过程没
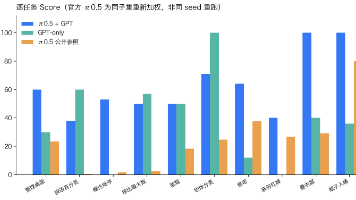
不继承预训练视频生成器这件事,比44.1%这个数更值得看。100项任务里仍有24项一次都没成功,当成能用的通用操作策略还早。对照实验的口径干净。同一套预训练模块,同一套配方,评测不做任务微调,四个规模嵌套着往上加数据。5000小时到30000小时还在涨,至少说明这条从零训起来的世界-动作模型,在他们测到的范围内还没有撞上墙。短板也写在纸上。顺序指代几乎不会。LIBERO-Plus里背景扰动只有60
(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见,欢迎 Star!(2),涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(
三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见,欢迎 Star!,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)