- @2501_93234401


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
核心要点:RAG 解决的是 LLM "不知道"的问题:训练数据里没有的信息,通过检索外部知识库来补充,成本远低于微调向量语义搜索是 RAG 的引擎:关键词匹配做不到的"铁哥们≈最好的朋友",向量能搞定。整个过程靠 Embedding 模型自动完成技术栈很轻:LangChain 做编排、ChromaDB 做向量存储、DashScope 提供模型——三个组件,几十行代码,就能跑起来一个 RAG把知识库
控制概率分布的发散程度,top_k限制采样候选集合。它们的目标不是单独追求随机或保守,而是让输出匹配具体业务。LangChain 通过将 AI 调用拆成清晰的工作流。先固定测试集,再逐项调参,才能让“大模型随机性”变得可观测、可控制。
Benchmark 是门槛:分数低的大概率不行,但分数高的也需要实际验证任务要分层:不同难度的任务用不同档位的模型,别什么都上最贵的看流程参与度:能调用工具、能推进流程的模型,比只会聊天的价值大得多算总成本:Token 费用只是一部分,人工校验、失败返工、时间成本都要算进去。
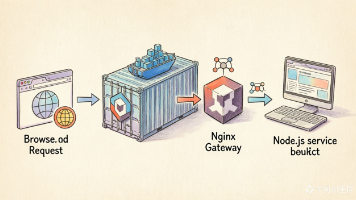
学习这组技术时,不要只背命令。始终沿着“浏览器 → 宿主机端口 → 容器端口 → Nginx → Node.js”检查,请求在哪一段断开,问题通常就在哪一层。下一步可以补充 Dockerfile、Docker Compose、容器网络和数据卷,让多个服务从手工命令走向可复现编排。Docker、Nginx、Node.js、反向代理、容器化。
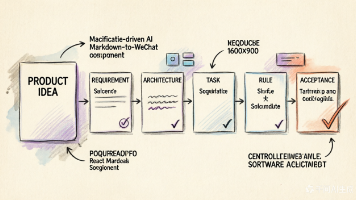
AI Coding 的可控性并不来自一句“请严格按要求实现”,而来自一套能相互校验的工程结构:需求限制边界,架构连接数据流,任务缩小上下文,规则约束执行方式,验收定义停止条件。md-wx 目前最有价值的成果不是代码,而是已经形成了这条管理链路。下一步不应直接冲向完整组件,而应先关闭三个规格冲突,再只执行“项目初始化和配置”这一个任务,用真实构建结果完成第一次验收闭环。标签:AI Coding, R
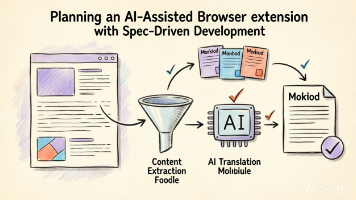
规划笔记强调先回答“做什么”,再调研和验证需求,并明确返回格式与“不做什么”。这个插件的难点不只是“让 AI 翻译网页”,而是保证网页提取、模型调用、Markdown 处理和浏览器交互形成稳定闭环。SDD 的价值,是在生成代码前先暴露这些决策:用明确用户、MVP 和非目标,用design.md固化技术方案,用task.md拆出可验收步骤,再使用 Git 和文档管理 AI 生成过程。下一步不是立即生
tool_calls// Layer 1: LLM 客户端(缸中大脑)// Layer 2: 工具协议层(认知植入)// Layer 3: 函数实现层(传统软件)// Layer 4: Agent 编排层(意图识别 + Runtime 介入)// 第一次调用:LLM 决策// Runtime 执行// 第二次调用:LLM 总结Tool Use 不是魔法,是协议。LLM 只会预测下一个词,但用户需要
这个项目最值得迁移的设计不是某一个 API,而是职责划分:React 处理交互,Worker 管理重任务,模型类负责资源生命周期,消息状态负责跨线程反馈。理解这条调用链后,再学习 WebGPU、tokenizer 或流式生成,都会更容易定位问题。建议下一步按以下顺序实践:先单独完成 Worker 的消息往返,再接入 tokenizer,最后接入模型和流式 UI。本文代码和项目运行结果均未验证,部署
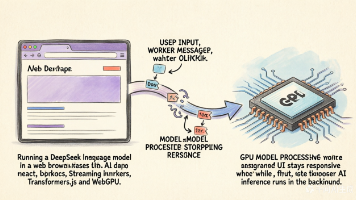
这个项目最值得迁移的设计不是某一个 API,而是职责划分:React 处理交互,Worker 管理重任务,模型类负责资源生命周期,消息状态负责跨线程反馈。理解这条调用链后,再学习 WebGPU、tokenizer 或流式生成,都会更容易定位问题。建议下一步按以下顺序实践:先单独完成 Worker 的消息往返,再接入 tokenizer,最后接入模型和流式 UI。本文代码和项目运行结果均未验证,部署
AI Agent 的本质就是一个带工具调用的对话循环。LLM 推理 → 调工具 → 观察结果 → 再推理。一个 30 行的 for 循环就是整个系统的心跳。理解了这一点,任何 Agent 框架(LangChain、AutoGPT、CrewAI)在你眼里都会变得透明。工具设计不是在写 API,而是在和 LLM “对话”。你需要预判 LLM 会在什么场景下犹豫,主动设计容错和引导。描述写多详细、参数怎