


- @2403_87933448


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
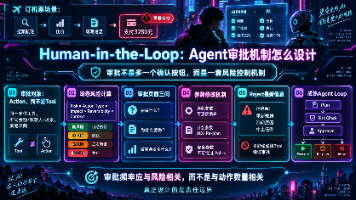
在AI Agent处理支付等高风险操作时,应将Human-in-the-Loop设计为动态风险控制机制,而非简单确认按钮。需基于交易金额、收款人可信度、可逆性及任务上下文综合评估风险,区分不同Action的审批策略。审批界面应清晰传达“做什么、为何做、有何后果”,并限制关键参数修改,防止绕过安全策略。用户拒绝后,Agent应智能重规划或反馈原因,而非重复请求。核心在于明确责任边界:风险越高,透明度
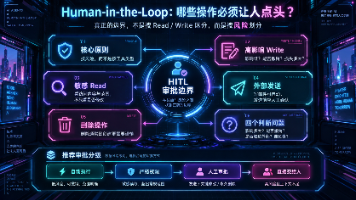
AI Agent自动化虽高效,但关键操作需引入Human-in-the-Loop(HITL)以控制风险。真正决定是否审批的,不应是“读”或“写”的类型,而应基于四重标准:影响是否不可逆、是否涉及外部主体、是否触碰高敏数据、责任是否需由人承担。低风险、可撤销的操作可自动执行;而发送邮件、删除文件、修改客户信息等高影响动作,应设审批门槛。通过按风险分级而非工具类型划分权限,既能保障安全,又避免审批疲劳
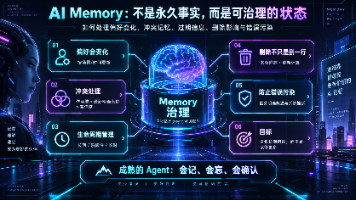
本文讨论 AI Agent 的 Memory 治理:用户偏好会随时间与场景变化,记忆可能冲突、过期、被错误强化,也可能在删除后继续影响推导结果。因此,Memory 不应被视为永久事实,而应具备作用域、时间、置信度、来源追踪、覆盖、降权、过期与撤销机制。成熟的 Agent,不是记得更多,而是能判断何时该信、该忘、该重新确认。
本文讨论 AI Agent 的 Memory 治理:用户偏好会随时间与场景变化,记忆可能冲突、过期、被错误强化,也可能在删除后继续影响推导结果。因此,Memory 不应被视为永久事实,而应具备作用域、时间、置信度、来源追踪、覆盖、降权、过期与撤销机制。成熟的 Agent,不是记得更多,而是能判断何时该信、该忘、该重新确认。
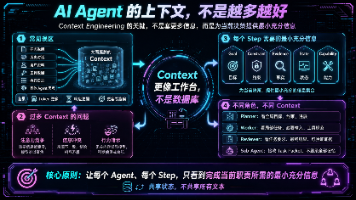
AI Agent 的核心竞争力并不是拥有更多 Context,而是能够在正确时间获取正确的信息。本文探讨 Context Engineering 的设计原则,分析过量上下文带来的注意力竞争、信息冲突和行为偏差问题,并介绍如何通过 Step 级信息筛选、Planner/Worker 角色隔离、Reviewer 独立验证以及 Sub-Agent 任务包设计,构建高效、精准、可扩展的 Agent 上下文
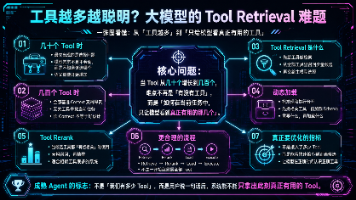
Tool 数量增长后,Agent 的主要瓶颈会从“有没有工具”转向“能不能在当前任务里找出正确的工具”。
AI Agent 调用工具遇到 429、超时等报错,直接重试极易引发重试风暴,放大服务拥堵。需区分可恢复、条件可恢复、不可恢复错误,读写工具差异化处理,采用指数退避加抖动策略。带副作用的支付、发消息等操作要警惕重复执行风险,优先依靠幂等机制,懂得何时停止比一味重试更关键。
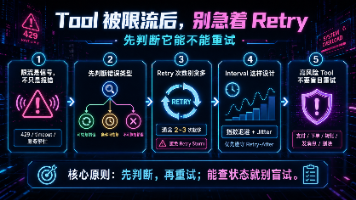
AI Agent 调用工具遇到 429、超时等报错,直接重试极易引发重试风暴,放大服务拥堵。需区分可恢复、条件可恢复、不可恢复错误,读写工具差异化处理,采用指数退避加抖动策略。带副作用的支付、发消息等操作要警惕重复执行风险,优先依靠幂等机制,懂得何时停止比一味重试更关键。
这篇文章围绕 AI Agent 的 Tool 设计展开,重点讨论工具粒度、业务 Tool 与 SQL Tool 的取舍,以及参数缺失、类型错误和调用失败时如何处理。核心观点是:可靠的 Agent 系统不应追求给模型无限自由,而应把 Tool 设计成清晰、有限、可验证的业务能力。通过合理控制粒度、用 Schema 约束参数、允许缺参时追问,并返回结构化错误,可以显著降低模型猜测和误调用,让系统形成“
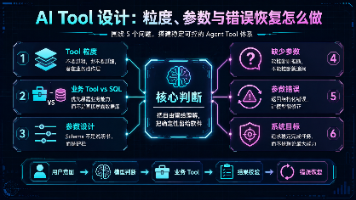
这篇文章围绕 AI Agent 的 Tool 设计展开,重点讨论工具粒度、业务 Tool 与 SQL Tool 的取舍,以及参数缺失、类型错误和调用失败时如何处理。核心观点是:可靠的 Agent 系统不应追求给模型无限自由,而应把 Tool 设计成清晰、有限、可验证的业务能力。通过合理控制粒度、用 Schema 约束参数、允许缺参时追问,并返回结构化错误,可以显著降低模型猜测和误调用,让系统形成“