- @2401_85325397


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
2024的医疗AI,既是坎坷,又是新生。快速发展的大语言模型,携着生成式AI掠过医疗领域。过往的互联网医疗、医学影像、新药研发……一个一个场景经由新一代AI重塑,焕发出前所未有的价值。不过,发现价值并不意味着能够掘得价值。如今惨淡的融资形势下,躬身大模型的企业们无法像深度学习时代那样随意试错。有限的现金流,意味着每一家企业必须全面考察场景、技术、风控、商业化等方方面面,才能做出决定。有需要完整报告

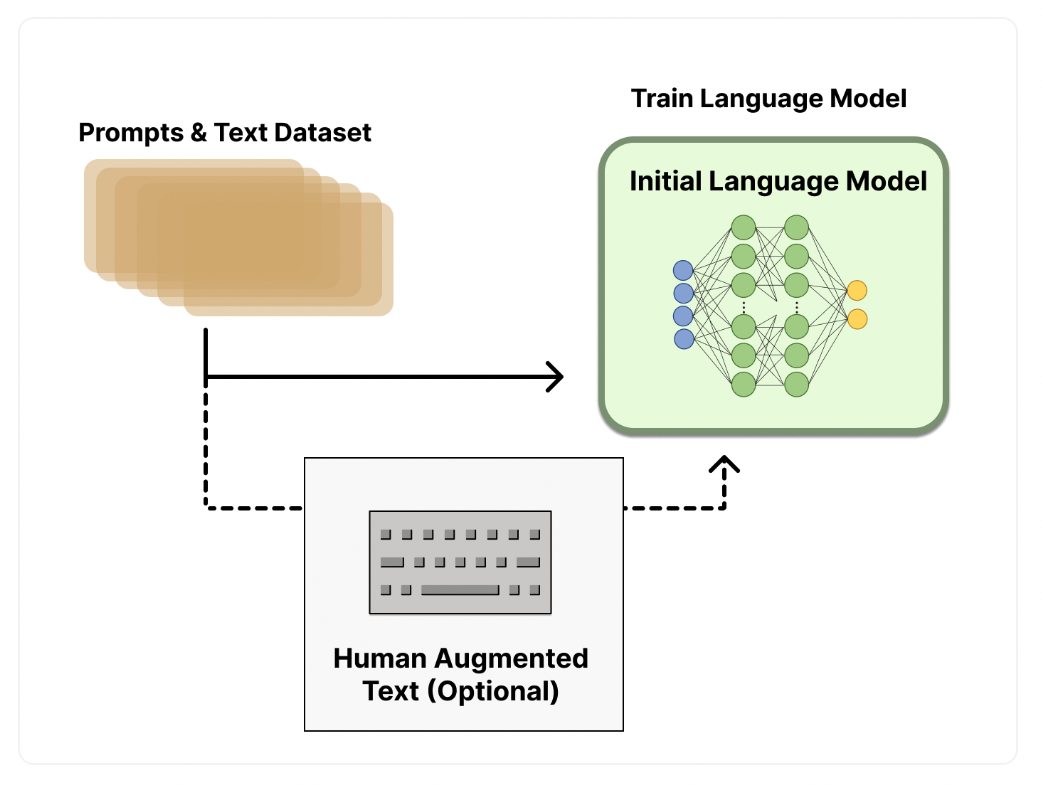
首先在 Ziya-LLaMA-13B-V1基线模型的基础上加入中医教材、中医各类网站数据等语料库,训练出一个具有中医知识理解力的预训练语言模型(pre-trained model),之后在此基础上通过海量的中医古籍指令对话数据及通用指令数据进行有监督微调(SFT),使得模型具备中医古籍知识问答能力。

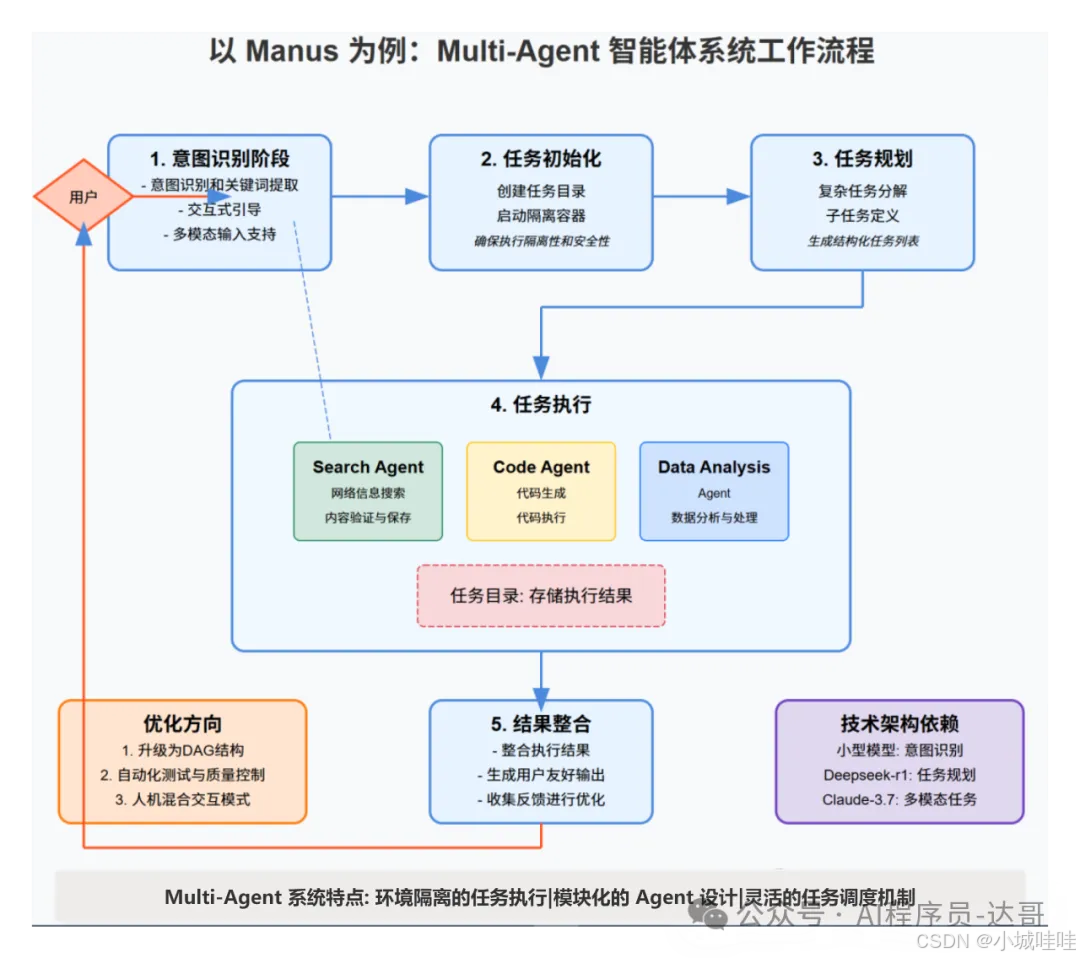
AI智能体Manus突然杀出,瞬间引爆整个科技圈。现在所有AI爱好者都在抢破头要Manus邀请码,闲鱼上已经炒到从999块到五万块都有。这波热潮说白了,就是大伙儿都盼着下一代AI交互方式赶紧到来。
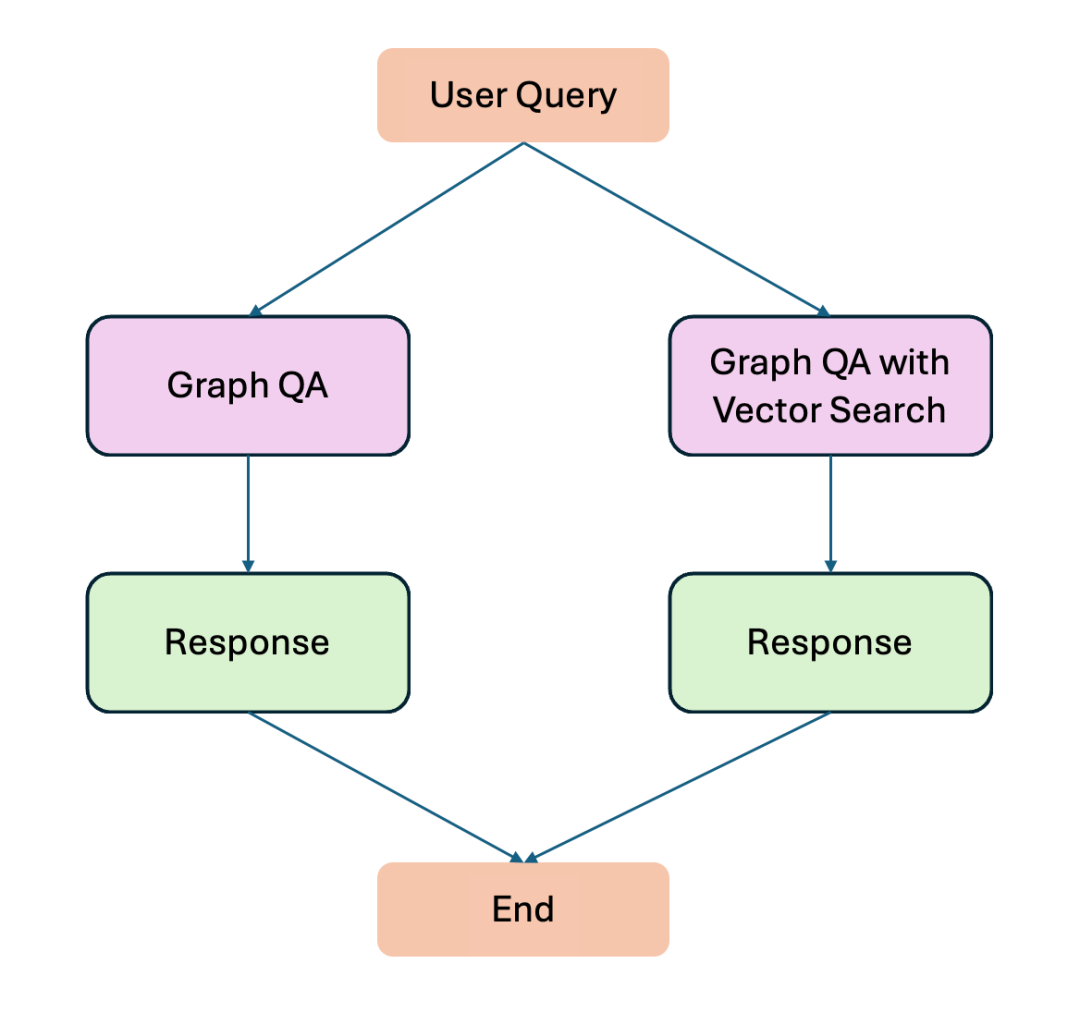
自从 Neo4j 宣布与 LangChain 的集成以来,我们已经看到许多围绕使用 Neo4j 和大语言模型(LLM)构建检索增强生成(RAG)系统的用例。这导致了近年来知识图谱在 RAG 中使用的快速增加。基于知识图谱的 RAG 系统在处理幻觉方面的表现似乎优于传统的 RAG 系统。我们还注意到,使用基于代理的系统可以进一步增强 RAG 应用程序。为此,LangGraph 框架已被添加到 Lan
核心原理: BN在每一层的训练过程中,对输入的激活值在小批量(batch)内进行归一化。计算均值和方差:对于给定的批量输入,计算每个神经元的均值μ 和方差σ;归一化:使用计算得到的均值和方差,对输入进行标准化处理,使其均值为0,方差为1。缩放和平移:引入可学习的参数 γ 和 β,对标准化后的数据进行缩放和平移,以增加模型表达能力。简单例子: 假设我们有一个批量大小为2的输入 [2, 4]。我们计算
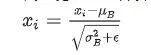
大型深度学习模型(简称AI大模型)以其强大的表征能力和卓越的性能,在自然语言处理、计算机视觉、推荐系统等领域均取得了突破性的进展。尤其随着AI大模型的广泛应用,无数领域因此受益。《实战AI大模型》是一本兼具深度和广度的大模型入门书籍,它深入浅出地诠释了AI大模型的核心概念和技术。以大模型为代表的AI2.0是有史以来最重要的技术革命,如果你渴望了解和应用大模型,这本书是一份可贵的“知识基座”

在上世纪50年代,阿兰·图灵提出了“高度智能有机体”概念,后来这一概念延伸至人工智能领域。随着大模型的快速发展,这一概念再次被重视。大模型成为目前智能体的理想载体,有望从理论转向实际应用。在智能体(Agent)模式中,用户为AI设定目标和身份,提供提示词(Prompt),AI则自主拆解任务、使用工具并执行工作,用户负责监督与提供资源。OpenAI定义的**智能体具备长期和短期记忆、自主规划、工具使

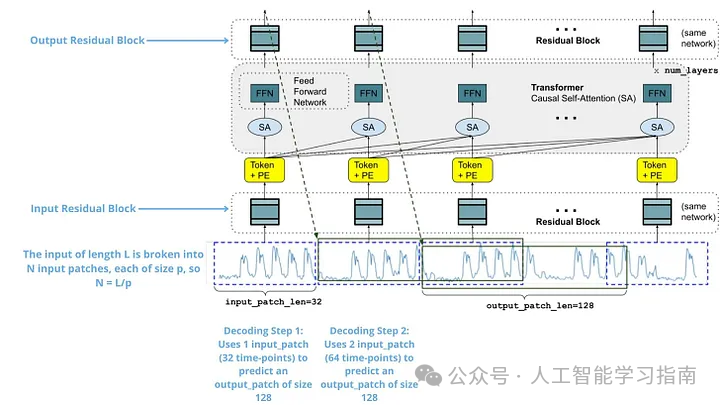
最近时间序列基础模型领域,迎来了里程碑式的突破。TimeGPT作为首个原生基础模型,于去年八月问世,一发布就震撼了预测领域。众多其他基础模型也相继发布,包括但不限于:*TimesFM*MOIRAI*Tiny Time Mixers(TTM)*MOMENT
谷歌最近发布了 Gemma 3,这是其开源模型家族的最新版本,为 AI 行业带来了深远的创新。Gemma 3 凭借多模态处理能力、庞大的上下文窗口和增强的语言支持,标志着大型语言模型 (LLM) 发展的重要里程碑。该模型的开源特性为开发者和研究人员提供了前所未有的机会,可以在各种应用场景中探索和利用先进的 AI 能力。

奖励模型是输入一个文本序列,模型给出符合人类偏好的奖励数值,这个奖励数值对于后面的强化学习训练非常重要。构建奖励模型的训练数据一般是同一个数据用不同的语言模型生成结果,然后人工打分。如果是训练自己领域的RLHF模型,也可以尝试用chatgpt打分,效果也不错。