


- @2301_82040283


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Dyna-2 留下的核心启示,不是百万小时训练需要一套更大的基础设施,而是随着模型和数据规模变化,系统瓶颈会不断迁移。模型的读取模式约束着数据如何编码、分块和缓存;数据管线与容错能力决定采购的 GPU 有多少真正转化为有效训练;基础设施能否支撑更大规模的实验,又影响团队是否有足够证据判断一个研究方向。
随机访问场景下,每次打开视频并构建解码对象,都会产生一次固定开销,一个样本涉及多个相机或多个分段时,这笔开销累积得越明显。原有流程中,抽帧位于数据处理链路下游,解码层不知道下游需要哪些帧,仍会将 33 帧全部解出,其中 24 帧随后被丢弃。把所有可能的窗口提前裁出来解码存好并非做不到,但存储会成倍膨胀,采样方式也随之固定,所以实际训练通常保留原始 episode,训练时随机确定采样窗口,再在线定位
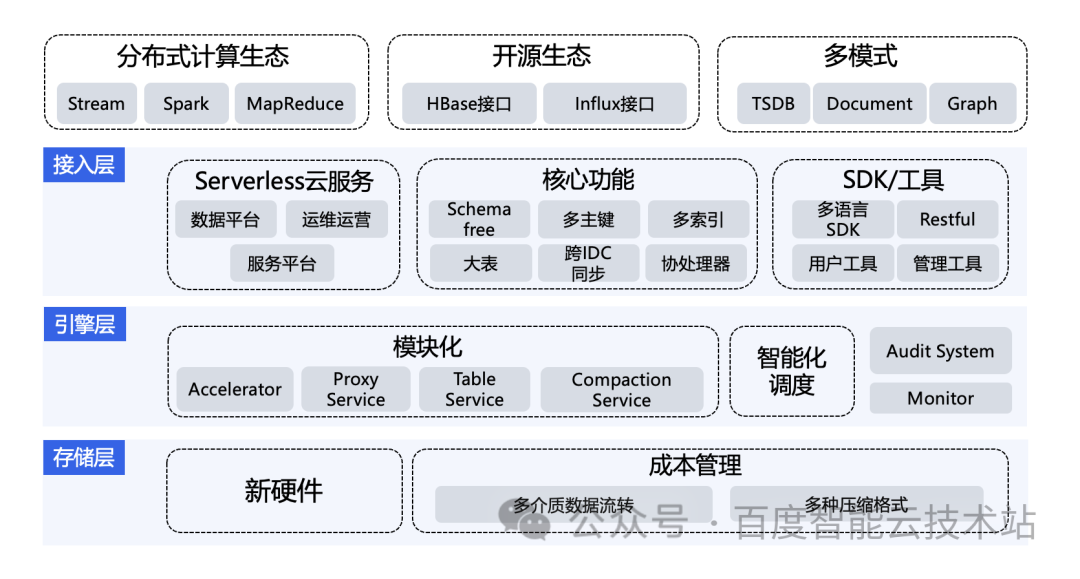
BTS 可用于丰富的场景,比如横向业务场景(分布式存储、结构化、聚合、高性能检索)、纵向行业场景(互联网、广告、feed、物联网、大数据、时序)以及一体化解决方案(大数据分析生态,监控)等,支撑业务创新。BTS 目前支持超万亿的日均访问量,场景上覆盖了宽表、时序、大数据的处理和分析场景,覆盖了物联网、AI、feed 流、广告、健康、搜索、web 应用、自动驾驶等诸多方向。BTS 具备了完善的高可用
如果我们把时延和拓扑数据交给 LLM 进行分析,它会结合拓扑对时延数据进行分析,并且给出最终的结论:当前每一组的时延是否正常,时延数据是否符合实际数据、如果有异常,是哪一组或者哪些组有异常,该怎么检查,LLM 会分析得明明白白的。
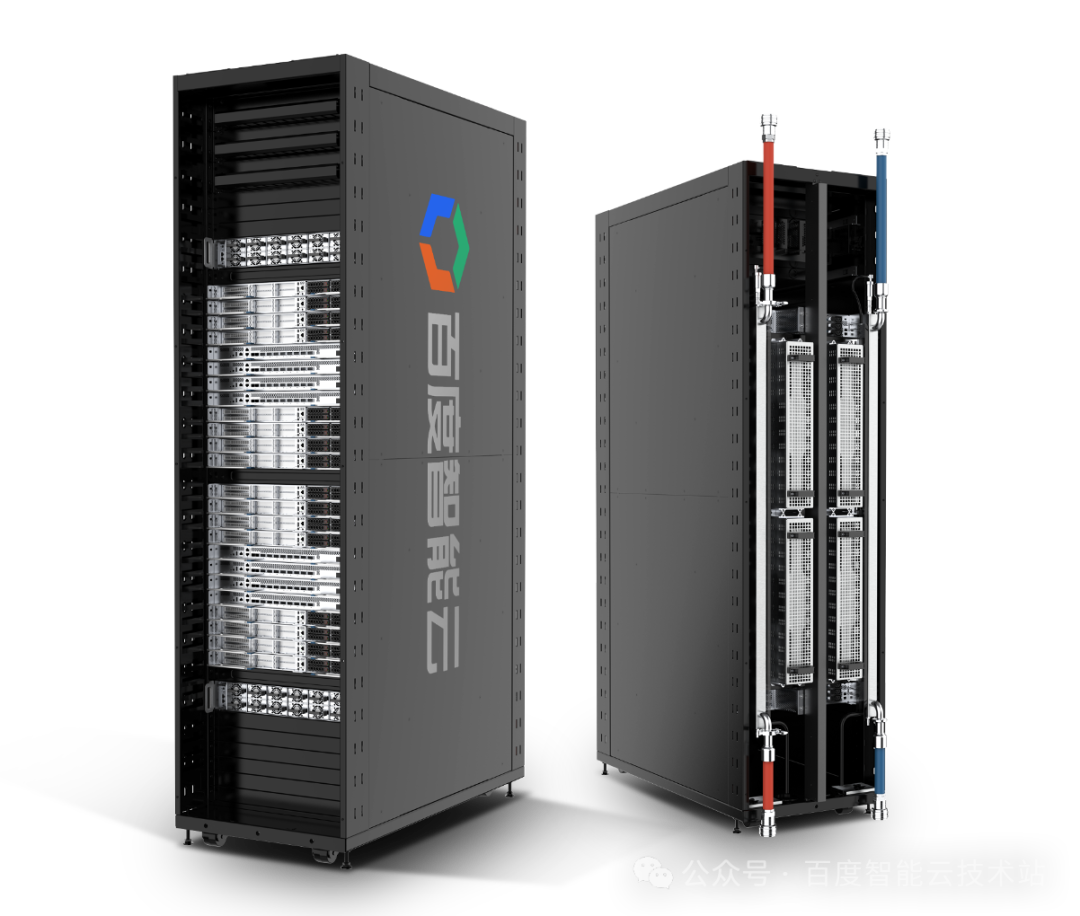
在百度天池 AI 高密液冷整机柜的支撑下,昆仑芯超节点支持 1U 4 卡的超高密度算力交付形式,单节点一个人即可轻松维护。计算节点的核心芯片的温度可以降低 20℃ 以上,为 XPU 提供稳定的运行环境。能够适应各种机房的供电环境,并支持在风冷机房部署交付。
正因为如此,业界一直缺乏一种既能发挥对象存储成本与扩展性优势,同时又能媲美 HDFS 性能的真正可扩展、高性能的层级命名空间解决方案,导致「对象存储成为数据湖存储底座」的愿景,在实际落地中屡屡受阻。Mantle 创新性地将传统文件系统的强大语义优势,与新型对象存储的低成本、可扩展、云原生易运维特性完美融合,实现了革命性的突破,为 EB 级别的新一代数据湖打开了前所未有的想象空间。此次入选 SOSP
在百度百舸 · AI 计算平台的全方位支持下,Dolphin V1.0 成功上线。Dolphin V1.0 在胎儿标准切面识别上的准确率超过 90%,在乳腺病灶分型任务中准确率达到 86%。与上一代仅能执行单任务的专用模型相比,Dolphin 实现了“一模多能”的通用能力,模型复用效率显著提升。未来,海豚智能将不断深化与百度智能云的合作,基于百舸平台全周期的 AI 工程支持,持续训练、提升模型能力
历经体系化治理,百度搜索已实现大规模微服务体系的稳定性跃升。通过微观机制改造、预案建设并经生产环境验证,百度在过去多个季度中消除了系统雪崩事件。本次 SREcon25 的主题分享,不仅展现了团队在微服务可靠性与韧性架构领域的系统化研究成果,也向国际同行展示了百度工程团队在大规模系统稳定性治理上的深厚积累与方法论创新。未来,运维部与搜索架构部将继续深耕自治运维、稳定性建模与智能化自愈机制的研究,携手
超节点作为一种创新的硬件架构,通过构建大规模全互联的 Scale-up 网络,有效突破了传统 8 卡节点在通信上的「互联墙」瓶颈,为上层业务提供了极致的互联带宽与统一显存池化能力,从而实现大模型推理服务性能的跨越式提升。结合新硬件架构的特性,AI Infra 团队可以基于对上层模型算法特性的深度理解,进一步做 AI 工程上的软件优化,充分释放硬件潜能,在吞吐量、首 Token 延迟(TTFT)、每
在过去,训练一款高性能视觉大模型,往往需要承担高昂成本与复杂工程压力。9 月底,灵感实验室与 LMMs-Lab 联合推出的 LLaVA-OneVision-1.5 彻底改写了这一现状。这款具备视觉理解、图文对话能力的 8B 规模多模态模型,仅用 128 张 A800 GPU 4 天时间便完成预训练,且在公开基准测试中性能媲美顶级大模型,印证了「非堆量式」性能提升的技术价值。