- @zhangjiaoshou_


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
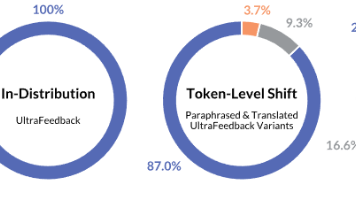
本文解读了论文《Why is Your Language Model a Poor Implicit Reward Model?》的核心发现。文章聚焦显式奖励模型(EX-RMs)和隐式奖励模型(IM-RMs)的泛化差距,通过理论分析和实验验证,指出IM-RMs因过度依赖表面文字线索,在文字表达方式变化(如释义、翻译)时表现较差,而EX-RMs更关注深层语义,泛化能力更强。同时,论文推翻了“IM-R
本文针对计算机类本科毕业设计论文的撰写需求,结合多所高校计算机学院规范及行业实践经验,提供系统化指导。指南先区分工程设计类(系统开发、软件实现)与理论技术研究类(算法优化、模型改进)论文,构建“问题提出-方案设计-实现验证-总结展望”的核心大纲框架,明确通用基础模块及两类论文各章节核心内容与撰写要求;再从各章节撰写技巧、格式规范(排版、图表、参考文献)、文献检索管理等维度梳理要点;最后聚焦质量提升

该综述以“配置使用流程”为框架,系统梳理了2022年至今35篇基于LLM的软件配置研究,清晰呈现了LLM在配置生成(提示增强为主)、验证(传统技术+LLM辅助)、运维(诊断修复闭环探索)三阶段的应用现状。研究发现,当前LLM已在网络配置、K8S配置等场景展现出实用价值,但仍面临泛化能力弱、可解释性差、依赖高质量资源等挑战。未来,需通过轻量微调、跨领域迁移学习、智能体闭环架构等技术,推动LLM从“特

本文解析《Is PMBOK Guide the Right Fit for AI?》一文,探讨传统项目管理框架PMBOK在AI项目中的局限性及改进路径。研究指出,AI项目的数据依赖性、迭代实验特性和伦理挑战对PMBOK提出新要求。论文通过案例分析和文献综述,提出在PMBOK中嵌入数据生命周期管理、混合开发模式和伦理考量的具体建议,为AI项目管理提供了“传统框架+AI适配”的实用解决方案。
本文是《基于大模型语义匹配的跨平台移动应用测试脚本录制回放》论文的快速理解指南,从标题、论文信息、核心总结到思维导图,层层拆解论文内容。先讲清跨平台测试的“多对多”映射和冗余难题,再解析LLMRR“录制+三层回放”的工作原理,最后用实验数据证明其优势——整体回放成功率最高68%,鸿蒙测试表现突出。通过案例和大白话,帮你快速抓住论文核心:LLMRR用“图文+大模型”的组合,解决了iOS/安卓/鸿蒙跨

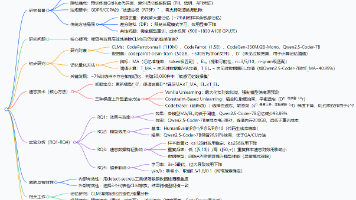
论文提出了一种创新的选择性遗忘方法,解决代码语言模型(CLMs)在预训练中记忆GitHub代码敏感信息(如邮箱、API密钥)的问题。不同于传统高成本的重训练或性能损耗大的差分隐私方法,CodeEraser通过区分代码中的敏感段与非敏感段,采用"梯度上升"遗忘敏感信息同时"梯度下降"强化有用代码知识,仅需对敏感段添加约束。实验表明,该方法能在Qwen2.5-C
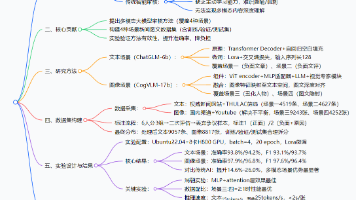
赵磊团队针对“人工内容审核效率低、易漏检”和“传统智能审核看不懂隐喻/讽刺、不会融合多模态信息”的痛点,提出了基于多模态大模型的内容审核方案:用ChatGLM-6b处理“负面文章”“负面文评”2类文本场景,用CogVLM-17b处理“丑化人物形象”“图文不良隐射”2类图像场景;同时构建了覆盖4大场景的新闻图文数据集(含9057条文本、8817张图像),通过Lora微调与实验验证,该方案在所有场景中
为解决真实Web应用攻击数据量小、差异性大及攻击载荷多样化导致大模型训练效果差的问题,提出基于联邦大模型的网络攻击检测方法(FL-LLMID)。首先,设计面向大模型微调的联邦学习网络,服务器对客户端本地模型的增量参数进行增量聚合,提升参数聚合效率并避免网络流量数据暴露;其次,构建CodeBERT-LSTM攻击检测模型,通过CodeBERT对应用层数据有效字段向量编码,结合LSTM分类,实现高效We

现代AI大模型依规模扩展定律持续扩容至近万亿参数,引发算法、硬件、工程领域多重困境,Transformer架构计算效率低、访存需求大的瓶颈凸显,还加剧了通用人工智能(AGI)路径争议。针对此,当前已形成注意力机制优化、低精度量化等算法改进方向,及集群并行、硬件DSA化等工程优化方向。同时,下一代计算范式正脱离“Next Token Prediction”核心,分为更高抽象层次预测(如Diffusi

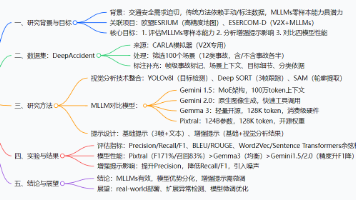
**摘要:**本研究针对交通监控中事故检测数据稀缺的问题,采用CARLA模拟器生成的DeepAccident数据集,评估了Gemini 1.5、Gemini 2.0、Gemma 3和Pixtral四种多模态大语言模型(MLLMs)的零样本检测能力。实验结合YOLO、Deep SORT和SAM构建增强提示,发现Pixtral表现最优(F1=71%,召回率=83%),Gemma 3性能最均衡。增强提示