- @yihuaixu


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
它不像一些通用AI那样只追求“像真照片”,而是特别擅长理解和控制各种艺术风格,让生成的图片更有创意、更漂亮、更符合设计师的审美。Krea-2 就是一个“懂美学、爱风格、生成快、创意足”的AI画图神器,尤其适合需要精确控制画面风格和氛围的创意工作者。想象一下,你告诉AI“画一个牛仔骑马”,它不仅能画出来,还能自动让画面看起来像电影海报、复古海报、插画、电影感照片,或者任何你想要的艺术风格。创意多样:

Z-Image(造相)是阿里巴巴通义实验室最新开源的一个强大且高效的图像生成模型,凭借轻量参数实现重量级模型的视觉质量,支持中英双语渲染并在消费级显卡上实现秒级出图。虽然简单的提示词也能生成,但依然建议生成前借助大模型,将你的需求提交给大模型,让大模型润色生成更详细的提示词再使用Z-Image来生成,这样效果会更好。注入了自然光影和真实质感,使生成的照片具有方向感强的光照、立体阴影、细腻皮肤纹理

今天分享的 Qwen-Image-2512 V2版 一键包基于阿里最新开源的 Qwen-Image-2512 的FP8量化版(同时支持BF16),支持消费级显卡最低12G显存流畅运行,支持更适合小白操作的WebUI模式和专业选手的ComfyUI两种模式。Qwen-Image-2512 是 Qwen-Image 文生图基础模型的 12 月更新版本,这是一个最新的文本生成图像模型,特点是 画面更真实、

LibreTranslate 不会经过任何第三方服务器,不仅免费、隐私安全,还支持多达 40 多种语言,是目前最轻量、最容易集成的本地翻译方案之一。同时支持文档翻译,切换到“翻译文件”选项,上传需要翻译的文档,支持.txt, .odt, .odp, .docx, .pptx, .epub, .html, .srt, .pdf等格式。今天分享的 LibreTranslate 一键包就完美的解决了以上

GOT-OCR-2.0 是一个基于通用 OCR 理论(General OCR Theory)的统一端到端模型,专注于提升光学字符识别(OCR)的准确性与效率。GOT-OCR 2.0 不仅支持场景文本识别,还能处理多页文档,为 OCR 领域带来更多灵活性。有了这个软件,大家不用再去苦苦寻找免费的ORC识别软件了,很多软件接口不稳定,随时可能失效。有了这个软件,本地一键运行,无需联网,永久免费。今天分

Qwen-Image-2.1 是一个“小巧但全能”的图像模型,把生成、透明图处理、多参考图编辑、局部精准修改都整合在一起,特别适合需要高效出图和灵活编辑的设计、电商和内容创作场景。图像编辑选项卡“自定义尺寸”参数,默认关闭,即编辑后的图像保持“参考图1”的尺寸,如果开启,则支持自定义编辑后的尺寸,请手动设置,建议参考或接近“参考图1”的尺寸,否则会出问题。更高级的采样器通常所需步数较少。启动Web
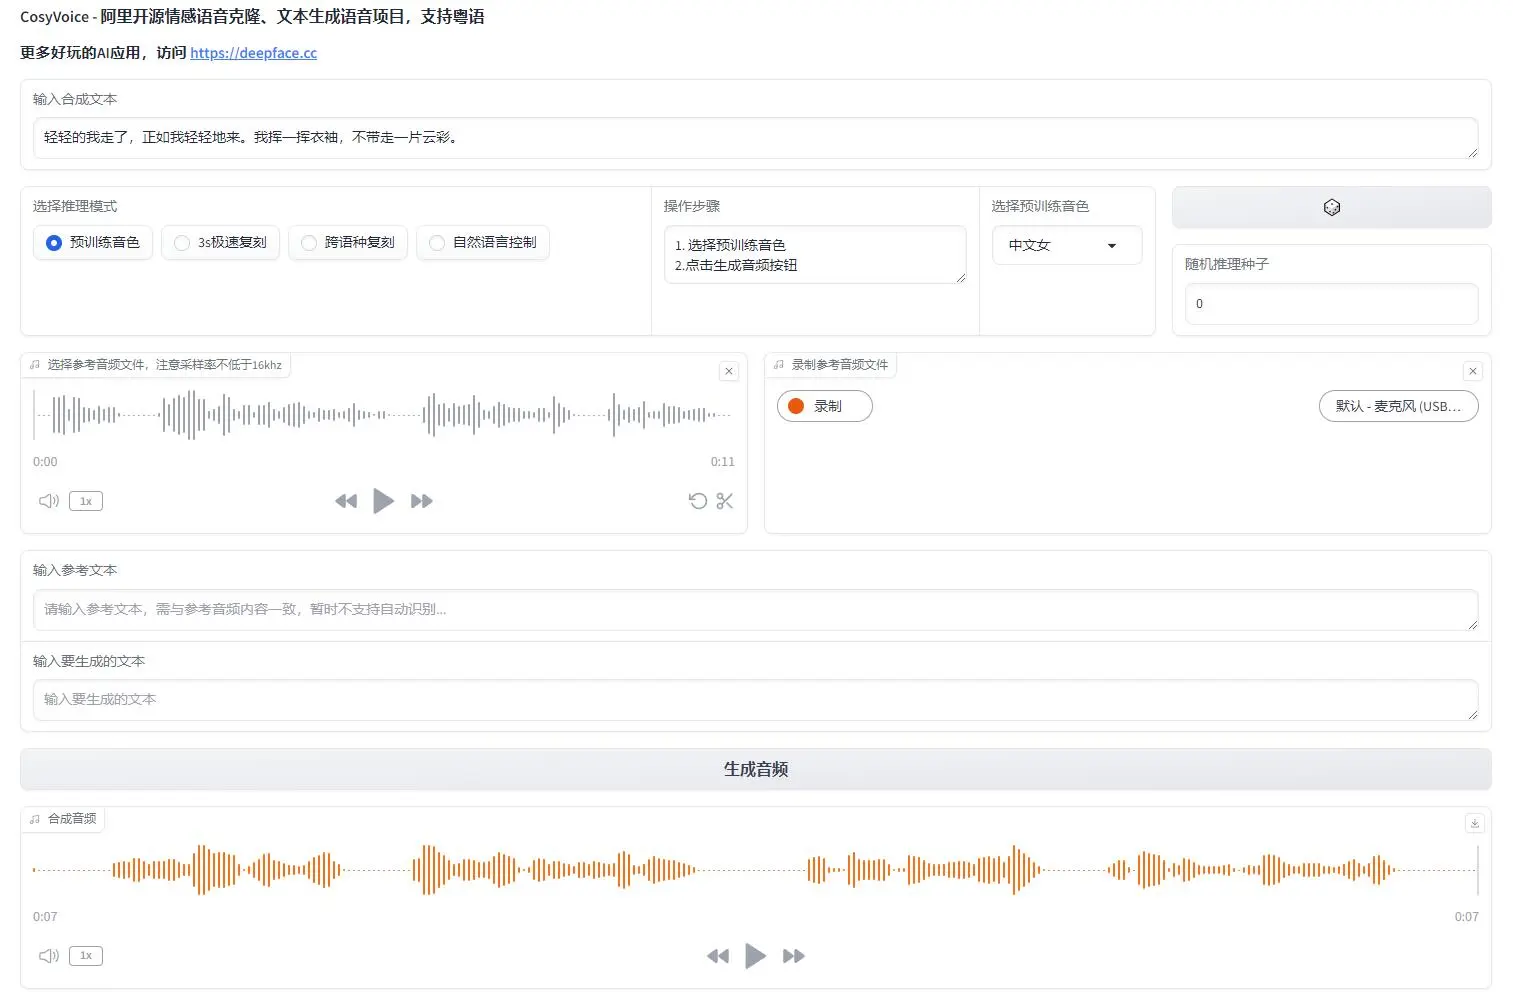
CosyVoice专注自然语音生成,支持多语言、音色和情感控制,支持中英日粤韩5种语言的生成,效果显著优于传统语音生成模型。
想让 Wan2.2 生成你心中的画面?关键在提示词怎么写。本文将带你掌握文生视频 Prompt 写作技巧,建议收藏+关注!提示词公式提示词用来描述视频中所包含的内容和运动过程,它是控制视频画面内容与效果的关键因素。提示词描述越完整、精确和丰富,生成视频的品质越高,且越贴近期望生成的内容。为了帮助你更快上手,我们针对不同的使用需求提供了两种典型公式:基础公式适用于初次尝试AI视频的新用户,及将AI视
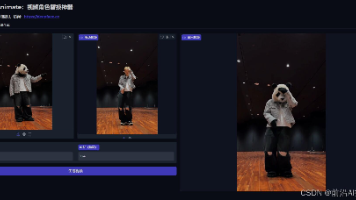
你只需要两样东西:一段原始视频(驱动视频)、从这段视频里抽出一帧,用图像编辑工具把里面的角色“画”成你想要的样子(比如换成另一个人、动物、机器人、飞机等),模型就会自动把整段视频里的角色都替换成你画的那个新角色,同时完整保留原来的动作、镜头运动和时序。和同类角色动画生成软件不同,Viggle-Animate的参考图需要把你的角色重绘到驱动视频的某一帧上(相同背景、接近的姿态和站姿),再用它作为参考
5月14日,腾讯旗下混元文生图大模型(下称:混元DiT,Scalable Diffusion Models with Transformers)宣布全面升级并对外开源,目前已在 Hugging Face 平台及 Github 上发布,包含模型权重、推理代码、模型算法等完整模型,可供企业与个人开发者免费商用。腾讯混元文生图负责人卢清林表示,混元DiT开源的价值有两方面,一方面这是业内首个中文原生Di