


- @weixin_44768475


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
目录机器学习定义监督学习机器学习定义计算机程序从经验E中学习,解决某一问题T,进行某一性能度量P,通过P测定在T上的表现因经验E而提高。监督学习回归问题(预测值连续)分类问题(预测值离散)...
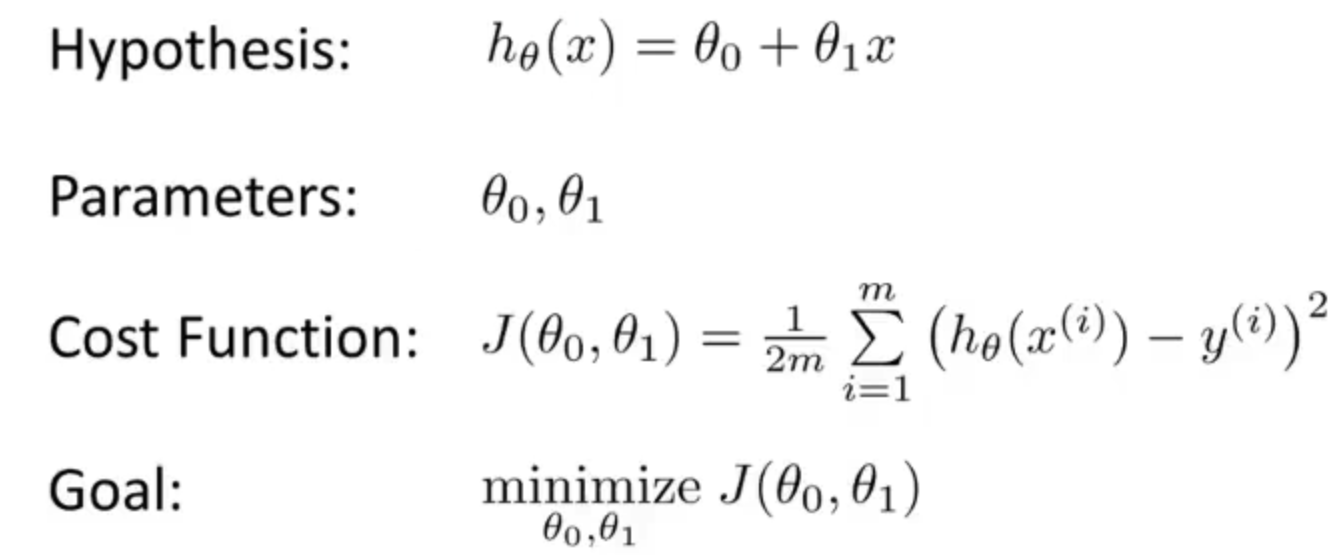
想象你在读一句话:“The journey of a thousand miles begins with a single step.”当你读到 “journey” 这个词时,你并不是只看它本身,而是会联系 “The”、“of”、“miles”、“begins” 等所有词,理解整句话的意思。自注意力机制就是让计算机也这么做:👉 为每个词,根据它和句子中所有词的关系,重新生成一个“融合了上下文信
层归一化可以确保每个层的输出具有一致的均值和方差,从而稳定训练过程。 残差连接是通过将一层的输出直接传递到更深层来跳过一个或多个层的连接,它能帮助缓解在训练深度神经网络(如大语言模型)时遇到的梯度消失问题。 作为 GPT 模型的核心模块组件,Transformer 块融合了掩码多头注意力模块和使用 GELU激活函数的全连接前馈神经网络。 GPT 模型是具有许多重复 Transformer
第五章让模型"会说话"(预训练接龙)第六章让模型"会判断"(分类打标签)第七章让模型"会对话"(指令生成回复)三章连起来,就是从"文盲"到"专家"再到"助手"的完整成长路径。
第五章让模型"会说话"(预训练接龙)第六章让模型"会判断"(分类打标签)第七章让模型"会对话"(指令生成回复)三章连起来,就是从"文盲"到"专家"再到"助手"的完整成长路径。
▎ 模型是智能体(代理)的推理引擎。它们驱动智能体的决策过程,决定调用哪些工具、如何解释结果以及何时提供最终答案。接续上一讲"代理"的内容就很好理解了:如果说代理是"一个人",那模型就是这个人的"大脑"。代理之所以能"想了再做、做完再想"地循环,背后真正在"想"的就是模型。你选的模型有多强,代理就有多靠谱。
▎ 代理将语言模型与工具相结合,创建能够推理任务、决定使用哪些工具并迭代地寻找解决方案的系统。翻译成大白话:普通的 LLM 只能"动嘴"——你问它答,它不能真正去查数据库、查天气、做计算。代理 = 一个会"动手"的 LLM。它接到任务后,会自己想"我该用哪个工具?"→调用工具 → 看结果 → 再想下一步 → ……直到能给你最终答案。▎ LLM 代理在一个循环中运行工具以实现目标。代理持续运行,直到
▎ 消息是 LangChain 中模型上下文的基本单元。它们代表模型的输入和输出,携带与 LLM 交互时表示对话状态所需的内容和元数据。翻译成大白话:你和模型聊天时,每一句话、模型每一句回复,在 LangChain 里都是一个"消息对象"。模型自己没有记忆,所谓"多轮对话",本质上就是把一堆消息排成列表喂给它。LangChain 提供了适用于所有厂商的标准消息类型,换模型不用改消息代码。
自定义名称@tool("web_search") # 自定义名称自定义名称 @tool("web_search") # 自定义名称 def search(query : str) - > str : """Search the web for information.""" return f"Results for: {