


- @weixin_42258782


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文介绍 Parallelization(并行化模式)的原理与工程实现,重点分析 Fan-out / Fan-in、Sectioning、Voting、任务依赖、上下文隔离、并发控制及部分失败处理。结合采购合同并行分析案例与 Java CompletableFuture 代码,说明如何实现独立任务的并发执行、结构化结果汇总和证据校验。同时介绍 LangGraph 动态任务分发、OpenAI 并行

AI 可以帮助架构师快速分析现有系统、生成候选方案、比较技术路线,并通过 Coding Agent 辅助完成 PoC 验证,但生成的方案不一定适合实际项目。本文以 BaseMetas 云文档的离职成员文件交接为例,对比同步处理、异步分批和消息驱动三种方案,介绍如何结合业务约束、系统架构、数据一致性及交付要求开展技术验证和多角色评审,并提供可直接复用的技术方案评审清单。

本文介绍 DeepSeek 最新发布的 Super-agent 架构,重点分析 Router/Worker 双层设计、事件驱动、任务路由、Thread Subscription、上下文管理、异步执行与持久化机制,并结合开源原型和官方实验数据,评估其在多任务并发、持续运行和任务协调方面的优势与局限。同时对比 Pi、LangGraph、AgentScope 等主流方案,探讨 Super-agent 的

结合一次真实使用经历,本文梳理 Codex 重置卡、自动重置、套餐续费与额度恢复之间的关系。重点说明:ChatGPT 套餐续费主要保证订阅继续有效,并不等于 Codex 额度立即恢复;手动 Reset 会刷新 Codex 使用周期,并可能改变后续重置时间;正常周期重置或官方 Global Reset 则可能让剩余额度直接恢复到 100%。同时解释 Usage Cycle、Weekly Reset
DeepSeek发布V3.2-Exp实验模型,引入原创DeepSeek稀疏注意力(DSA)技术,通过"闪电索引器"智能筛选关键Token,将计算复杂度从O(L²)降至O(L·k)。该技术使长文本处理速度提升2-3倍,内存占用降低30-40%,API调用成本下降超50%,同时保持与V3.1-Terminus相当的性能。作为迈向新一代架构的关键步骤,DSA采用三阶段训练策略平衡效率

本文深入解析大模型能力的核心基础——预训练过程及其关键"预训练目标"。预训练作为大模型的"通识教育"阶段,通过海量无标注数据训练,使模型掌握语言规律和世界知识。文章系统阐述了预训练的重要性:知识压缩存储、通用语言表示习得、先验知识提供及能力涌现的基础。重点剖析了各类预训练目标(自回归、自编码、混合目标等)的技术特点及其对模型能力的塑造作用,并梳理了代表性模型
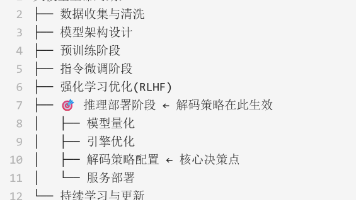
本文系统解析了大模型推理生成中的解码策略技术。解码策略作为连接概率分布与文本序列的"决策引擎",其核心作用包括:1)控制生成质量,平衡连贯性与多样性;2)优化计算效率,处理指数级搜索空间;3)适配不同应用场景。当前主流策略包括贪心搜索、束搜索、Top-k/p采样等,各有其适用场景和优化技巧。技术演进呈现三大趋势:推测解码加速生成、并行解码范式革新、垂直场景精细优化。国内外主流模
AI推理时代的数据存储挑战与上下文学习技术演进 随着AI应用从训练转向推理,多模态生成内容(如图片、视频)导致数据需求呈指数级增长,存储需求可能提升数十至数百倍。大模型规模扩展受限于HBM和GPU资源,使上下文学习(ICL)成为下游任务适配的关键技术。ICL作为推理阶段的元学习手段,通过动态构建输入上下文来引导模型行为,其技术体系涵盖输入优化、推理增强和评估校准三层架构。行业趋势显示,从模型微调转

大模型正从聊天问答走向自主决策的智能体(Agent),但开发者面临知识碎片化、缺乏系统路径的困境。本系列从工程视角出发,围绕Agent原理、工具调用、设计模式、MCP、Agent Harness及生产级治理,为前端与后端开发者提供一条从基础到落地的完整学习路线,助你真正掌握可稳定运行的企业级智能体系统。
AI Agent的深入解析:超越大模型与工具调用的系统思维 传统认知将AI Agent简化为"大模型+工具调用",这仅能解释基础功能却无法说明现实差异。本文揭示了Agent作为目标驱动系统的本质,提出五层架构模型: 目标与指令层:明确任务契约与执行规则 模型与决策层:动态认知资源与灵活规划机制 上下文与记忆层:信息选择与管理系统 工具执行层:结构化能力调用与受控环境 反馈评估层
