


- @wangwangstone


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
colab ,上有python2和python3的环境,很多包都已经装好了。在谷歌云盘上,方式1:直接新建文件项目,先上传一个.ipynb在更改“云端硬盘”--》“新建”--》“文件夹”,命名--》自己上传一个文件夹,“新建”(上传文件.ipyb)--》点击文件,右击“打开 方式”--》关联到应用--》“Colab ”这样就打开了文本ipynb文件。如果更改python运行环境版本...
做特征工程时,利用pyspark 将数据处理后保存为tfrecord以供后续的模型训练。本文给一个保存为tfrecord 和对tfrecord进行解析的案例。
fatal: unable to access 'https://github.com/xxx/project.git': Failed to connect to 127.0.0.1 port 54427: Connection refused
添加国内镜像以解决报错:Could not find a version that satisfies the requirement numpy (from versions: )No matching distribution found for numpy
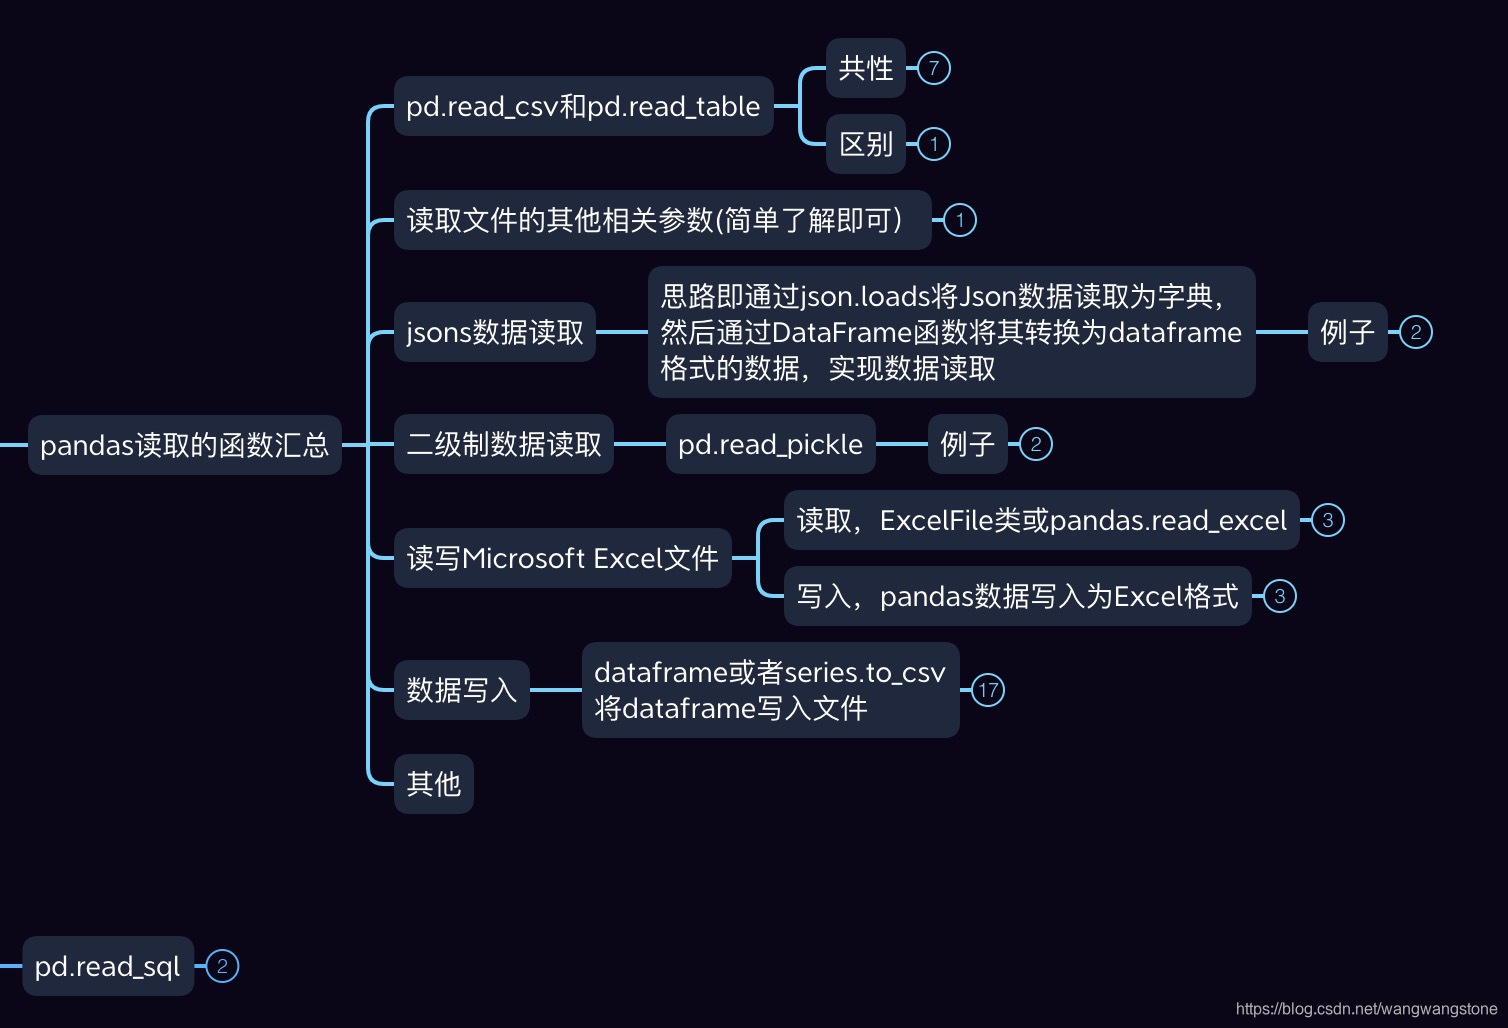
本文是对 《利用Python进行数据分析》中关于数据读取的回顾性总计笔记,包含代码注释等。
在jupyternote book中,当dataframe数据的列数或行数很多时,默认为了减少显示的面积会只能显示其中部分列或行的数据。本文记录如何将数据显示完全和如何复原默认操作。问题: 列或行显示不全如:列显示不全解决方式:pd.set_option('display.max_columns', None)#显示所有列pd.set_option('display.max_columns', N
pandas函数中pandas.DataFrame.from_dict 直接从字典构建DataFrame 。参数解析DataFrame from_dict()方法用于将Dict转换为DataFrame对象。 此方法接受以下参数。data: dict or array like object to create DataFrame.data:字典或类似数组的对象来创建DataFrame。orient
pyspark 从已有数据表读取数据写入目标hive表的代码模板
工作中看代码时遇到lateral view explode(split(sni_type,',')) snTable as sni_info ,初看挺一脸懵逼的,细查之后才明白是对字段sni_type进行分割之后,将分割后中的元素值转换为了多行。具体:split()函数split()函数用于分割数据。语法格式为split(str,sep) ,参数str为字符串类型的字段,sep为分割符(支持正则)
工作中常会需要去对比两个表中某些数据的不同。以及关于join的操作。这里将遇到的记录一下。比较两个表的不同left Join 保证了左表的数据一定会存在,对于这类查Diff的场景很合适下面这个语句可以查出来T2中比T1新增的列与数据key表示连接的关键值,唯一信息的那一列,例如用户ID之类SELECT * FOROM T1LEFT JOINSELECT * FROM T2ON T1.key = T