- @sinat_33087001


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
其实无论是SOLID、还是KISS、YAGNI、DRY以及LOD,都是服务于写出高质量代码。简单而言就是写出:可维护性、可读性、可扩展性、灵活性、简洁性(简单、复杂)、可复用性、可测试性强的高质量代码。可读性、可维护性的一个基本设计就是写出高内聚、低耦合的代码,其中SRP服务于高内聚,ISP和LOD服务于低耦合。毋庸置疑OCP服务于代码的扩展性,LSP和DIP场景就比较具体了:LSP用于指导父子关
SRP原则侧重高内聚,指导类功能的设计要单一,LOD法则侧重低耦合,指导类间依赖关系要松耦合,ISP原则是从调用者的角度出发确保接口的设计具备对调用者有良好的隔离性。基于接口而非实现编程思想也是从调用者的角度出发确保稳定的依赖和可插拔的实现。总的来说SRP原则、ISP原则、LOD法则以及基于接口而非实现编程思想的目标都是实现代码的高内聚低耦合,提高代码的可扩展性、可读性和可维护性。
面向对象分析英文缩写是 OOA,全称是 Object Oriented Analysis;面向对象设计的英文缩写是 OOD,全称是 Object Oriented Design;面向对象编程的英文缩写是 OOP,全称是 Object Oriented Programming。OOA、OOD、OOP 三个连在一起就是面向对象分析、设计、编程(实现),正好是面向对象软件开发要经历的三个阶段,想想之前为
dp[i ][j ]表示「以第 i 行、第 j 列为右下角的正方形的最大边长」为何不是 dp[i][j],回到图解中,任何一个正方形,我们都「依赖」当前格 左、上、左上三个方格的情况,但第一行的上层已经没有格子,第一列左边已经没有格子,需要做特殊 if 判断来处理,为了代码简洁,我们 假设补充 了多一行全 ‘0’、多一列全 ‘0’
KISS 原则讲的是“如何做”的问题(尽量保持简单),它的目的是提升代码的可读性、可维护性,而 YAGNI 原则说的是“要不要做”的问题(当前不需要的就不要做),它的目的是降低代码的冗余度,提升代码的可维护性。DRY原则说的是不要做重复的事,它的目的是减少代码量,提高代码的可读性、可维护性。除此之外,复用已经经过测试的老代码,bug 会比从零重新开发要少,也就提高了代码健壮性。所以要有代码复用意识
DDD从代码上的区别很小,就是对Service层进行重新设计并将BO升级为Domain,但是从设计和思维模式上区别很大,它是一套自底向上的面向对象思维方式和开发流程,能让我们从业务建模的视角去看问题。从可读性上来说:它可以把原来最重的service逻辑拆分并且转移一部分逻辑,可以使得代码可读性略微提高,另外,模型充血以后基于模型的业务抽象在不断的迭代之后会越来越明确,业务的细节会越来越精准,通过阅

说到面向对象设计思想,看似每个学习Java语言的人入门时都知道,类、对象等概念也耳熟能详,但是每个人对面向对象这种设计思想理解是千差万别的,就拿我来说,16年读研时初一学习Java时只知道:面向对象开发有类、对象、成员变量、方法等,学会了基本语法,然后死记硬背会了抽象类和接口的区别、类之间的关系,根本不清楚为啥有抽象类,它和接口到底啥区别,为啥有普通类了还要它?甚至说多态是啥意思都没能深入理解,以
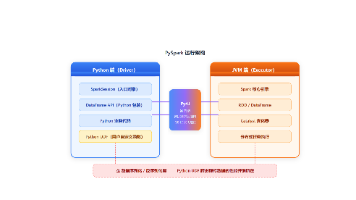
本文为Python开发者提供PySpark的快速入门指南,涵盖以下核心内容: Spark基础 分布式计算引擎,解决单机处理TB/PB级数据的瓶颈 统一批处理、流处理、图计算和机器学习四大场景 PySpark架构 Python作为交互层调用JVM端的Spark核心引擎 通过Py4J桥通信,优先使用内置函数减少跨进程开销 关键对比 Pandas:单机内存级数据处理 PySpark:Python生态+分
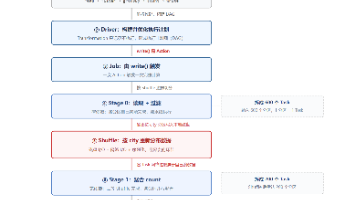
摘要 PySpark代码通过懒执行机制构建执行计划,直到遇到写入等Action操作时才触发计算。Driver将逻辑计划转化为物理计划,拆分为Job、Stage和Task层级。数据按Partition分布,Task在Executor上并行处理。Shuffle是跨节点数据重分布的关键环节,性能开销最大。生产环境优先选用DataFrame API以获得最佳性能优化。整个流程从代码解析到分布式执行,体现了
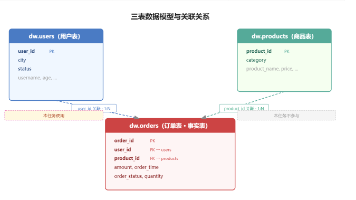
本文介绍了使用PySpark DataFrame API完成从数据读取到写出的完整流程。通过电商平台用户消费分析案例,演示了以下关键步骤: 创建SparkSession并配置Paimon Catalog 从Paimon表读取用户和订单数据 数据清洗(过滤活跃用户、有效订单) 聚合计算(用户级和城市级聚合) 多表关联(inner/left join选择) 空值处理与去重 结果写出到Paimon表和P