- @qq_61024956


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
(注意里边的两个安装目录,如果你修改了安装目录或者和我不一样,一定要自己修改,同时检查环境变量中的目录地址是否正确的指向了bin目录)我将mysql5.6-windows版本的解压包放到了上方的连接当中,如若不想使用我提供的安装包大家还可以在官方网站自行下载。点击新建,然后进入到你安装的mysql的位置的bin目录当中,将地址复制到新建的变量中,然后点击确定。如果搜索不了,可以点开上方的系统,接着

日志文件 → Python → KEYWORDS → 钉钉外部终端 → TCP地址 → SSH 22端口钉钉机器人;Webhook和Secret;测试日志;Python日志监控脚本;关键词匹配;钉钉Markdown告警;虚拟环境;requests;手动运行测试;systemd开机自启;cpolar;SSH随机TCP;固定TCP。发现异常 → 收到通知 → 远程登录处理的轻量运维链路。
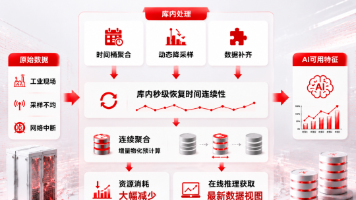
工业AI落地的核心瓶颈不在于算法迭代,而在于底层数据架构无法适配时序化、关联化、实时化的业务需求。传统分散的数据架构导致数据治理成本高、AI模型输入维度缺失、推理精度不足,是行业普遍痛点。金仓KES TimeSeries以原生多模融合架构为核心,通过内核级写入、存储、计算优化,搭配库内一站式数据治理能力,打通时序、关系、空间、向量数据壁垒。无需搭建多套异构系统、无需复杂ETL开发,即可为工业监测、
大模型推理是AIGC落地的关键。但推理往往面临性能瓶颈:延迟高、吞吐量低、显存占用大……cann-recipes-infer就是CANN提供的推理优化样例集,展示了如何在NPU上实现高效的模型推理。覆盖主流模型提供完整推理代码多种优化技术可以直接使用简单说,就是推理优化的"实战手册"。覆盖主流LLM和多模态模型提供多种优化技术完整的推理代码性能测试工具对于在NPU上实现高效推理,cann-reci
本人测试了“”模型,该模型对于文学领域的处理是十分不错的,由于模型参数量较小,没有对逻辑分析领域进行测评,至于3.11和3.8谁大的问题,对于0.3B的模型来说是可以接受的,毕竟当初GPT那么大的参数还会出错。本人测评水平有限,如有更好的测评思路,还请各位大佬指正。
ShardingSphere是一套开源的分布式数据库中间件解决方案组成的生态圈,它由Sharding-JDBC、Sharding-Proxy和Sharding-Sidecar(计划中)这3款相互独立的产品组成。他们均提供标准化的数据分片、分布式事务和数据库治理功能,可适用于如Java同构、异构语言、容器、云原生等各种多样化的应用场景。ShardingSphere定位为关系型数据库中间件,旨在充分合
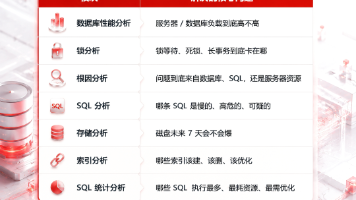
数据库性能故障的核心排查难点,从来不是“发现异常”,而是厘清异常之间的因果关系、锁定底层核心根因。传统碎片化排查模式,无法适配复杂线上场景的故障排查需求。全链路一体化数据库故障诊断框架,通过统一时间轴联动、锁事务链路还原、多维度根因溯源、SQL索引精细化分析,打通各个诊断模块的数据孤岛,形成一条连续可下钻的分析链路。整套体系并非简单叠加监控功能,而是实现多维度诊断能力深度协同,让排障跳出零散指标与
工业AI落地的核心瓶颈不在于算法迭代,而在于底层数据架构无法适配时序化、关联化、实时化的业务需求。传统分散的数据架构导致数据治理成本高、AI模型输入维度缺失、推理精度不足,是行业普遍痛点。金仓KES TimeSeries以原生多模融合架构为核心,通过内核级写入、存储、计算优化,搭配库内一站式数据治理能力,打通时序、关系、空间、向量数据壁垒。无需搭建多套异构系统、无需复杂ETL开发,即可为工业监测、
ShardingSphere是一套开源的分布式数据库中间件解决方案组成的生态圈,它由Sharding-JDBC、Sharding-Proxy和Sharding-Sidecar(计划中)这3款相互独立的产品组成。他们均提供标准化的数据分片、分布式事务和数据库治理功能,可适用于如Java同构、异构语言、容器、云原生等各种多样化的应用场景。ShardingSphere定位为关系型数据库中间件,旨在充分合
医疗信创不是简单的技术替换,而是医疗服务模式、管理体系、数据架构的全方位升级。北京积水潭医院贵州医院依托金仓数据库完成双院区全栈国产化落地,证明国产技术完全可以承载国家级区域医疗中心的核心业务,为全国多院区大型医院信创改造、智慧医疗建设提供了宝贵的实战范本。未来,国产化数字底座将成为优质医疗资源普惠共享、医疗行业高质量发展的核心隐形支撑。