- @qq_56908984


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
FACT提出一种多模态力-动作-轨迹基础模型,通过大规模人类操作数据(EgoForce)实现从视觉到触觉条件动作的联合生成。其核心创新在于将未来接触力设为生成变量,与动作共同去噪、相互约束,构建“前瞻性视觉规划+反应式触觉细化”的联合生成框架。在100小时机器人微调数据下,7项任务平均成功率41.4%,显著优于基线。该方法有效融合视觉运动规划与触觉反馈,推动人到机器人的灵巧操作迁移。

MimicAgent提出一种基于大语言模型的四足机器人技能生成框架,通过自然语言提示生成运动参考轨迹,并结合示例引导强化学习(DAgger)与物理仿真,实现复杂动作如翻滚、腾空等的可执行控制。其核心创新在于将任务意图转化为可接受的运动学参考,而非直接优化奖励函数,有效缓解高动态技能中奖励设计难题。通过多智能体协同生成、单元测试自修复与相位化轨迹表示,提升轨迹生成效率与语义对齐率,在真实机器人上验证

SONIC提出一种通用人形机器人全身控制框架,通过大规模运动跟踪学习可执行的运动先验。其核心是将异构输入(如动捕、VR、视频、语言)统一编码为64维运动token,经共享控制策略生成稳定关节目标。采用PPO强化学习与有限标量量化(FSQ)实现高效训练,支持多模态任务泛化。实验表明,该方法在611小时动捕数据上实现跨动作类别的强泛化能力,显著优于传统端到端或任务特定方法,为真实机器人提供统一、可扩展

SuperMimic提出一种基于可微世界模型的高效人形机器人全身控制方法,通过在真实仿真中持续采样、迭代更新动力学模型,并利用短时域反向传播(BPTT)与终端价值网络优化策略,显著降低训练成本。相比传统PPO等方法,其在1×H100下仅需3小时即可完成超大规模动作库(12.9万条)的训练,计算开销仅为SONIC的千分之一,同时实现高成功率与真机演示(如跳跃、翻转)。该框架不依赖可微仿真器,兼顾物理

Ψ₀ 是一项面向通用人形机器人移动操作的开放基础模型,提出分阶段学习框架:利用829小时人类第一视角视频预训练视觉-语言表征,结合31小时真实人形机器人示范学习动作分布,再以少量任务内示范快速适配。系统采用三层级架构——视觉语言主干(Qwen3-VL)、多模态扩散动作专家(MM-DiT)与强化学习下肢跟踪控制器(AMO),实现长时序、全身协调操作。在Unitree G1上完成8项多步骤任务,成功率

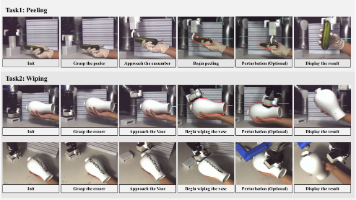
本文提出Reactive Diffusion Policy(RDP),针对接触丰富操作中长时序一致性与高频闭环反应的矛盾,创新性地结合TactAR遥操作系统与慢-快双策略架构。TactAR通过增强现实实时呈现触觉/力反馈,显著提升示范数据质量;RDP则分离慢策略(建模复杂动作块)与快策略(基于触觉高频修正),实现高精度、强鲁棒的接触控制。延伸工作ImplicitRDP进一步融合结构化学习,推动视觉
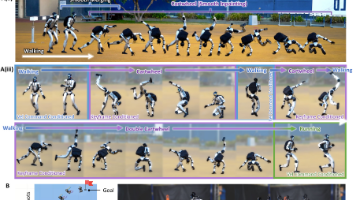
本文提出BeyondMimic,一种基于引导扩散的多功能人形机器人控制框架。通过统一的PPO运动跟踪策略学习人体动作,并结合失败率自适应采样提升长序列训练效率;进一步利用DAgger蒸馏与条件VAE构建平滑潜空间,训练联合状态-动作扩散模型。推理时,通过可微任务代价引导生成未来轨迹,实现无需重训练的在线规划,支持速度指令、路点到达、避障等复杂任务,已在Unitree G1上验证其真实世界泛化能力。
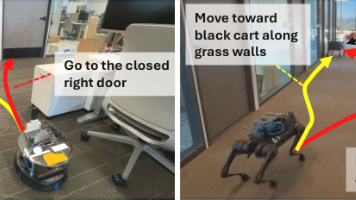
OmniVLA提出一种统一的全模态视觉-语言-动作模型,解决机器人导航中语言、位姿、图像等多模态目标表达不一致的问题。通过随机模态丢弃与注意力掩码,实现异构数据联合训练,支持单模态或跨模态组合输入。基于OpenVLA与轻量级OmniVLA-edge,覆盖9,500小时多平台数据,验证了跨机器人迁移、新模态微调及复杂指令理解能力,推动导航策略向通用化、灵活化发展。
VLA模型通过融合视觉、语言与动作,实现互联网知识向机器人控制的迁移。从2022年SayCan的语义规划到RT-2的动作离散化,再到π₀、FAST等引入连续动作建模与多时间尺度控制,技术演进聚焦于统一语义推理与实时运动控制。核心突破包括动作token化、条件调制FiLM、Diffusion与Flow Matching建模,以及分层架构与在线学习的结合。未来趋势是“慢语义+快控制+强稳定”的协同系统
C++面试核心要点摘要(148字) 本文系统梳理C++面试核心知识点,涵盖:1)基础语法(const/static/指针引用区别);2)面向对象(多态实现/虚函数表/菱形继承);3)内存管理(RAII/智能指针/深浅拷贝);4)STL容器(vector扩容/unordered_map原理);5)多线程(线程安全/锁机制);6)设计模式(单例/工厂模式实现);7)编译链接(符号解析/内存布局);8)