


- @qq_36372352


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
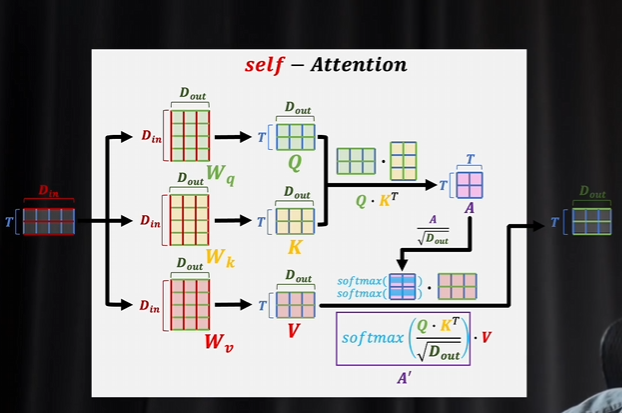
第一个是在解码器里面,这个注意力上会加一个掩码,就是因为在推理的时候,解码器部分是一个词一个词生成的这就代表了你生成到某个词的时候,这个词它只能受到它之前词的影响,不应该被未来生成的词所决定。维度它是每一个输出的维度,再乘以头的个数,然后最后得到这个结果以后,还会再和一个W矩阵相乘,再得出一个输出的词向量。多头注意力机制比卷积神经网络它有更大的可能性,它不再局限于卷积核,必须是围绕一个中心的,是可
这个命令会从远程仓库获取最新的分支和数据,但不会自动合并或修改你的本地工作。替换为实际的分支名。这样你就可以在本地工作与远程分支相对应的内容了。是远程仓库的默认名称。如果你的远程仓库有不同的名称,请相应地替换。假设你想要拉取的远程分支名为。,并且你想要创建的本地分支名为。的新分支,并自动将其与远程分支。确保在使用这些命令时,将。这个命令会创建一个名为。
如果你只是想修改最后一次提交的信息(比如提交信息写错了),你可以使用:这将打开你的默认文本编辑器,允许你编辑提交信息。如果你想同时修改提交的内容(比如忘记添加了某些文件,或者不想包含某些文件),你可以先用git add或git reset来更新暂存区,然后再运行。
因为如果不清零,梯度会累加到已有的梯度上,这是PyTorch的设计决策,目的是为了处理像RNN这样的网络结构,它们在一个循环中多次计算梯度。在神经网络中,损失函数衡量的是模型输出与真实标签之间的差异,通过反向传播算法,可以计算出损失函数关于模型各个参数的梯度。梯度指示了损失函数增长最快的方向,因此通过向相反方向调整参数,模型的预测误差会逐渐减小。: 反向传播是一种有效计算梯度的算法,它首先计算输出

栈这种结构只能在一侧(栈顶那一侧)进行插入和删除操作,而且是后进先出LIFO(后进入栈的元素离栈顶比较近,先出来),允许进行插入和删除的那一端是栈顶,与之对应的另一端是栈底, 如果一个栈不包含任何元素,这个栈被称为空栈。栈的操作实际上和洗盘子的过程是类似的,洗盘子的过程中,会拿出待清洗那一摞盘子的最顶端的那个盘子,清洗之后将其放在已清洗区域,这对于待清洗盘子来说是出栈,对于已清洗区域来说,是入栈(
假设有一张全球的高精度地图,定位的任务是确定车辆在这张高精度地图上的位置。gps精度在1到3米,由于不能完全信任gps,必须找到另一种方法来准确的确定车辆在地图上的位置。最常用的方法是将所看到的内容和地图上显示的内容进行比较车辆坐标系和地图坐标系可能均取决于手机导航系统中的设置。无人驾驶软件必须将传感器的测量值从车辆坐标系转换到地图坐标系,解决转换问题是定位问题的关键步骤。

自回归模型(Autoregressive Model, AR模型)是时间序列分析中的一种基本模型,其核心思想是当前观测值可以通过其过去的若干个观测值的加权和来预测,其中的权重参数由数据自身决定。数学上,一个自回归模型可以表示为:Xtcϕ1Xt−1ϕ2Xt−2⋯ϕpXt−pϵtXtcϕ1Xt−1ϕ2Xt−2⋯ϕpXt−pϵtXtX_tXt) 是在时间 (ttt。

借鉴了多层神经网络的思想pointnet要么是一个点,要么是所有点进行操作,就不会有局部上下文信息pointnet++基本思想是迭代地应用到局部区域1.多级别特征学习2.旋转不变性3.置换不变性选取中心点centroid,通过pointnet学到这个小区域的全局特征采样:选取centroid(sample centroids)分组:以centroid为中心,选取局部的点(group points