


- @qq_35273499


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
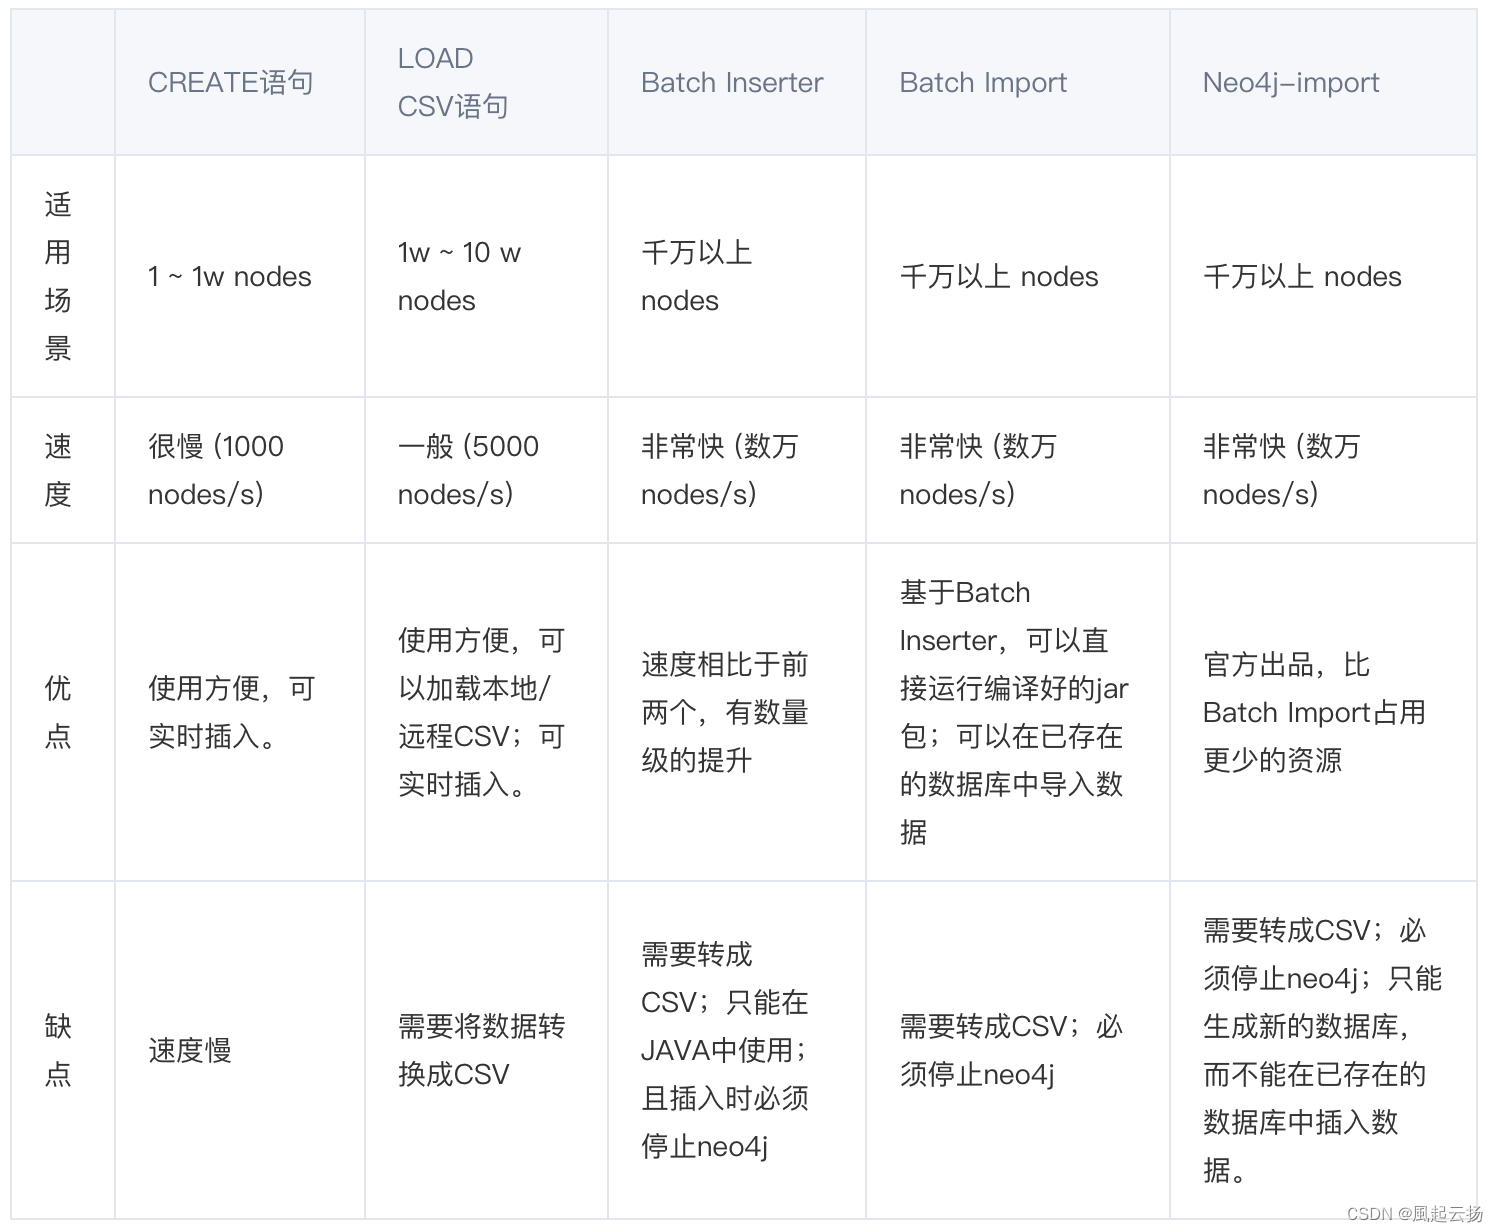
大量三元组数据需要导入到neo4j图数据库时,有几种方式进行数据导入
作者:肖仰华,复旦大学计算机科学技术学院,副教授,博士生导师,上海市互联网大数据工程技术中心副主任。主要研究方向为大数据管理与挖掘、知识库等。大数据时代的到来,为人工智能的飞速发展带来前所未有的数据红利。在大数据的“喂养”下,人工智能技术获得了前所未有的长足进步。其进展突出体现在以知识图谱为代表的知识工程以及深度学习为代表的机器学习等相关领域。随着深度学习对于大数据的红利消耗殆尽,深度学习模型效果
作者丨徐阿衡学校丨卡耐基梅隆大学硕士研究方向丨QA系统实践了下怎么建一个简单的知识图谱,两个版本,一个从 0 开始(start from scratch),一个在 CN-DBpedia 基础上补充,把 MySQL,PostgreSQL,Neo4j 数据库都尝试了下。自己跌跌撞撞摸索可能踩坑了都不知道,欢迎讨论。1. CN-DBpedia 构建流程知识库可以分为两种类型,一种是以 Freebase,
文本分类任务是自然语言处理中最常见的任务之一。文本分类简单定义来说就是对给定的文本,可以是一句话、一段文本、一篇文章利用文本分类器进行分类和打标签。文本分类任务广泛应用于长短文本、情感分析、新闻分类、事件类型分类、政务信息分类、商品类型分类、文章类型分类、论文类别、专利领域、案件描述、罪名分类、意图分类、论文专利分类、邮件自动分类、评论类型分类、药物反应分类、对话分类、税收分类、投诉分类、广告检测

作者:肖仰华,复旦大学计算机科学技术学院,副教授,博士生导师,上海市互联网大数据工程技术中心副主任。主要研究方向为大数据管理与挖掘、知识库等。大数据时代的到来,为人工智能的飞速发展带来前所未有的数据红利。在大数据的“喂养”下,人工智能技术获得了前所未有的长足进步。其进展突出体现在以知识图谱为代表的知识工程以及深度学习为代表的机器学习等相关领域。随着深度学习对于大数据的红利消耗殆尽,深度学习模型效果
1. 比赛介绍这是一个文本多分类的问题:目标是“参赛者根据知乎给出的问题及话题标签的绑定关系的训练数据,训练出对未标注数据自动标注的模型”。通俗点讲就是:当用户在知乎上提问题时,程序要能够根据问题的内容自动为其添加话题标签。一个问题可能对应着多个话题标签,如下图所示。这是一个文本多分类,多label的分类问题(一个样本可能属于多个类别)。总共有300万条问题-话题对,超过2亿词,...
作者:肖仰华,复旦大学计算机科学技术学院,副教授,博士生导师,上海市互联网大数据工程技术中心副主任。主要研究方向为大数据管理与挖掘、知识库等。大数据时代的到来,为人工智能的飞速发展带来前所未有的数据红利。在大数据的“喂养”下,人工智能技术获得了前所未有的长足进步。其进展突出体现在以知识图谱为代表的知识工程以及深度学习为代表的机器学习等相关领域。随着深度学习对于大数据的红利消耗殆尽,深度学习模型效果
一、word2vec的原理就不介绍原理可以参考码农场介绍:http://www.hankcs.com/nlp/word-vector-representations-word2vec.html二、 gensim的介绍与使用1. gensim安装gensim是一个很好用的Python NLP的包,不光可以用于使用word2vec,还有很多其他的API可以用。安装gensim是很容...
文本分类任务是自然语言处理中最常见的任务之一。文本分类简单定义来说就是对给定的文本,可以是一句话、一段文本、一篇文章利用文本分类器进行分类和打标签。文本分类任务广泛应用于长短文本、情感分析、新闻分类、事件类型分类、政务信息分类、商品类型分类、文章类型分类、论文类别、专利领域、案件描述、罪名分类、意图分类、论文专利分类、邮件自动分类、评论类型分类、药物反应分类、对话分类、税收分类、投诉分类、广告检测
RASA开源引擎介绍,主要是从系统优势、系统架构、消息处理过程等方面进行介绍
