- @oYeZhou


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
利用Python+opencv实现从摄像头捕获图像,识别其中的人眼/人脸,并打上马赛克。系统环境:Windows 7 + Python 3.6.3 + opencv 3.4.2一、系统、资源准备要想达成该目标,需要满足一下几个条件:找一台带有摄像头的电脑,一般笔记本即可;需配有Python3,并安装NumPy包、opencv;需要有已经训练好的分类器,用于识别视频中的人脸、...

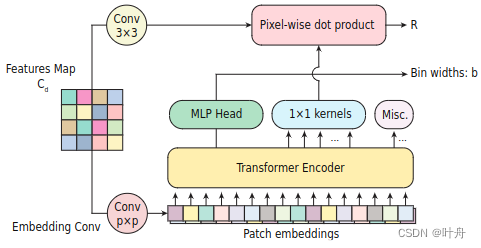
本文主要解决了从单个RGB输入图像估计高质量密集深度图的问题。我们从一个baseline的encoder-decoder CNN结构出发,提出一个问题:信息的全局处理如何帮助提高整体深度估计?为此,我们提出了一种基于transformer的架构块,它将深度范围划分为多个 bin,而每个bin的中心值是根据每个图像自适应估计的,最终的深度值估计为 bin 中心的线性组合。我们将这种新的构造块称为Ad
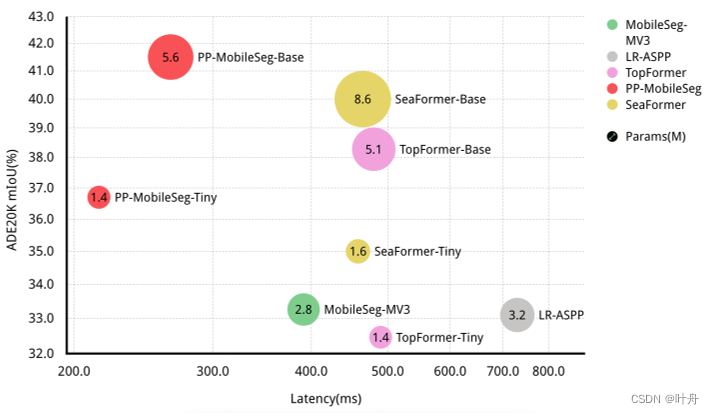
transformer在CV领域的成功之后,出现了很多在移动设备上使用它们的尝试性工作,但是这些工作在某些实际应用中的表现仍然不能令人满意。为了解决这个问题,本文提出PP-MobileSeg——一个在移动设备上达到SOTA的语义分割模型。包含了4个stage的StrideFormer backbone 由MV3块和SEA注意力模块构建,能够以最小的参数量提取丰富的语义信息与细节特征;AAM则首先通
目标跟踪是计算机视觉领域一种常用的算法,用于将前后帧中的同一个目标关联起来,从而可以针对某一个特定目标进行分析,如对状态进行投票平滑获取更为稳健的结果。然而,目前流行的跟踪算法大多是基于检测的bbox之间的IOU来匹配的,这对于某些小目标或者点的检测,IOU通常不是一个好的选择,因为目标太小,很容易使得相邻两帧之间的IOU为0。为了解决这个问题,本文提出了一种基于点之间距离的跟踪方法:将目标建模为
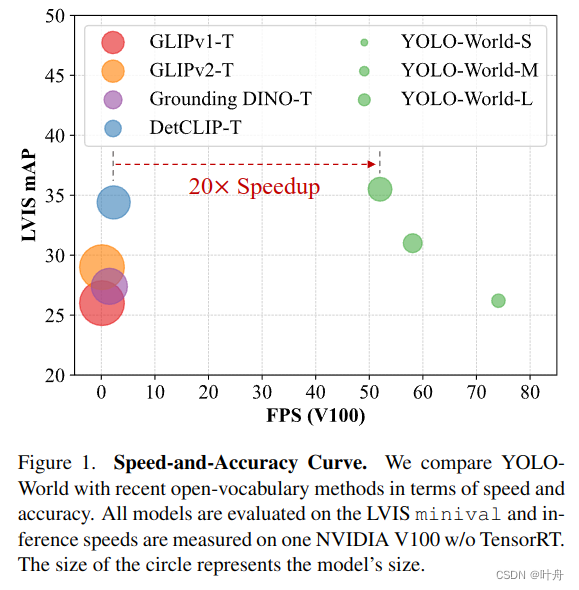
本文通读了YOLO-World的论文,翻译了其关键内容。
在图像处理中,我们可能会遇到求一个线条长度的场景,比如,现在有一条裂缝,需要求其长度,或者有一个长条形的零件需要知道其长度。本文利用OpenCV和skimage两个库,提供了一个解决方案。

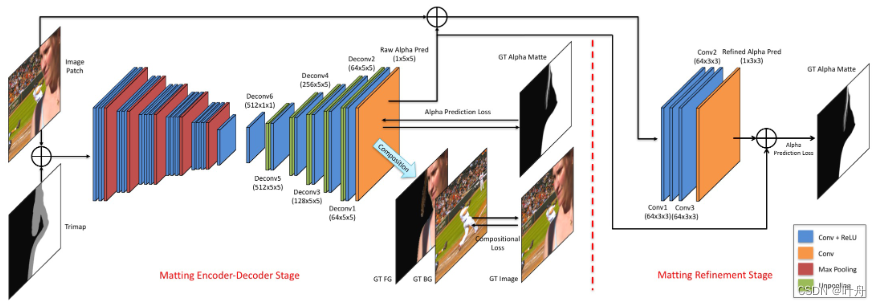
在此之前的Matting方法要么是用传统方法,要么是传统+深度学习的组合,他们都难以达到理想效果。因此,本文提出了一个利用trimap来作为辅助输入,并完全使用深度学习方法来进行Matting的方法,这开创了trimap-based Deep Learning Matting的先河。
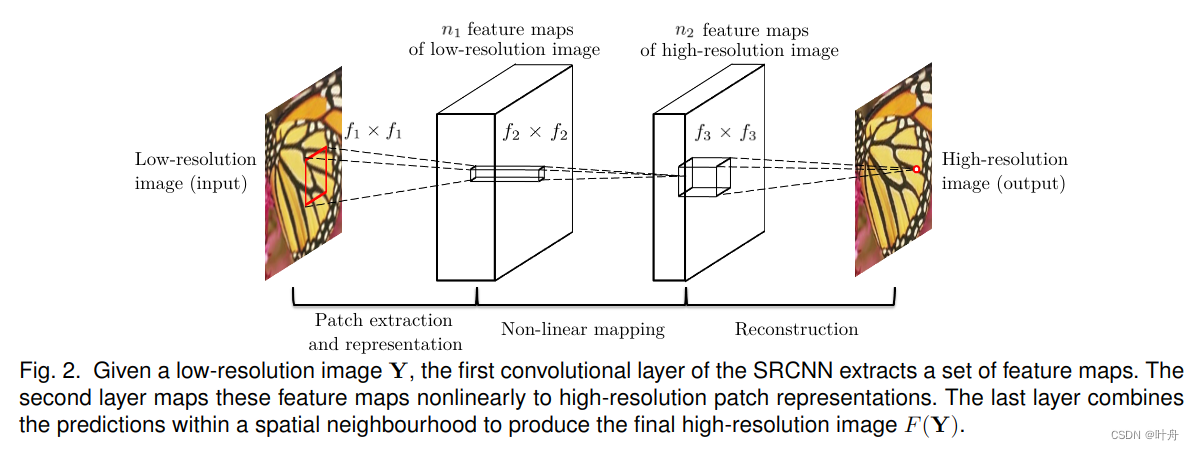
介绍了单图SR开山之作——SRCNN,并给出了网络结构的实现代码。
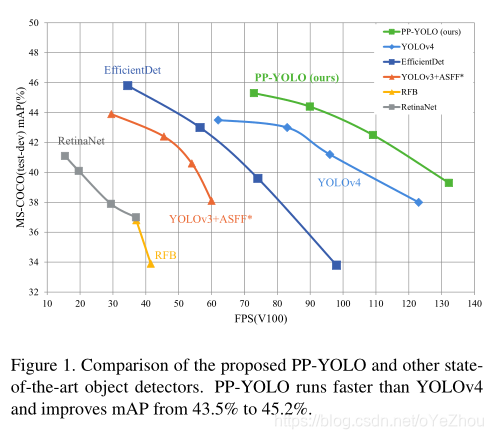
百度出品,基于YOLO3,使用各种tricks进行改进,得到了超越YOLO4的分类器。
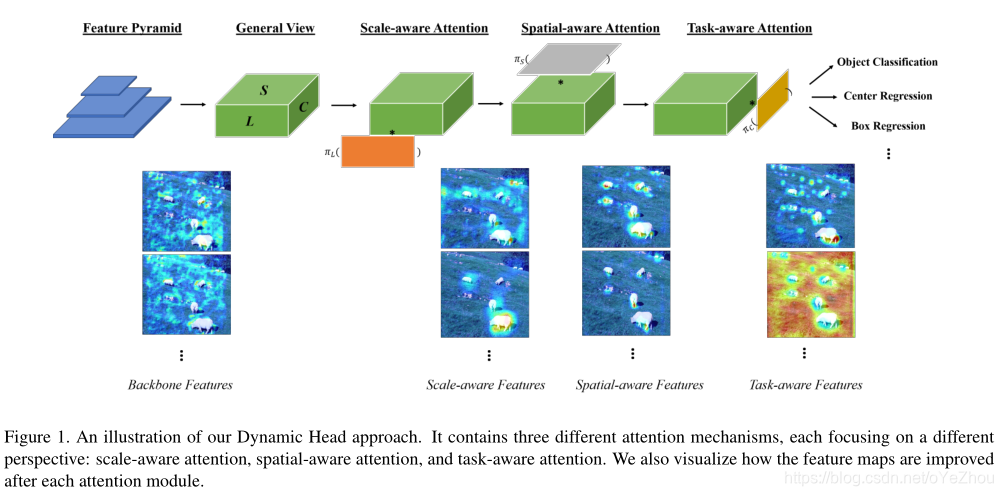
在目标检测方法中,由于分类和定位组合的复杂性,产生了多种多样的算法。这些算法尝试在检测heads上提升性能,不过它们缺乏一种统一的视角来看待检测问题。基于此,本文提出了一个新颖的动态head框架,将注意力机制与目标检测Heads统一起来。