

写文章


- @m0_72898512


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
hive优化(数仓)
在运行过程中,有多个reduce, 每一个reduce拿到的数据不是很均匀, 导致其中某一个或者某几个reduce拿到数据量远远大于其他的reduce拿到数据量, 此时认为出现了数据倾斜问题。

hive数仓要点总结
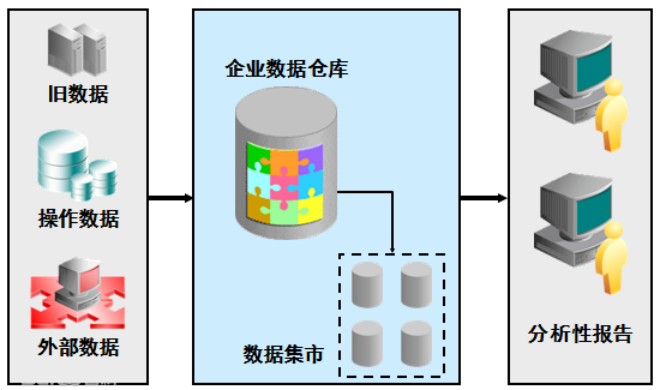
数据仓库(Data Warehouse)是一个面向主题的(Subject Oriented)、数据集成的(Integrated)、相对稳定(非易失)的(Non-Volatile)、反映历史变化(时变)(Time Variant)的数据集合,用于支持管理决策3.1什么是维度维度就是看问题的角度,给你一个数据表,怎么分析,怎么看就是属于维度范畴比如2025年的订单数据,怎么分析,可以从时间(月份)分析
Linux的kafka安装部署
5.复制文件到其他节点命令:scp -r /export/server/kafka_2.12-3.8.0wtk1:`pwd`/创建软连接命令:ln -s /export/server/kafka_2.12-3.8.0 /export/server/kafka。命令:ln -s /export/server/kafka_2.12-3.8.0 /export/server/kafka。命令:cd /e

到底了