- @m0_67392010


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
以上就是今天要讲的内容,本文仅仅简单介绍了用nginx来解决Access-Control-Allow-Origin跨域问题;

Could not find artifact org.springframework.boot:spring-boot-maven-plugin:pom: in alimaven因为 我一开始时这些加入pom.xml的<plugins><plugin><groupId>org.springframework.boot</groupId><ar
一.docker服务的命令启动:systemctl start docker守护进程重启:systemctl daemon-reload重启docker服务:systemctl restart docker / service docker restart关闭:docker service docker stop / docker systemctl stop docker二.关于docker容器
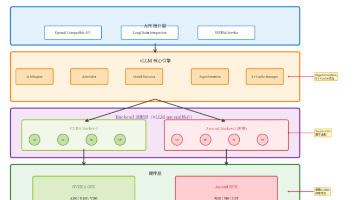
vLLM-ascend是昇腾NPU适配的高性能大模型推理框架,通过PagedAttention和Continuous Batching两大核心技术实现显著性能提升。PagedAttention借鉴操作系统内存管理,将KV Cache分块存储,内存利用率提升至89%;Continuous Batching实现动态请求调度,GPU利用率达92%。vLLM-ascend通过后端适配层实现CUDA到NPU
Bright Data AI Agent 正在改变传统数据采集方式。通过自然语言描述需求,AI 即可自动完成数据获取,大幅降低了市场调研、竞品分析等场景的技术门槛。测试显示,相比传统爬虫开发需要编写代码、调试选择器,AI Agent 更侧重结果导向。虽然复杂场景仍需IDE开发,但AI驱动的数据采集正成为趋势,让非技术人员也能轻松获取网络数据。Bright Data AI Studio提供免费试用,
整场炫技赛实操下来,我没有刻意测试极限功能,只是还原日常企业Java开发的真实流程,但飞算JavaAI智能会话的表现确实很贴合开发者的实际需求,相比传统开发模式,几个优势感受很直观。首先是专属适配性强,它完全贴合Java技术栈生态,针对SpringBoot、MyBatis-Plus、Redis等主流框架的适配度极高,不会出现通用AI常见的框架版本不匹配、注解错误、代码水土不服的问题。其次是上下文连
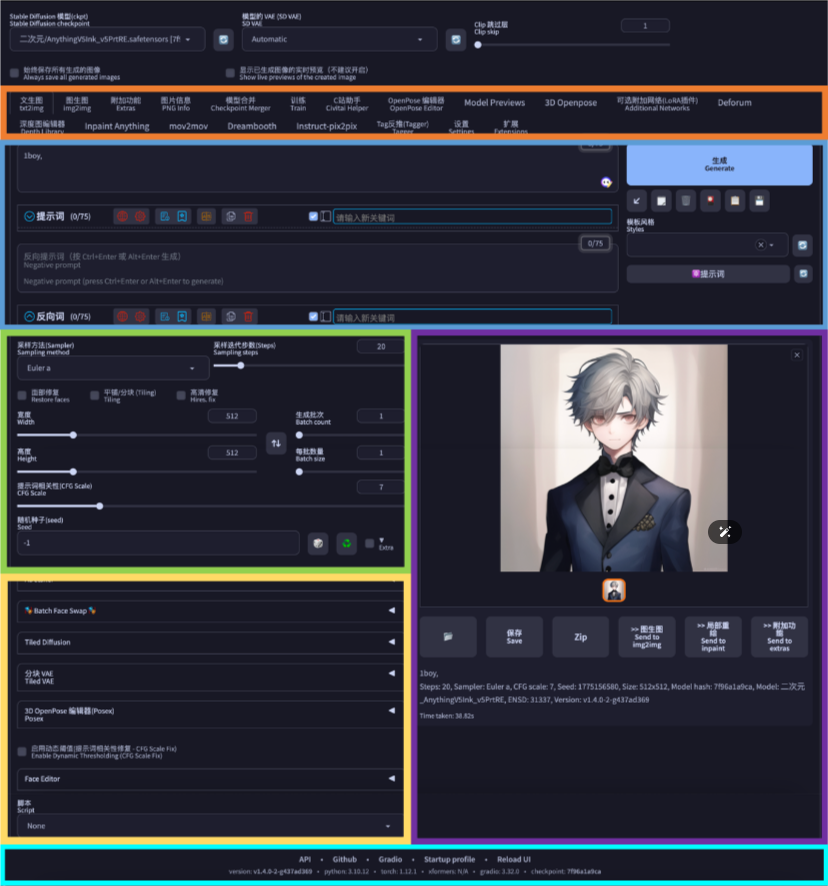
帮助用户快速掌握Stable Diffusion WebUI的基础操作,为后续AI绘图创作打下基础。
在 PostgreSQL 中实现高效的分页查询,尤其是在数据量巨大的情况下,需要综合考虑数据的特点、查询条件和性能需求。
Bright Data AI Agent 正在改变传统数据采集方式。通过自然语言描述需求,AI 即可自动完成数据获取,大幅降低了市场调研、竞品分析等场景的技术门槛。测试显示,相比传统爬虫开发需要编写代码、调试选择器,AI Agent 更侧重结果导向。虽然复杂场景仍需IDE开发,但AI驱动的数据采集正成为趋势,让非技术人员也能轻松获取网络数据。Bright Data AI Studio提供免费试用,
整体体验下来,AI Studio 给我的感觉,更像是在把原本复杂的网页信息整理流程变得更简单。相比传统方式,它通过 AI 自动识别网页结构、可视化配置以及自动化运行等能力,明显降低了信息获取和整理的门槛。无论是个人开发者、内容创作者,还是需要长期关注行业动态的中小团队,都可以更快速地搭建自己的信息工作流。如果你也对 AI 驱动的网页自动化感兴趣,可以体验一下的AI Studio。🛡️ 亮数据官方