


- @feiniao_coding


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
回到我那个同学的问题。AI 拉平的是「手速」和「苦力」,它没有拉平「认知」和「纪律」。以前一个想法从萌芽到验证要两周,现在要两小时——这是巨大的进步,是实打实的结果。但验证得快,不等于验证得对;能生成一百个策略,不等于其中有一个是真的。甚至可以说,AI 让"生成一个看起来很棒的错误结论"这件事,变得前所未有地便宜。这才是它在投资领域最大的风险:不是它太笨,而是它让你太容易得到一个自己想听的答案。
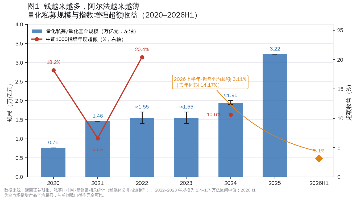
文章摘要:ChatGPT类模型在基金行业的真正价值在于将文本处理边际成本趋近于零,而非直接用于选股决策。顶刊论文证实其具备市场信号解读能力,但同一策略的夏普比率三年内衰减81%,表明公开策略难以持续。行业应用已转向生产阶段,桥水、贝莱德等机构将LLM置于非决策位,用于因果假设生成或API编排层。国内量化私募借助算力优势探索因子挖掘等辅助功能。研究显示,当前AI产出的金融专业内容仍需人工大幅修改,核
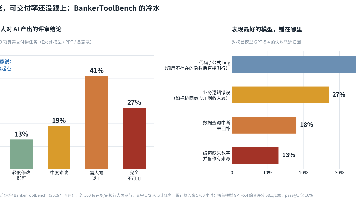
文章摘要:ChatGPT类模型在基金行业的真正价值在于将文本处理边际成本趋近于零,而非直接用于选股决策。顶刊论文证实其具备市场信号解读能力,但同一策略的夏普比率三年内衰减81%,表明公开策略难以持续。行业应用已转向生产阶段,桥水、贝莱德等机构将LLM置于非决策位,用于因果假设生成或API编排层。国内量化私募借助算力优势探索因子挖掘等辅助功能。研究显示,当前AI产出的金融专业内容仍需人工大幅修改,核
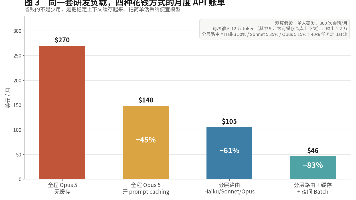
本文探讨了在量化投资研发中如何高效使用Claude AI模型(截至2026年8月版本)的实践经验。作者指出Claude不会直接创造alpha,而是作为效率杠杆,将想法验证速度提升5倍,但关键仍取决于想法质量。文章详细拆解了: 模型选型建议:根据任务复杂度分层使用Opus/Fable/Sonnet/Haiku四档模型; 核心提效环节:数据清洗(4.5x)、绩效归因(6x)、研报撰写(5.5x)等标准
对科研来说,这个转变的意义比对工业开发还大。因为科研代码的特点是:**写的人不专业,改的人是自己,跑的次数极多,但上线一次就完事了**。这恰好是智能体最容易吃下的那类工作。
本文总结了程序员转型量化领域使用AI工具的经验教训,提出了三点核心原则:1. AI主要压缩行业入门前的信息摸索阶段(4-6倍效率提升),但对需要真实反馈的关键环节(如市场验证)无能为力;2. 必须严格区分可验证任务(可委托AI执行)和判断性任务(需自主决策),建立有效的验证机制;3. 学习成果应沉淀为结构化技能文档(SKILL.md),而非散落的聊天记录。文章详细提供了工具配置方案(Claude各
本文总结了程序员转型量化领域使用AI工具的经验教训,提出了三点核心原则:1. AI主要压缩行业入门前的信息摸索阶段(4-6倍效率提升),但对需要真实反馈的关键环节(如市场验证)无能为力;2. 必须严格区分可验证任务(可委托AI执行)和判断性任务(需自主决策),建立有效的验证机制;3. 学习成果应沉淀为结构化技能文档(SKILL.md),而非散落的聊天记录。文章详细提供了工具配置方案(Claude各
本文总结了程序员转型量化领域使用AI工具的经验教训,提出了三点核心原则:1. AI主要压缩行业入门前的信息摸索阶段(4-6倍效率提升),但对需要真实反馈的关键环节(如市场验证)无能为力;2. 必须严格区分可验证任务(可委托AI执行)和判断性任务(需自主决策),建立有效的验证机制;3. 学习成果应沉淀为结构化技能文档(SKILL.md),而非散落的聊天记录。文章详细提供了工具配置方案(Claude各
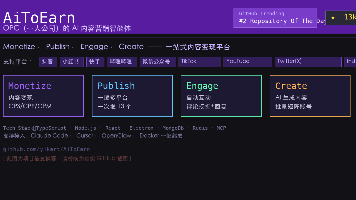
AiToEarn 火上 GitHub 日榜,根本原因不是技术有多新——多平台发布这件事早就有人在做了。它火是因为时机对了:AI 工具让内容创作的门槛降低,但内容运营的体力活没人替你干,这个需求一直在,市场一直缺一个把它做完整的东西。
对科研来说,这个转变的意义比对工业开发还大。因为科研代码的特点是:**写的人不专业,改的人是自己,跑的次数极多,但上线一次就完事了**。这恰好是智能体最容易吃下的那类工作。