


- @cxx654


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
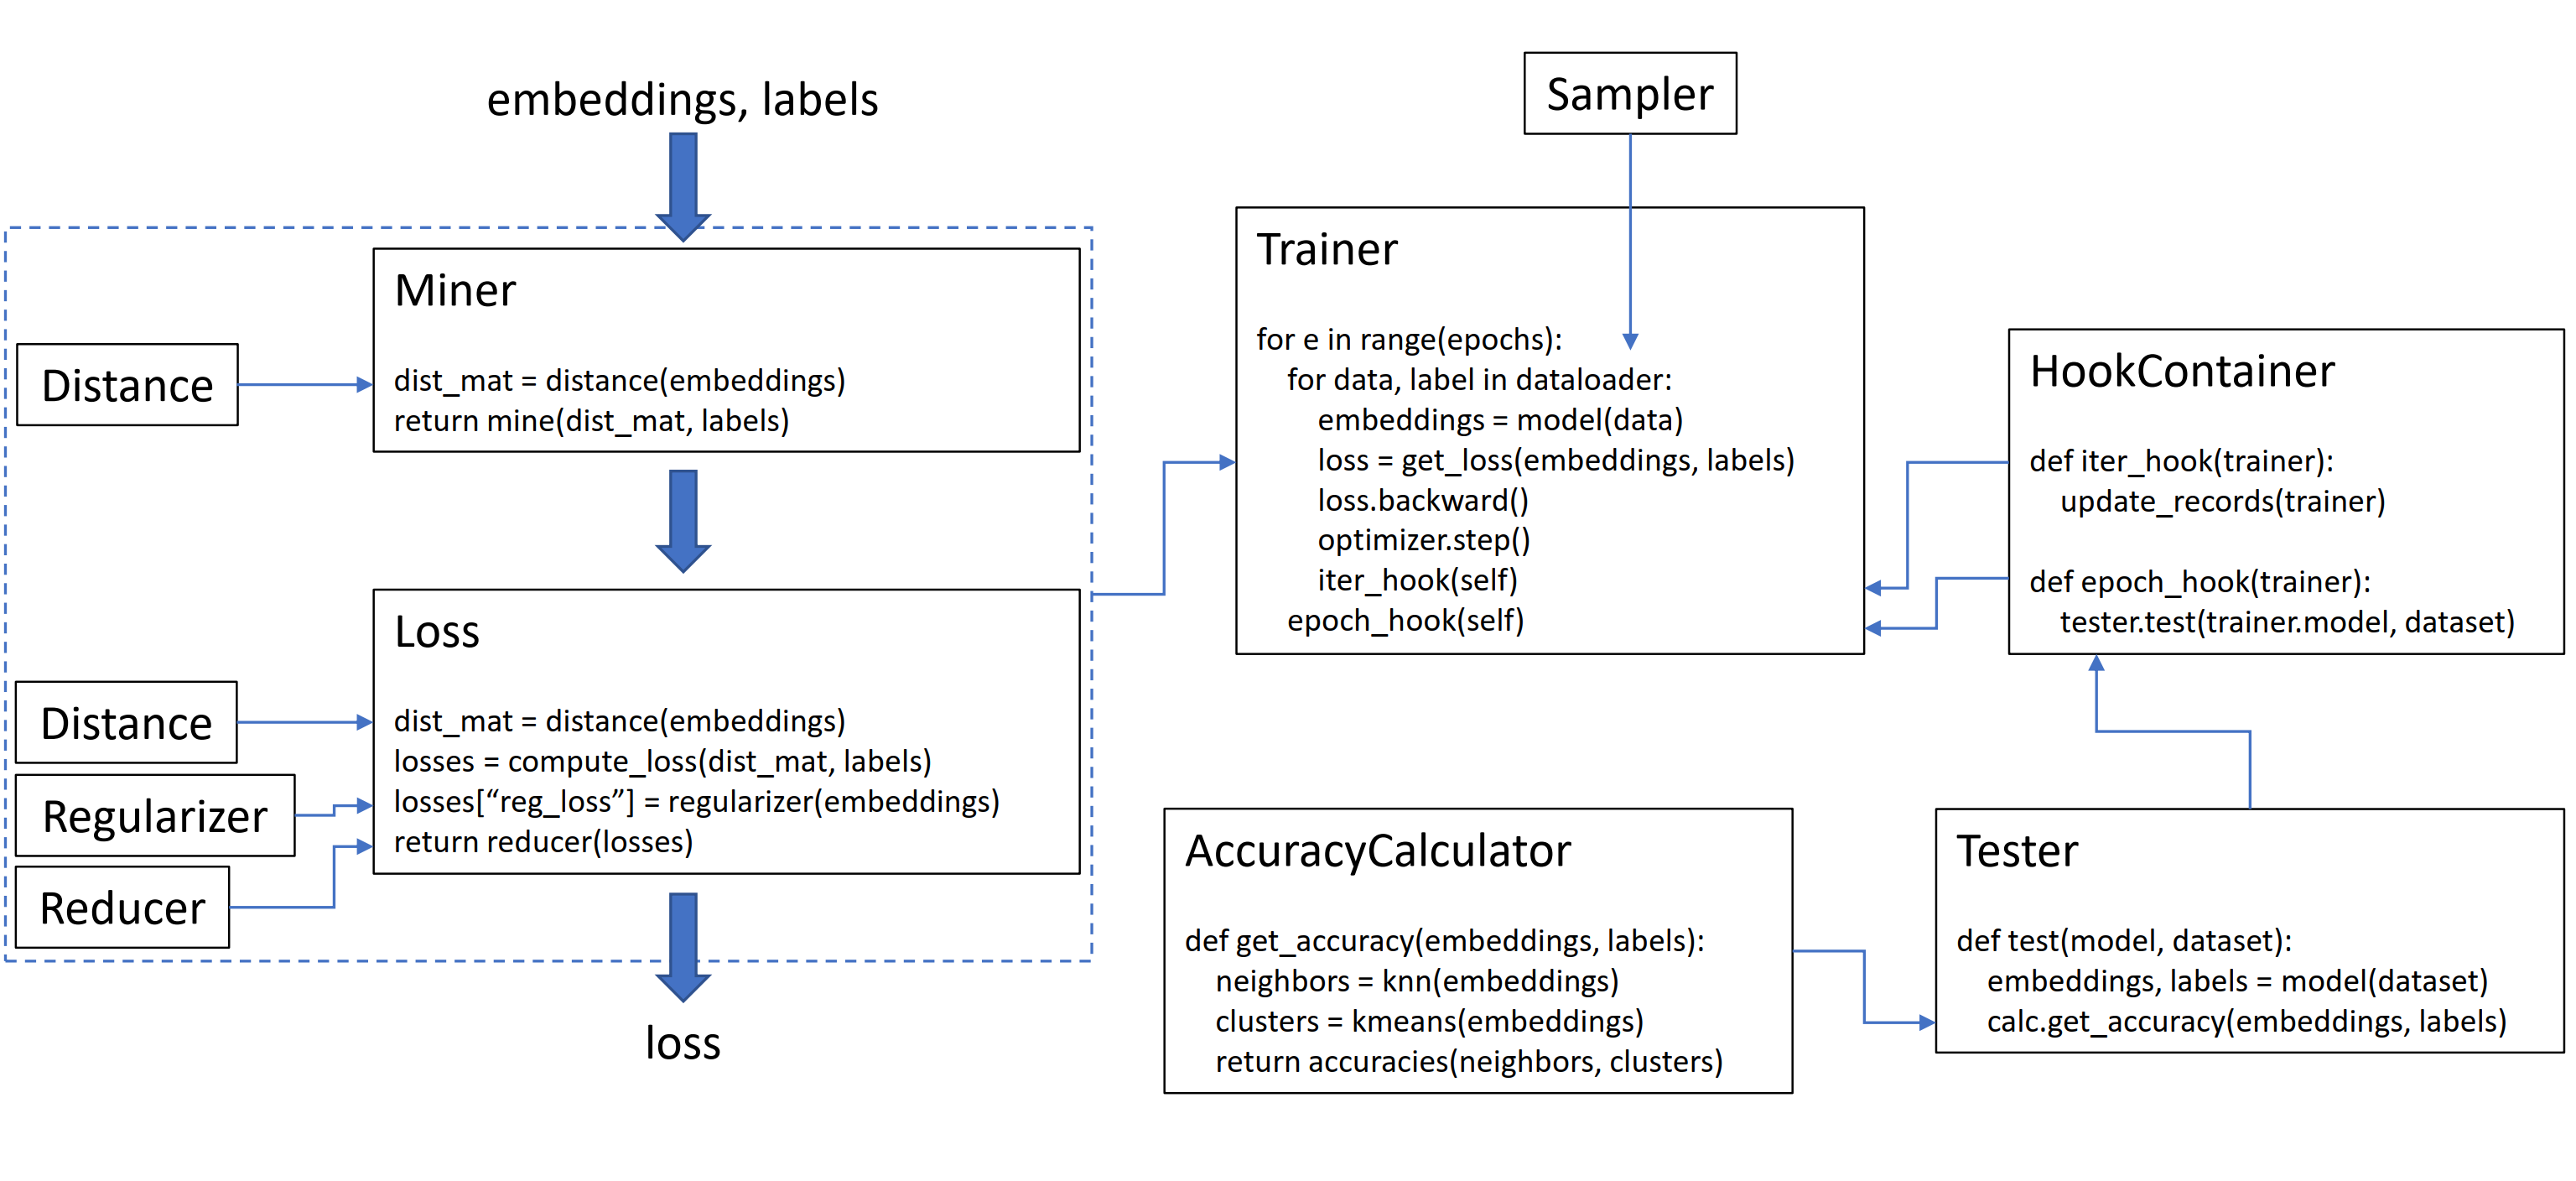
损失函数可以使用距离、规约方法和正则化方法来进行定制化。在下面的图表中,miner在批量中找到难训练的样本对的索引,这些索引被索引到距离矩阵。
在学习深度学习初期,被各种算法、各种名词吸引,学习了一些相关知识、框架和方法,也跑过Mnist分类以及iris回归。但是当真正拿到一个陌生的数据集时,需要重头开始搭建一个完整的模型时,常常会感觉到无从下手,之前跑的模型都是用人家整理好的数据,一行代码就能把数据加载进行直接使用,自己完全不关心数据的加载、处理过程,只关心模型能不能训练,训练结果怎么样。这篇文章简单记录一下pytorch中自定义数据集
上一篇《pytorch卷积操作nn.Conv中的groups参数用法解释》中简单介绍了MobileNet中使用的深度可分离卷积,以及pytorch中在实现深度可分离卷积时使用的nn.Conv模块的groups参数。本篇通过代码注释的方式解释一下pytorch中MobileNetV2网络的具体实现过程。from torch import nnfrom .utils import load_state
如果对于两张都是狗的图片(但是是不同的图片),为何他们在对比学习中,projector之后的表示空间是相邻的呢?情况二:假如在一个Batch中同时存在两张狗的图片,按照自监督的预设前提,自己只和自己像,和其他都不像,那么这两张狗的图片互为负样本,模型训练时在特征空间上确实会将这两张图片的表征距离拉远,所以此时需要用到损失函数里面的温度系数,温度系数设置的越小,会把“负例”推的越远,但此时的负例可能
与Normalizing Flows、GAN或VAEs等生成模型一样,它们都将噪声从一些简单分布转换为数据样本。这也是使用神经网络学习从纯噪声开始逐渐去噪进行内容生成的过程。

关于AP和mAP的定义可以参考以下链接:参考:https://blog.csdn.net/qq_35916487/article/details/89076570参考:https://zhuanlan.zhihu.com/p/56961620代码来源:https://github.com/rbgirshick/py-faster-rcnn/blob/master/lib/datasets/voc_
最近在学习郑泽宇老师的《Tensorflow实战Google深度学习框架》,书中样例代码写的非常简洁、易懂,而且逻辑性很强,在这里进行记录一下。 以下样例代码使用tensorflow框架构建两层全连接神经网络,识别MNIST手写数字数据集。其中用到了一些优化方法:使用滑动平均模型控制权值参数的变化率、定义学习率的衰减率控制学习率的变化率,使得在模型训练初期,模型参数变..
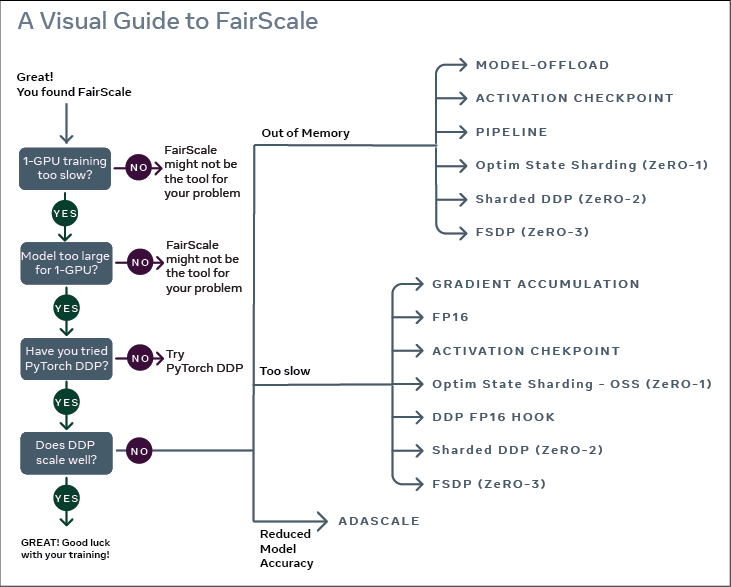
pytorch单精度、半精度、混合精度、单卡、多卡(DP / DDP)、FSDP、DeepSpeed(环境没搞起来)模型训练代码,并对比不同方法的训练速度以及GPU内存的使用
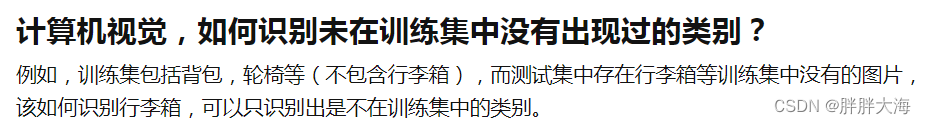
如何识别未在训练集中没有出现过的类别
Torch.onnx.export执行流程:1、如果输入到torch.onnx.export的模型是nn.Module类型,则默认会将模型使用torch.jit.trace转换为ScriptModule2、使用args参数和torch.jit.trace将模型转换为ScriptModule,torch.jit.trace不能处理模型中的循环和if语句3、如果模型中存在循环或者if语句,在执行tor