


- @WitsMakeMen


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
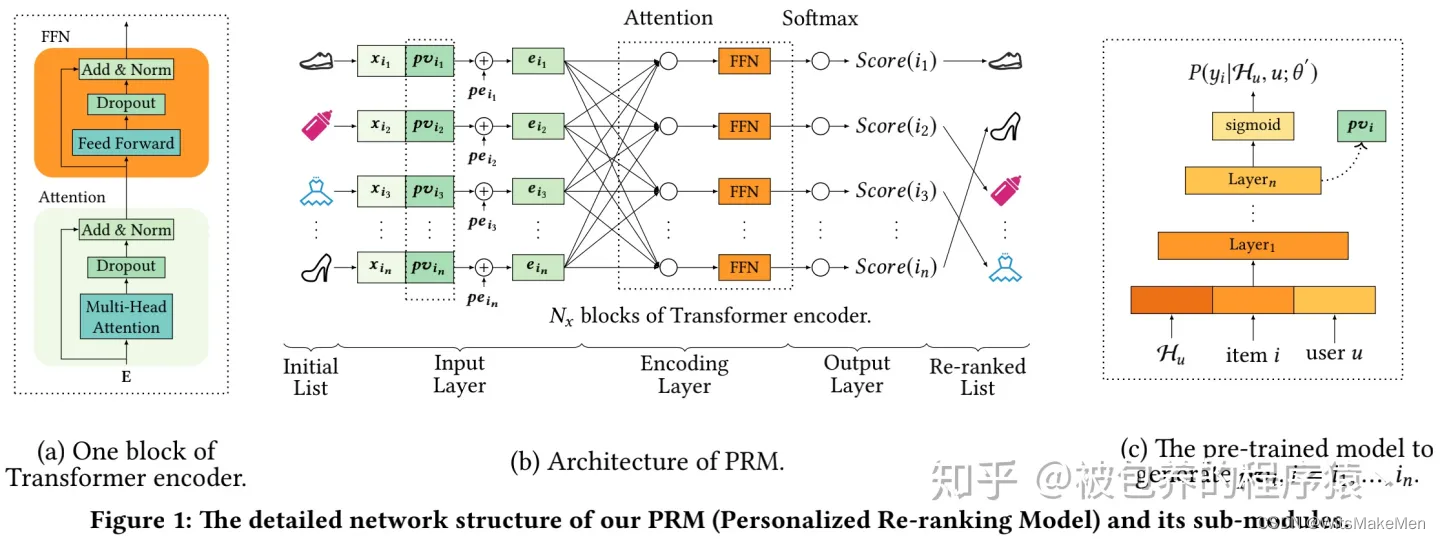
1、为了解决推荐系统排序全局最优解的问题,文章对重排模块进行了较为详细的介绍2、在重排序部分,文章提出了基于Transformer结构的个性化重排序模型,显著提升了线上系统的曝光、点击、GMV等指标。3、使用listwise的思想对整个序列进行 优化。
这些指标都是衡量搜索引擎算法的指标。搜索引擎一般采用PI(peritem)的方式进行评测,简单地说就是逐条对搜索结果进行分等级的打分。假设我们现在在Google上搜索一个词,然后得到5个结果。我们对这些结果进行3个等级的区分:Good(好)、Fair(一般)、Bad(差),然后赋予他们分值分别为3、2、1,下面我们举例子按照此评级来。
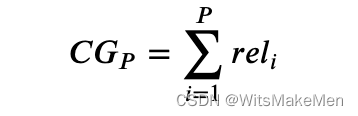
总结:还是StackOverflow靠谱,查了一下午资料,最后在Overflow上找到了答案。I had this problem, there's 4 interfaces on my server, which should have been: eth0, eth1, eth2, eth3 but they were renamed to eth4, eth5, eth6, et
转自: http://blog.chinaunix.net/uid-26952464-id-3352144.htmlGit Community Book 中文版书上,摘录如下: 一、基本git rebase用于把一个分支的修改合并到当前分支。假设你现在基于远程分支"origin",创建一个叫"mywork"的分支。$ git checkout -b my
作用:是对矩阵按列进行平均池化。比如tensorflow教程中的这个例子,中间的GlobalAveragePooling1D就是对输入中的sequence进行平均池化。因为这是个分类算法,输入是两维的<batch, sequence>,其中batch是训练模型的分批,sequence是单个句子的长度。模型代码:模型summary:模型简单介绍...
Generative Agents: Interactive Simulacra of Human Behaviorhttps://arxiv.org/pdf/2304.03442.pdfFigure 1: Generative agents create believable simulacra of human behavior for interactive applications. In
今天为大家分享近期阿里发布的Qwen3技术报告,特别是Qwen3如何通过一系列精密的后训练(Post-training)过程,从一个强大的基础模型,蜕变成一个更加智能、灵活、且与人类偏好高度对齐的助手。这就像是给大模型装上了“智慧大脑”和“沟通桥梁”的升级过程。
链接:https://blog.csdn.net/Jerr__y/article/details/53749693RNN基础对于RNN,我看到讲得最通俗易懂的应该是Andrej发的博客:The Unreasonable Effectiveness of Recurrent Neural Networks这里有它的中文翻译版本:递归神经网络不可思议的有效性如果想了解 LSTM 的原理...
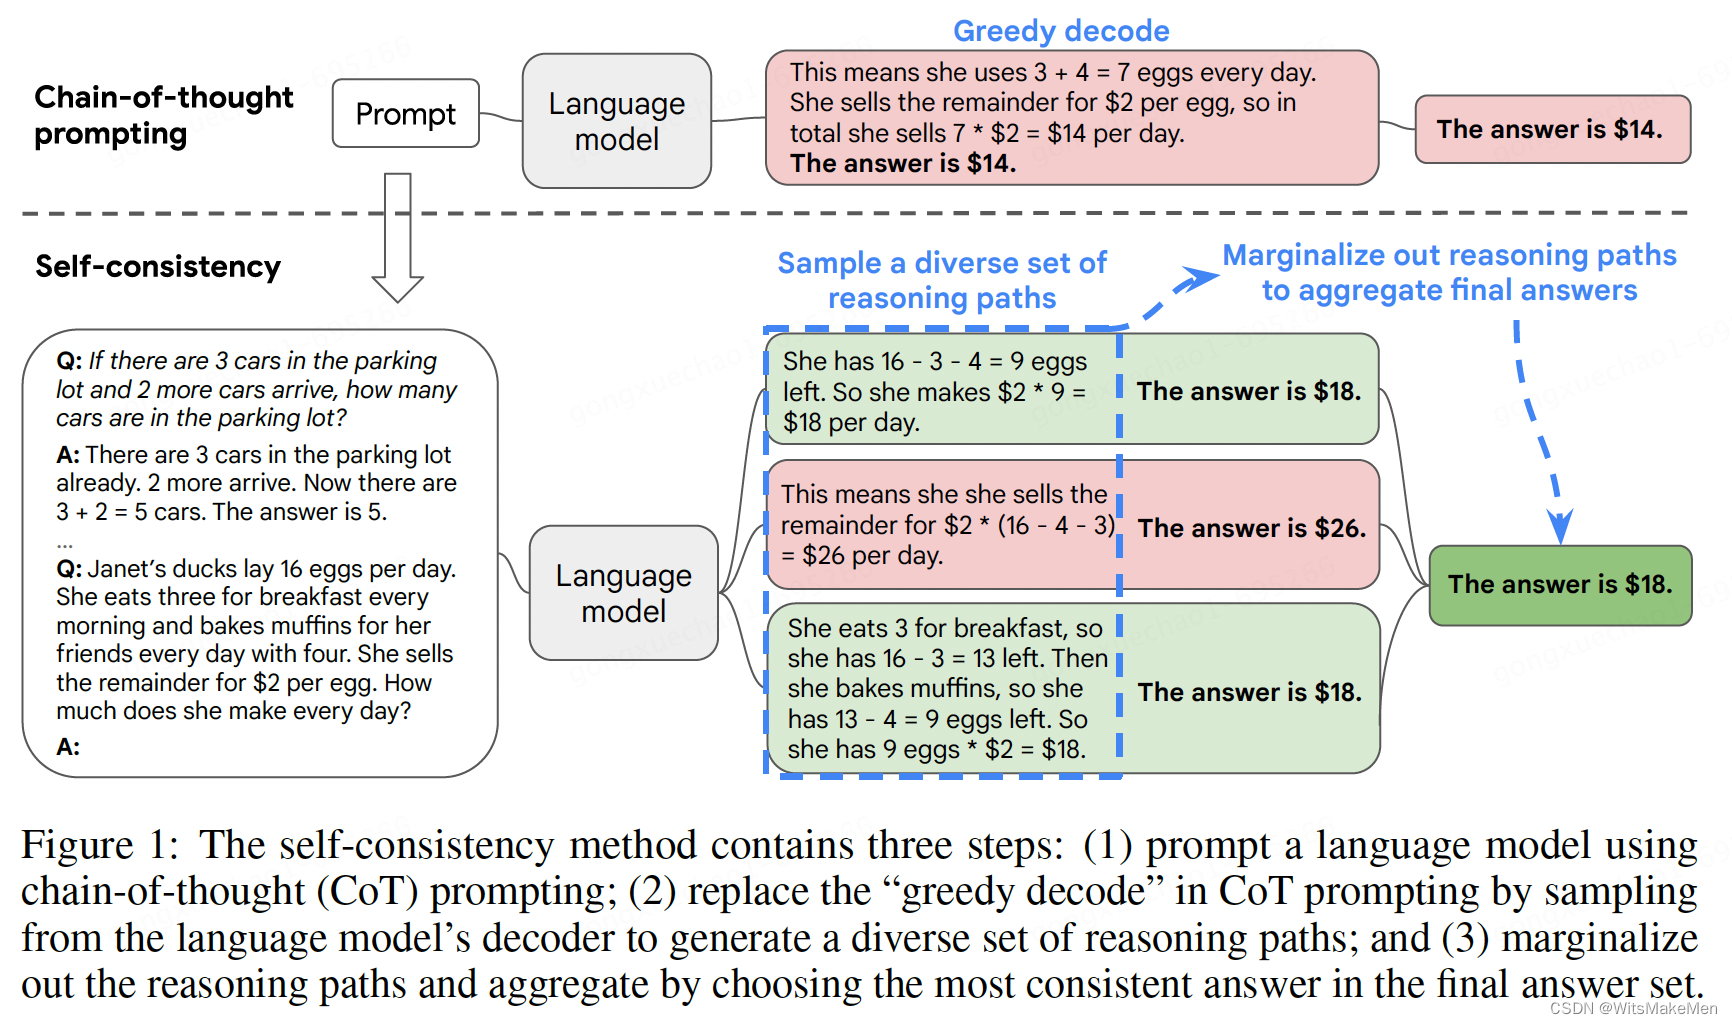
思维链已经在很多任务上取得了非常显著的效果,这篇论文中提出了一种 self-consistency 的算法,来代替 贪婪解码 算法。本方法通过 采样多个思维链集合,然后LLM模型生成后,选择一个最一致的答案作为最后的结果。一致性思维链 认为复杂的推理问题,有不同的思维方式去解决,从而得到最终唯一答案。经过实验验证,一致性思维链取得了显著的提升。
大语言模型(如 Qwen3)的输出过程本质是基于自回归机制的逐 token 生成循环,从 “输入预处理” 到 “最终文本输出” 可拆解为「预处理→初始化→逐 token 生成→后处理」四大阶段,每个阶段都对应具体的张量计算、缓存更新和采样逻辑。