- @Prettybritany


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
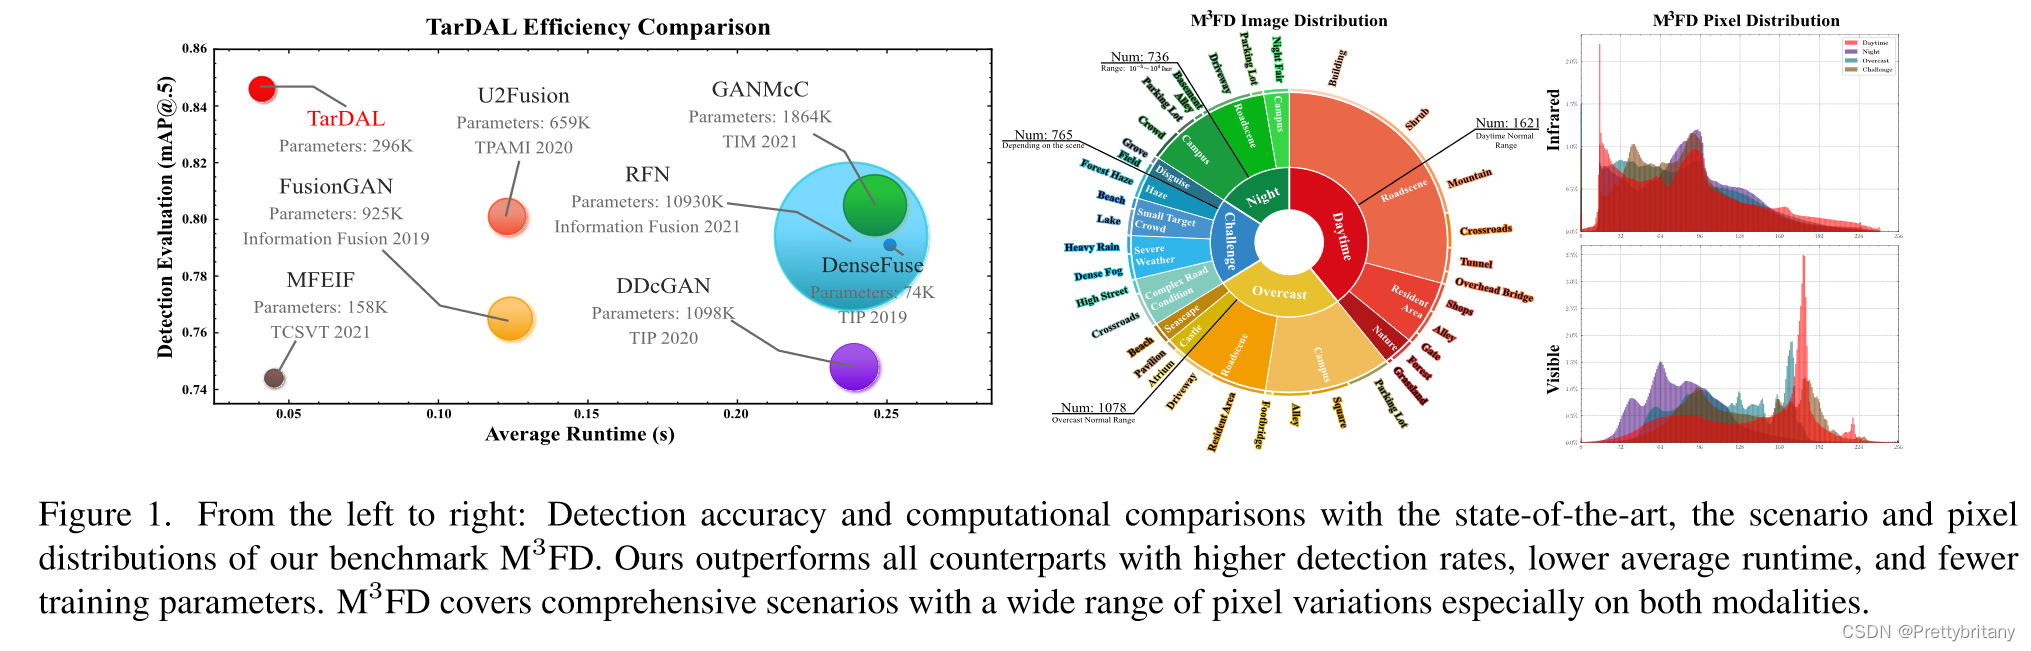
通过计算像素的显著性值来计算权重 ω1 和 ω2,公式 (5) 中的 Lpixel 表示像素损失,其中包括了融合图像与源图像的像素间的绝对差值。最后,该策略不仅可以生成视觉上吸引人的图像,而且可以在给定训练的网络参数的情况下输出准确的检测,使我们能够找到面向检测的融合的最佳解决方案,并且比独立训练方案更有效地收敛。ω1 和 ω2 是用于计算每个源图像对融合图像贡献的权重,通过调整这两个权重,可以更
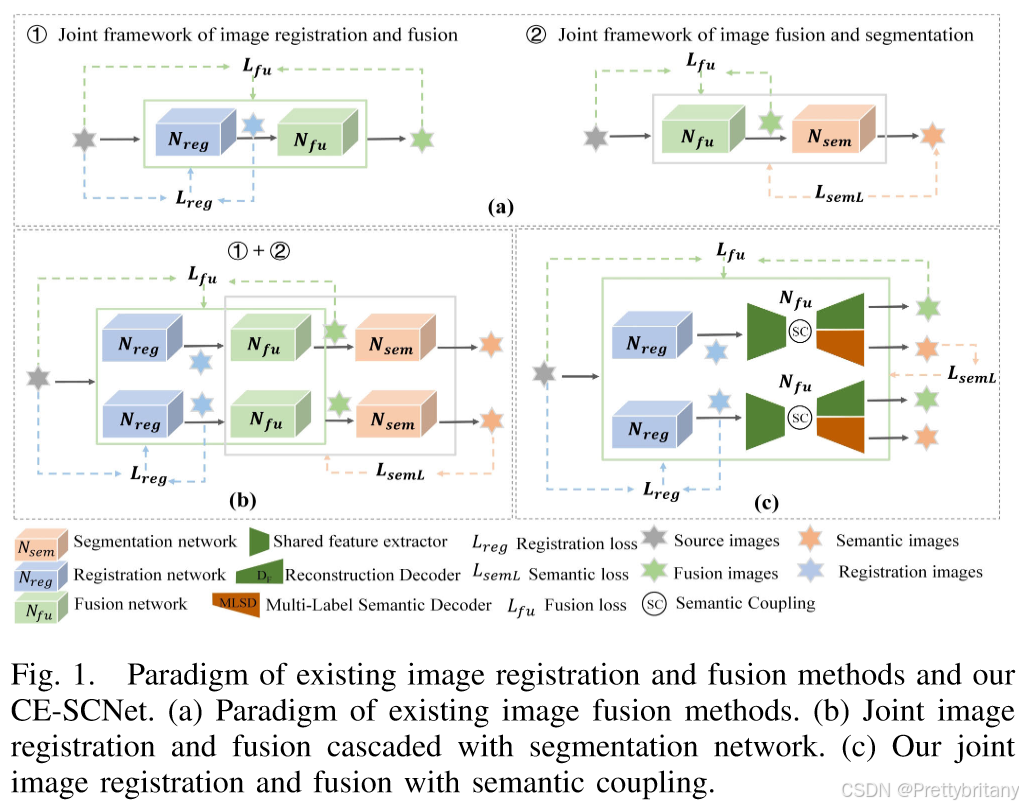
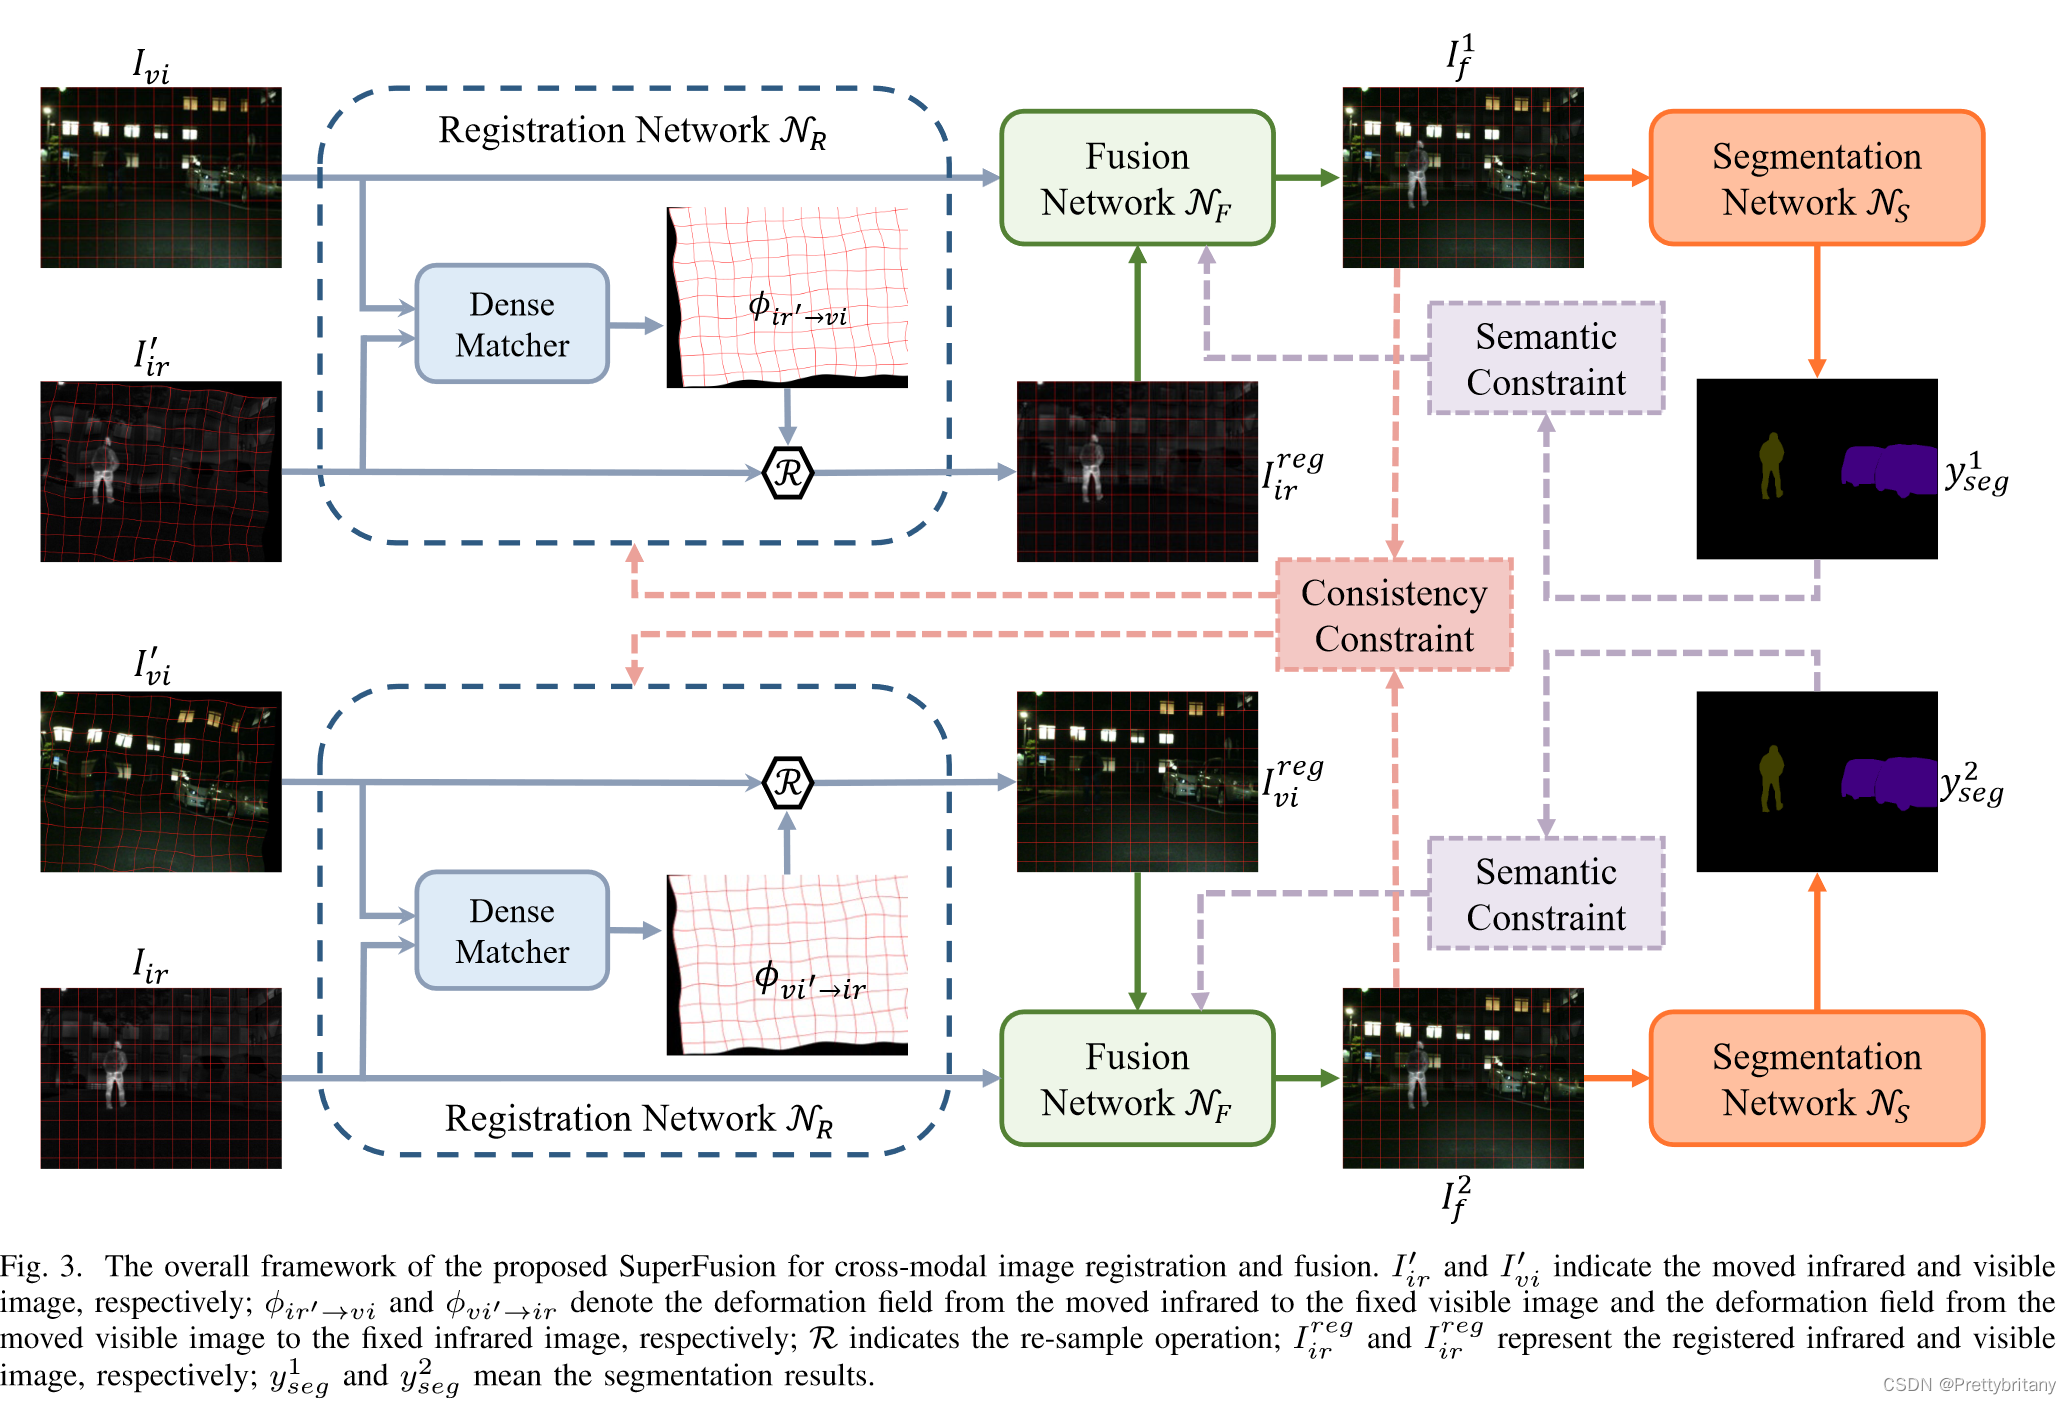
在本文中,提出了一个考虑图像配准、图像融合和高级视觉任务要求的多功能框架,称为 SuperFusion。它显着扩展了实际应用中图像融合的范围。SuperFusion 由三个组件组成,包括图像配准、融合和语义分割网络。首先,设计配准网络来估计双向变形场,以便可以更简单地使用光度损失和端点损失来提高精度。此外,还开发了一种对称联合配准和融合方案,以平衡输入模态的偏差,并进一步促进融合域中具有相似性约束
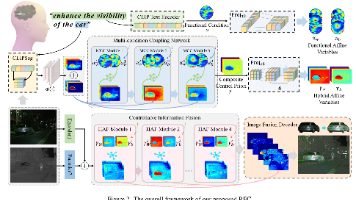
受环境条件限制,原始采集的红外和可见光图像可能会出现劣化,融合图像质量较低。可见光图像容易受到退化问题的影响,例如低光、过度曝光等。红外图像不可避免地受到噪声(包括热噪声、电子噪声和环境噪声)、对比度降低和其他相关影响的影响。当前的融合方法缺乏自适应解决退化问题的能力,导致融合图像质量低下。依靠手动预处理来增强图像存在灵活性和效率问题。

首先,使用BLIP2、GRIT、Segment Anything对图像生成Image Caption, Dense Caption, and Semantic Mask,然后将它们喂到chatgpt来生成文本描述text,再将text输入到frozen的BLIP2得到文本特征,最后,将text的特征concat作为q与图像特征计算cross attention再解码。,1、2、3是分开描述,4、5
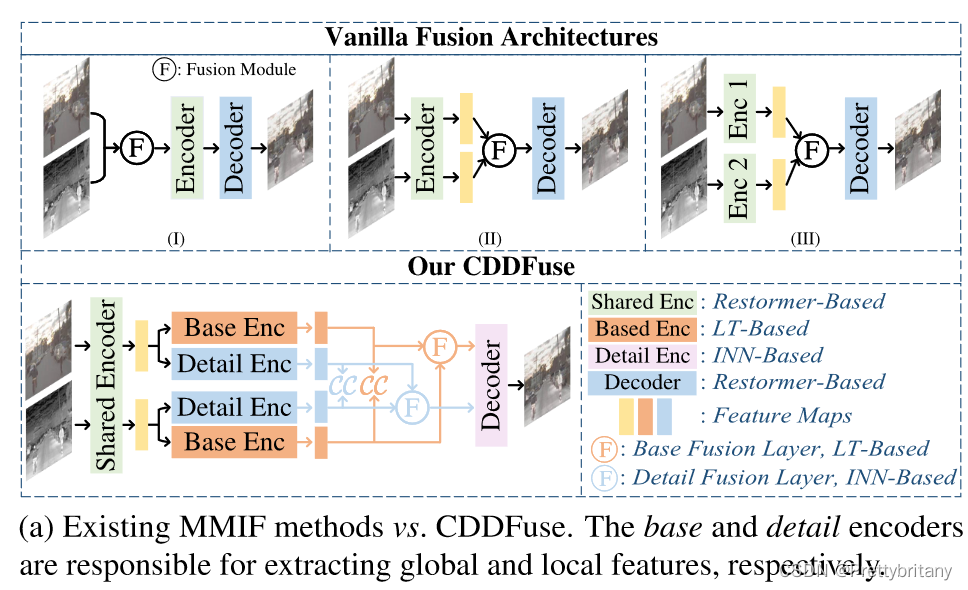
这个损失项的动机是,根据我们的 MMIF 假设,分解后的特征 {ΦB I , ΦB V } 将包含更多模态共享信息,例如背景和大规模环境,因此它们通常是高度相关的。通过扁平化前馈网络的结构,扁平化了 Transformer 块的瓶颈,LT 块缩小了嵌入,以减少参数数量,同时保持相同的性能,满足我们的期望。显然,我们的方法更好地整合了红外图像中的热辐射信息和可见图像中的详细纹理。例如,在图1a中,(