- @OceanBaseGFBK


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
C³-Predictor 围绕“快速初始预测、可靠性判断、针对性校准”的技术思路,将传统数据库代价估计方法与图神经网络预测技术相结合,设计了由并发代价预测、动态置信度评估和图嵌入偏差校准构成的三级处理框架,既保障了简单查询场景下的预测效率,又实现了复杂并发工作负载下的精准预测。该框架的核心优势在于,不仅实现了复杂并发查询性能的精准预测,而且能够根据预测可靠性动态选择计算路径,减少不必要的神经网络推

本文介绍如何利用 Vanna与Ollama,并基于OceanBase数据库,来打造一个AI 自然语言分析知识库系统,以及这个系统的主要功能及其所带来的好处。
随着企业业务的不断发展,数据量往往呈现出快速的增长趋势。使用MySQL的用户面对这种增长,普遍选择采用分库分表技术作为应对方案。然而,这一方案常在后期会遇到很多痛点。这也是OceanBase的客户,绿普惠所遭遇过的,因此,他们舍弃了 MySQL 分库分表方案,转而使用分布式数据库。

本案例主要是分享应用OceanBase时,SQL走错 执行计划,而导致SQL慢的排查方法论

这是一个很经典的问题:如果Join 时关联表太多,执行计划容易选错。原因是估算驱动表的扇出很容易产生误差,尤其 Join 的结果作为驱动表时,相当于要估算 Join 的结果有多少行,这个误差会更大。而优化器在估算 Nested-Loop Join 算法的成本逻辑中,驱动表的扇出对计算结果影响很大,也就是说 Nested-Loop Join 的成本估算结果很容易产生误差,所以执行计划容易选错。

《DBA从入门到实战》第八期精选几个具有代表性的问题,为大家进行详细解答,内容涵盖OceanBase数据库诊断与调优,OceanBase高可用架构之主备库,OceanBase数据库人才培养方案。
归档库切换 OceanBase 后,凭借 OceanBase 的高级压缩技术,所需存储空间缩减至原有的 1/5,降本效果立竿见影;同时,得益于原生分布式架构,数据归档和历史信息查询的性能也有了明显提升。
我们与广受欢迎的开源LLM应用开发平台Dify合作,推出了“Dify +OceanBase 实验方案”,基于OceanBase数据库对向量能力的支持,结合低代码开发平台Dify,使用户能够通过直观的拖拽界面,轻松构建和运营生成式AI应用。

OceanBase 数据库支持读写分离,以减轻企业数据库的读写负载,并减少读写操作间的影响。通过分离读写操作来提升系统响应速度,可帮助企业构建出既高效又稳定的系统。本文将讲解OceanBase数据库的弱一致性读机制,并分别详细阐述在OceanBase V4.X和V3.X中,读写分离的实现原理及配置步骤。

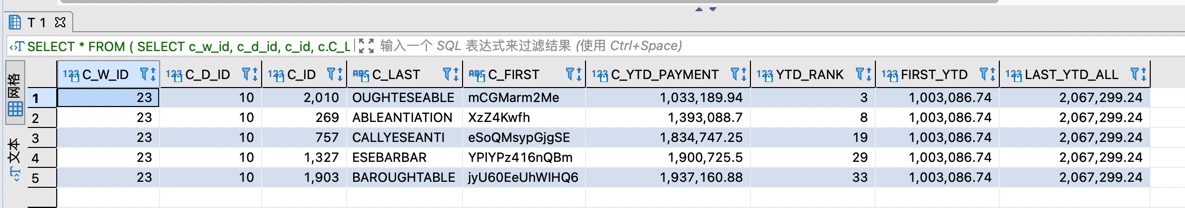
前文《OceanBase SQL 执行计划解读(二)──── 表连接和子查询》介绍了子查询的执行计划特点,还没有完全说完。本文继续介绍子查询的执行计划以及分析函数(窗口函数)的执行计划特点。熟悉常用 SQL 的执行计划是为了反过来快速解读分析复杂 SQL 的执行计划。子查询本文不讨论非相关子查询。标量子查询表达式(Scalar Subquery Expression)是一类从一行返回一列值的子查询