- @Maxwell_Newton


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
结论n个人,两队,每队2−3个人,问两队人数差的最小值?<=3的话只能分一队,另一队空,特判。否则,如果是偶数,则可以均分成两队,因为模4余2则可以最后六个人分成两个三,剩下的均分,模4余0则可以直接均分。如果是奇数,在偶数分法的基础上,会有一队多一人。
kruskal是最常见的最小生成树算法,但他有一个严峻的问题,就是总要遍历所有边,因此在完全图上复杂度至少是On2的,对于完全图MST束手无策。因此往往会使用数据结构优化prim,或者boruvka来解决完全图MST问题。
反悔贪心初始给出一个长度2n的序列,构造一个长度2n的合法括号序列,使得左括号位置的元素和最大。可以类似反悔贪心的思路来,枚举所有前缀,每次加一个括号。每次先都加右括号,如果加完后右括号个数超过这个前缀的长度的一半,说明需要把前缀中的一些右括号变成左括号,直到右括号个数不超过前缀长度一半,这里由于我们每个前缀都这样做,所以每个前缀最多只多一个右括号(或者说,我们1i−1已经是合法的了,那么i位置增
对于每个前缀,我们记录每种元素出现次数的余数,并把它状压成一个整数,这样两个前缀的状压值相同,他们之间形成的区间就是合法的。显然是有的,固定一个端点,如果一个区间长度是合法的,那么更长的区间,只要每次增加三个同种元素就肯定也可以。那现在无非就是多了几种元素,我们对每种元素都做这个,为了方便查询个数,最后状压到一个变量,存到扫描线。的出现次数的余数,是我们当前枚举的这种情况,进一步,这等价于。的出现
和很多人想的不一样,注意力机制不是一诞生就取代了RNN,相反开始RNN和注意力机制是同时存在的。前面说过RNN的问题是,循环中会把信息反复压缩,这样距离远的token的占比会越来越低,表现为模型输出时忘记前面的内容,为了解决这个问题提出过LSTM,引入长期记忆,但是这个做法效果提升有限,太长了该忘还是忘,而且计算更复杂。
语言模型处理的输入是字符串,但内部是对token预测概率,因此需要字符串到token的转换规则。也就是需要定义压缩率越高越好,因为压缩率高能把相同一段字符串输入,变成更短的token序列,降低模型训练推理的计算开销。然而压缩率提升往往需要更大的词典,比如把一个多个词组成的短语也看成一个token,而不是每个词一个token,压缩率自然提高了,但代价是词典里必须保存这个短语,不能只保存单个词汇。
最常见的就是fp32,如下图,每个占4B,32个bit,8bit存指数,23bit存有效数字,1bit存符号。数值范围和精度都比较可靠,问题是太消耗内存了,而AI不是科学计算,对精度要求没有那么高,牺牲性能换精度并不划算,所以fp32是最基础的类型,但不是追求极限性能场景使用的类型。我们具体分析一下,fp16的计算规则如下,S是符号位,E是指数位,M是尾数。eniops库的价值在于,shape推导
这个通信不仅要发,还要接收相邻网格的数据,相邻网格和当前网格不在同一个线程块,或者不在一个GPU上,是异步计算的,中间有一段时间,通信处于阻塞。并且,这个线标志的是在特定计算强度下的上界,如果计算强度不变时,没达到这条线的上界,往往是因为前提没达到,也就是没有实现计算和通信的完美重叠,需要我们设计流水线来掩盖通信延迟。具体计算可以使用如下代码,注意这里我们算出来的是一个线性层的实际吞吐率,这既不是
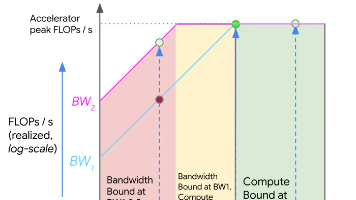
对于模型中的某一层,前向传播最主要的计算量都在全连接层,全连接层计算是(B,D)的激活值,乘上(D,D)的全连接层矩阵,矩阵乘法每个位置都需要一次加法,一次乘法,总计算量大概为。具体实现上,速度或者说动量,采用历史梯度的指数移动平均,这样越近的梯度权重越大,越远的梯度影响越小,考虑了历史梯度信息,但不会使得很久以前的梯度一直叠加。激活值的B是batch size,D是隐藏层维度,也是每个token
最早的注意力架构,位置编码采用的是余弦编码,也就是加上一个三角函数,波长和token位置成正比。也有一些比较简单的模型如GPT3之前,使用绝对位置编码,第i个token就加上一个固定值,表示第i个。Llama使用了旋转位置编码,并且由于Llama是第一个性能能对齐闭源模型的开源模型,许多后来的开源和闭源模型都借鉴了它的设计,包括RoPE。一个好的位置编码应该具有相对位置的特性,也就是两个不同tok