


- @2501_91695478


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
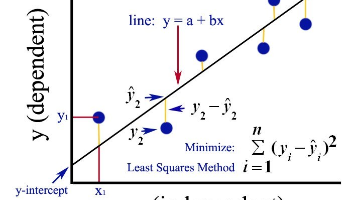
很多同学在学习机器学习、深度学习算法的过程中,没有获得感和成就感,因为仅仅学习了理论,没有落地的出口,感受不到这个算法有什么作用或者能解决什么问题这一期给大家推荐一个爆火项目practicalAI, 项目本身就是让大家在实战当中学习AI技术,代码可以在Jupyter中运行下面具体来介绍一下这个实战项目:实战一:线性回归项目。
标签:#人工智能、#大模型、#自然语言处理、#大模型开发、#智能体开发、#agent开发、#AI验收标准:输入公司年假多少天能准确回答知识库内容;界面流畅,无卡顿。
这时候能快速搭建可落地的解决方案的人就特别吃香,可能只需要把开源模型微调下,做个增强检索,再设计好业务流程中的提示词,就能解决他们80%的痛点。当下的大模型落地进程,依然处于初期阶段,正是百废待兴的时候。尤其B端,现在很多企业的情况很有意思,手里攥着预算想搞智能化,但既不敢all in大模型,又不甘心只做表面功夫。但是算法的话还是算了吧,你去看看那些大厂算法岗招聘,清一色要求顶会论文+名校PhD,
注意事项:1、不建议用Ollama等量化工具部署模型,因为5分钟就学会了,让人误以为大模型部署不过如此,其实Q4量化的精度很低,不适合用于生产环境。学习大模型,实践是非常重要的,所以首先得有显卡,可以购买,也可以在各种云平台上短租,具备此条件,然后再学习,才能达到事半功倍的效果。5、学习RAG技术,先学习部署Dify等产品,然后学习langchain、llamaindex等。3、学习微调大模型,了
现在95%的大模型实习岗位,都不是让你去从头“创造”一个GPT-5,而是让你基于现有的模型,去做各种“下游”工作。大家想象中的大模型实习,可能是这样的:一排排A100/H100在你面前闪烁,你和团队大佬一起,对着满屏的代码和公式,高喊一声“开始训练!实际情况更可能是这样的:你的导师(mentor)丢给你一个开源模型(比如Llama 3, Qwen, ChatGLM),然后让你去解决一个具体的业务问
深度学习是后续学习自然语言处理,强化学习,计算机视觉等细分领域的基础,深度学习的应用也非常广泛,各个学科都会涉及,所以建议大家掌握基本的深度学习理论知识深度学习的理论可能会比机器学习更复杂一点,因为其中的数据流向是一个比较困难的点,很多同学学了很久都搞不清楚每个模块输入和输出的数据shape和类型这一期主要是给大家推荐一个深度学习理论教程:可以按照下面的学习计划来学习,总共六周的计划安排下面是具体
目录1. LeNet(90/98)诞生于1990年,在手写体字符识别领域创造性的引入了卷积神经网络的基本操作,意义重大,可以说是现代卷积神经网络的发展起点。1.1思路引入卷积层+池化层等结构1.2 网络结构输入图像分辨率:28x28结构:(1)卷积层1:5x5 --->输出4个24×24大小的特征图;(2)池化层1:平均池化层 2x2;(3)卷积层2:5x5 --->输出12个8x8大小的特征图;
简单分成几步,完成上面几步,这样你就是一个不错的入门选手了。再看看书,就是一个只需要你部就班就能成为高手的路!
实现一个简单的MLP类:# 用模型参数声明层。这里,我们声明两个全连接的层# 调用MLP的父类Module的构造函数来执行必要的初始化。# 这样,在类实例化时也可以指定其他函数参数,例如模型参数params(稍后将介绍)self.hidden = nn.Linear(20, 256) # 隐藏层self.out = nn.Linear(256, 10) # 输出层# 定义模型的前向传播,即如何根据

机器学习中,决策树是一个预测模型,树中每个节点表示某个对象,而每个分叉路径则代表某个可能的属性值,而每个叶节点则对应从根节点到该叶节点所经历的路径所表示的对象的值。例如,建立人口身高模型,很难有人力与物力去统计全国每个人的身高,但是可以通过采样,获取部分人的身高,然后通过最大似然估计来获取分布的均值与方差。随机森林算法(Random Forest)的名称由 1995 年由贝尔实验室提出的rando
