


- @2202_75946350


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
在字典中没有先后顺序删除指定元素用removepop只能弹出第一个元素Python为了高效 导入一次包之后不会再重复导入导入包之后可以使用包中的元素 也可以修改元素的值可以给包设置别名可以导入包里部分元素导入包的全部元素构造函数是两个‘_’组成doc同理可以删除属性值。
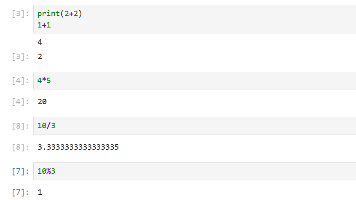
机器学习是从数据中自动分析获得模型,并利用模型对未知数据进行预测增加层数:通过更抽象的概念识别物体、器官层、分子层、原子层增加节点数:增加同一层物质的种类plt.xticks(x,**kwargs)x:要显示的刻度值plt.yticks(y,**kwargs)y:要显示的刻度值注意:第一个参数必须是数字 如果不是数字 需要进行值替换。

本文系统介绍了Numpy和Pandas两个Python科学计算核心库。Numpy部分重点讲解了ndarray数组的特性及优势(内存连续、并行运算、高效C实现),详细说明了数组生成、索引切片、形状修改、逻辑运算和统计运算等核心操作,并介绍了矩阵运算规则。Pandas部分以DataFrame为核心,阐述了其数据结构特点、索引设置方法、基本数据操作技巧,以及文件读取功能。两个库相互配合,Numpy提供高
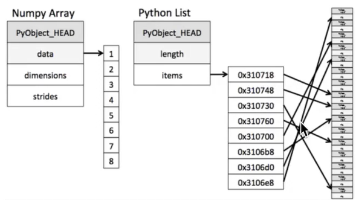
Pandas数据处理的核心操作:1)DataFrame的算术/逻辑/统计运算与自定义函数应用;2)数据可视化方法;3)文件读写(CSV/HDF5/JSON);4)缺失值检测与处理方法;5)数据离散化与one-hot编码;6)数据合并的concat/merge;7)交叉表与透视表分析;8)分组聚合操作。涵盖了从基础运算到高级分析的完整数据处理流程,适用于金融、零售等多领域数据分析场景。
相当于用较小的领域中的训练实例进行预测,“学习”近似误差会减小,只有与输入实例较近或相似的训练实例才会对预测结果起作用,与此同时带来的问题是“学习”的估计误差会增大,即。完全不足取,因为此时无论输入实例是什么,都只是简单的预测它属于在训练实例中最多的类,模型过于简单,忽略了训练实例中大量有用信息。根据KNN每次需要预测一个点时,我们都需要计算训练数据集里每个点到这个点的距离,然后选出距离最近的K个
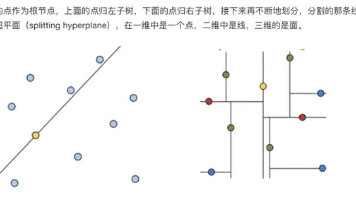
机器学习是从数据中自动分析获得模型,并利用模型对未知数据进行预测增加层数:通过更抽象的概念识别物体、器官层、分子层、原子层增加节点数:增加同一层物质的种类plt.xticks(x,**kwargs)x:要显示的刻度值plt.yticks(y,**kwargs)y:要显示的刻度值注意:第一个参数必须是数字 如果不是数字 需要进行值替换。
本文系统介绍了Numpy和Pandas两个Python科学计算核心库。Numpy部分重点讲解了ndarray数组的特性及优势(内存连续、并行运算、高效C实现),详细说明了数组生成、索引切片、形状修改、逻辑运算和统计运算等核心操作,并介绍了矩阵运算规则。Pandas部分以DataFrame为核心,阐述了其数据结构特点、索引设置方法、基本数据操作技巧,以及文件读取功能。两个库相互配合,Numpy提供高