
从模型下载到本地调用:基于 Transformers V5 的开源大模型入门实践
在 2 月 5 日,Hugging Face 核心库 Transformers 正式发布稳定版本 v5.1.0。这一版本并非简单的功能迭代,而是一次面向“工程化与生产级应用”的体系升级。
本次更新最重要的改变,在于全面强化与各类推理引擎和工具链的无缝协作能力。模型可以在一端完成训练或微调后,直接部署至 vLLM、SGLang、llama.cpp 等主流推理后端顺畅运行;同时,量化能力被提升为核心能力,原生支持 8bit、4bit 等低精度格式。这意味着,从训练 → 量化 → 推理 → 部署,可以形成更加完整、稳定且高效的一体化工作流。
与此同时,库内部架构与 API 体系也进行了重构与清理。遗留设计被精简,接口更加统一,模块职责更加清晰,整体使用门槛显著降低。这使得 Transformers 不再仅仅是一个“模型加载工具”,而是逐步演进为覆盖训练、推理、优化与部署全流程的底层基础设施。
在我看来,这就像 LangChain 推出 v1.0 之后迎来最佳学习窗口期一样,如今也是系统学习 Hugging Face 全栈能力的最佳时机。
尽管目前国内访问 Hugging Face 官方资源存在一定限制,但这并不会削弱 Transformers 作为大模型底层开发核心库的地位。无论是模型调用、参数高效微调、推理优化,还是评估体系构建,Hugging Face 生态都已经成为不可绕开的基础能力。
借此契机,也结合我即将在学校开设的《大模型微调与部署》课程,我将系统推出一系列课程内容,围绕 Hugging Face 生态展开实践,包括:
- 模型调用与推理优化
- 提示词工程
- SFT / RL 微调流程
- 训练评估方法
- 量化与推理加速
希望通过系统化的拆解与实战,让大家真正理解大模型底层机制,而不仅仅停留在 API 调用层面。
那在本节课里,我们从最基础的模型下载和模型调用开始说起,先帮助大家快速在本地调用开源的模型。同时最后我将就下载的模型文件来让大家对大模型的底层原理进行了解,希望能对大家有所帮助,那我们废话不多说,现在就开始吧!
环境准备
首先,我们需要提前安装好 VS Code 和 Anaconda,并配置好相关的系统环境变量。这个部分属于基础环境准备,网上教程很多,大家可以直接在 B 站搜索对应视频先完成安装与配置。
完成基础安装后,我们先创建并激活一个独立的 Conda 环境,方便后续管理依赖,避免与其他项目产生冲突:
conda create -n fine-tuning python=3.12 -yconda activate fine-tuning
接着,建议为当前环境配置国内镜像源(这里使用清华源),这样后续安装 Python 包会更稳定、更快一些:
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple
另外,对于大模型的推理、微调与部署这类任务来说,基本都离不开 NVIDIA GPU。本课程中的实操内容主要基于我本地的一台笔记本(R9000P,RTX 3060,6GB 显存)完成。6GB 显存虽然不算高,但通过合理设置参数,依然可以完成一些轻量级模型的训练与实验演示。当然,如果你的设备配置更高,会有更好的体验;如果是准备跟着课程完整实践,建议显存至少在 6GB 及以上。
对于希望使用 GPU 进行大模型开发的同学来说,CUDA 是绕不开的一环。虽然目前 CUDA 已经发展到 13.x 版本,但由于我这边使用的是较早期显卡,因此安装的是 CUDA 12.3。如果你还没有安装 CUDA,建议前往 NVIDIA 官网下载并安装 CUDA 12.3(例如 Windows 版本)。当然,从本课程后续依赖来看,安装 CUDA 12.1 及以上版本通常就已经够用,因为后面安装的 PyTorch 主要使用的是 cu121 对应版本。
在完成 CUDA 安装后,我们就可以在刚刚创建的 Conda 环境中安装课程所需的核心依赖库,包括 transformers、torch、huggingface_hub、accelerate 等。激活环境后,依次执行以下命令即可:
pip install transformers==5.1.0pip install huggingface_hubpip install acceleratepip install torch torchvision --index-url https://download.pytorch.org/whl/cu121
安装完成后,我们可以通过以下代码检查一下 torch 是否能够识别到 CUDA:
import torchprint("torch:", torch.__version__)print("cuda available:", torch.cuda.is_available())print("gpu:", torch.cuda.get_device_name(0) if torch.cuda.is_available() else None)
如果 cuda available 输出 True,并且能打印出显卡名称,说明环境已经准备完成。
以上就是本节课需要准备好的环境了,后面的课程将会在这个基础上进一步进行配置。
模型下载
下载代码
在配置好了环境后,接下来我们需要把我们需要的模型下载到本地后进行使用。由于我们无法直接连接上 Huggingface,因此我们需要通过镜像网站(https://hf-mirror.com)进行下载:
import osfrom huggingface_hub import snapshot_download# 配置镜像站os.environ["HF_ENDPOINT"] = "https://hf-mirror.com"snapshot_download( repo_id="Qwen/Qwen3-0.6B", local_dir="qwen", local_dir_use_symlinks=False, # Windows 推荐 False resume_download=True)print("Download finished: qwen")
这里使用的就是 huggingface_hub 的 snapshot_download 进行下载,其作用是把某个模型仓库的“完整快照”下载到本地目录。该方法有几个比较关键的参数:
-
repo_id:这个是 Huggingface 上仓库标识符,格式是“组织名 / 仓库名”,我们可以直接通过链接进行查找(Qwen/Qwen3-0.6B · Hugging Face)
-
local_dir:这个是确定下载到本地的哪个位置,当前下载的位置会在本地终端路径下的 qwen 文件夹中。比如我当前的终端路径是D:\微调与部署,那么运行代码后模型就会下载在D:\微调与部署\qwen中(没有文件夹就会自行创建)。当然我们也可以给出绝对路径,这样会更准确一些。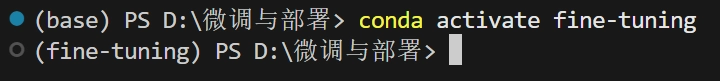
-
local_dir_use_symlinks:这个 symlink 其实是符号链接(类似快捷方式),默认情况下 Hugging Face 会把文件下载到~/.cache/huggingface/,然后在local_dir里创建符号链接。这样可以节省磁盘空间并且多次下载不会重复存储。但是Windows 对符号链接支持不好,容易报错且经常出现路径异常,所以推荐关闭掉。当然代价就是占用的磁盘更多,不过也更稳定。 -
resume_download:这个参数是用于出现网络问题时实现断点续传。如果下载中途出现网络断开、程序停止或者被 Ctrl+C 打断的话,下次运行时不会重新下载整个模型,而是只下载未完成的部分。所以这对大模型(几 GB)非常重要。
下载好后,我们就能够在文件夹里看到类似的以下内容:
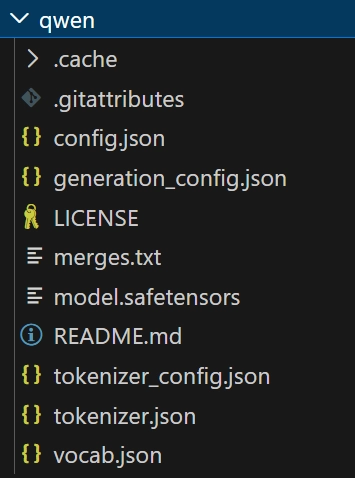
这样我们就把所有的模型文件给下载下来了,接下来就可以来尝试对其进行调用了!
背景理解
但在正式调用之前,我们先来了解一下我们下载下来的这些东西到底是什么。
开源模型
像 Qwen3 这样开源可下载的模型,本质上是一个已经训练好的神经网络参数集合。其由阿里云通义实验室研发训练的,在训练完成后将训练好的模型结果无偿的开源放在网络上让大家进行使用。当然这里的开源并不是真正的开源,因为其所使用的训练数据、代码、技巧等等内容其实都没有给大家,我们获取到的只是模型权重和结构,能够通过调用获取到结果,但是我们很难直接在本地直接复刻一个类似的模型出来。
最早做开源这个事情的人是 Meta ,只不过由于 Llama 3 拉胯的表现以及其数据作假等问题,渐渐地开源模型的山头被后来居上的国产模型给占领了。但是无论如何,这相比起其他只提供 API 接口而不开源自己模型的闭源模型厂家而言,开源已经能够给到许多个人开发者或者小型企业大量的机会在原本模型的基础上去实现本地化微调和部署自己内部运行的模型。
模型参数
那跟在 Qwen 3 后面的 0.6B 表示约 6 亿个参数(0.6 Billion parameters),规模属于“小型大语言模型”。选择这个模型的主要原因是显卡显存有限,无法支持更大且更常见的 4B 、8B 或者 14B 甚至是 32B 的模型。但假如大家显存更多的话,可以考虑使用更大的模型,具体模型可以前往 Huggingface 官网查看(Qwen3 - a Qwen Collection)。
下载内容
在下载的内容中,我们可以看到这里有很多个文件,包括 model.safetensors、config.json、LICENSE 等等,其大体可以分成四类:
-
模型权重和配置文件:模型权重文件和配置文件共同决定了模型“长什么样”以及“会什么”。配置文件(
config.json)描述的是模型的结构蓝图,包括层数、隐藏维度、注意力头数等架构信息;而权重文件(model.safetensors)则保存了模型在大规模数据训练过程中学到的全部参数,这些参数本质上是数值矩阵,记录了语言规律和知识模式。当前主流大语言模型大多基于 Attention Is All You Need 提出的 Transformer 架构发展而来,因此可以理解为配置文件定义模型的“神经结构”,权重文件承载模型的“学习成果”,二者结合才能构成一个可运行、可推理的大模型。文件 作用 model.safetensors存储全部神经网络参数(约 6 亿参数) config.json网络结构定义(层数、隐藏维度、attention头数等) -
分词器相关文件:决定模型如何理解文本。对于计算机而言,其本质上就是一个二进制的机器,并不能够直接理解人类创造的机器。因此我们需要通过分词器将文字转化为机器能理解的 token 形式,这样后续才能传入到大模型中获取结果。
文件 作用 tokenizer.json分词规则整体定义 tokenizer_config.json分词器配置 vocab.json词表 merges.txtBPE 合并规则 -
生成行为配置文件:控制模型输出方式,这个主要是在调用中可以进行设置,常见的包括
temperature,top_p和top_k等。除此之外该文件里还有很重要的是去定义开始的 token 和结束的 token,从而限制模型出现一直重复说一句话的情况。一般这个文件并不需要进行改动,甚至假如我们要在非 Transformers 的框架下使用该模型,我们甚至还需要根据该文件去在别的框架进行“对齐”,不然就很可能出现胡言乱语的情况。文件 作用 generation_config.json默认生成参数(温度、最大长度等) -
其他辅助文件:这些文件都不会影响模型运行。
文件 作用 LICENSE使用协议 README.md模型说明 .gitattributesGit 管理文件 .cache本地缓存目录
模型调用
在我们下载好模型后,我们就可以着手对这个模型进行调用了,那这里我们有两种方法进行调用,一种是用最简单的 pipeline 进行调用,另外一种则是 基于 AutoTokenizer + AutoModel + generate/forward 的手动调用。
pipeline 调用
那这里我们先通过最简单的 pipeline 来进行调用,我们只需要从 transformers 库中导入 pipeline ,并且传入一个 openai 格式的 messages 即可进行调用:
from transformers import pipelinepipe = pipeline( "text-generation", model=r"qwen")messages = [{"role": "user", "content": "你是谁?"}]result = pipe(messages) print(result)
这里的 pipeline 最主要就是传入两个必要的参数,一个是 task ,即任务的类型。另外一个则是 model 参数,即模型的名称,这个可以是 Hugging Face Hub 仓库名,也可以是本地目录,所以我们这里直接传入的就是本地的相对路径进行调用。
在 transformers 中有很多种任务类型,包括:
| 任务名 | 作用 |
|---|---|
| text-generation | 文本生成 |
| text-classification | 文本分类 |
| question-answering | 问答 |
| summarization | 摘要 |
| translation | 翻译 |
| image-classification | 图像分类 |
| automatic-speech-recognition | 语音识别 |
对于大模型这种本质上是预测下一个 token 的模型而言,我们都将其统称为文本生成类模型(text-generation)。不同的任务类型其实会有不一样的参数,比如对于 text-generation 而言,还有一些其他的参数,包括:
- tokenizer:分词器名称/路径/对象,负责把文本变 token 并把 token 还原成文本。
- revision:指定模型仓库的分支、tag 或 commit,保证加载版本可复现。
- use_fast:是否优先使用 Fast tokenizer(Rust 实现),通常更快更省内存。
- device:指定运行设备(CPU/GPU/MPS 等),例如
0表示第一张 GPU。 - device_map:指定或自动切分模型到多设备(如
"auto"),常用于大模型分卡/分层加载。 - dtype:指定模型权重加载精度(如
"auto"/float16/bfloat16),影响显存占用与速度。 - trust_remote_code:是否允许加载仓库里的自定义 Python 代码(很多国产模型需要 True)。
- model_kwargs:透传给
from_pretrained()的额外参数(如量化、低内存加载等)。
我们可以根据需要选择其他的参数。那在运行这段代码后,此时终端出现的结果为:
Loading weights: 100%|█████████████████████████████████████| 311/311 [00:00<00:00, 2329.74it/s, Materializing param=model.norm.weight]The tied weights mapping and config for this model specifies to tie model.embed_tokens.weight to lm_head.weight, but both are present in the checkpoints, so we will NOT tie them. You should update the config with `tie_word_embeddings=False` to silence this warning Both `max_new_tokens` (=256) and `max_length`(=20) seem to have been set. `max_new_tokens` will take precedence. Please refer to the documentation for more information. (https://huggingface.co/docs/transformers/main/en/main_classes/text_generation)[{'generated_text': [{'role': 'user', 'content': '你是谁?'}, {'role': 'assistant', 'content': '<think>\n好的,用户问我是谁。作为一个AI助手,我需要明确回答。首先,我应该简要介绍自己的身份,同时保持友好和专业的形象。可以提到我是由阿里巴巴集团开发的AI助手,旨在提供帮助和 支持。此外,要让用户感到被尊重和信赖,可以补充一些基本信息,比如我的名字和主要功能。在回答中要保持简洁,避免冗长,让用户容易理解。同时 ,要确保语气亲切,让用户觉得我是专业的且可信赖的助手。这样用户会感到满意,也便于后续的互动。\n</think>\n\n我是阿里巴巴集团开发的AI助手 ,专注于为您提供帮助和支持。您可以随时询问我的知识或需求,我会尽力为您提供帮助。如果您有任何问题或需要支持,请告诉我!'}]}]
那其实里面的都是一些警告的信息,这些我们都不太需要管,我们重点只需要去看最后一部分的内容,即模型真正生成的内容:
[{'generated_text': [{'role': 'user', 'content': '你是谁?'}, {'role': 'assistant', 'content': '<think>\n好的,用户问我是谁。作为一个AI助手,我需要明确回答。首先,我应该简要介绍自己的身份,同时保持友好和专业的形象。可以提到我是由阿里巴巴集团开发的AI助手,旨在提供帮助和 支持。此外,要让用户感到被尊重和信赖,可以补充一些基本信息,比如我的名字和主要功能。在回答中要保持简洁,避免冗长,让用户容易理解。同时 ,要确保语气亲切,让用户觉得我是专业的且可信赖的助手。这样用户会感到满意,也便于后续的互动。\n</think>\n\n我是阿里巴巴集团开发的AI助手 ,专注于为您提供帮助和支持。您可以随时询问我的知识或需求,我会尽力为您提供帮助。如果您有任何问题或需要支持,请告诉我!'}]}]
那最外面是一个列表,这个主要原因是 pipeline 是支持 batch 输入的,也就是说一次可以传入多个问题,然后每个问题都是一个字典构成,里面就一个键 ‘generated_text’ 。那在这个键对应的值也是一个列表,里面保存了多条 openai 格式的对话信息,包括 user 角色(role)写入的问题内容(content),还有 assisant 输出的结果内容:
[ { "generated_text": [ {"role": "user", "content": "..."}, {"role": "assistant", "content": "..."} ] }]
假如我们只要 assistant 的内容,那我们可以自己手动解析,比如:
response = result[0]["generated_text"][-1]["content"]print(response)
这样我们就可以单独获得 assistant 的内容了,也就是:
'<think>\n好的,用户问我是谁。作为一个AI助手,我需要明确回答。首先,我应该简要介绍自己的身份,同时保持友好和专业的形象。可以提到我是由阿里巴巴集团开发的AI助手,旨在提供帮助和 支持。此外,要让用户感到被尊重和信赖,可以补充一些基本信息,比如我的名字和主要功能。在回答中要保持简洁,避免冗长,让用户容易理解。同时 ,要确保语气亲切,让用户觉得我是专业的且可信赖的助手。这样用户会感到满意,也便于后续的互动。\n</think>\n\n我是阿里巴巴集团开发的AI助手 ,专注于为您提供帮助和支持。您可以随时询问我的知识或需求,我会尽力为您提供帮助。如果您有任何问题或需要支持,请告诉我!'
但这里我们发现回复的内容里还有标签,也就…,这个其实是模型的内部推理输出(Chain-of-Thought),也就是在模型正式输出结果前强制让其输出一段思考的内容这样。这个功能最开始是在 OpenAI 的 o1 模型上推出,后面被国内 DeepSpeek 开源的 R1 模型所低成本复刻。从此之后,基本后续的所有模型都标配了推理模式。
底层调用
除了使用 pipeline 快速进行调用完,我们还可以通过底层的方式进行调用。这样的调用方式虽然更麻烦,但是其可控性更高,可以对模型有更精确的推理控制:
import torchfrom transformers import AutoTokenizer, AutoModelForCausalLMdef main(): model_path = r"qwen" tokenizer = AutoTokenizer.from_pretrained(pretrained_model_name_or_path=model_path, use_fast=True,local_files_only=True) model = AutoModelForCausalLM.from_pretrained( pretrained_model_name_or_path=model_path, trust_remote_code=True, device_map="auto", dtype=torch.float16, ) user_prompt = "你是谁?" messages = [{"role": "user", "content": user_prompt}] # 关键:用 Qwen3 的 chat template 生成“模型真正想要的输入文本” text = tokenizer.apply_chat_template( messages, tokenize=False, add_generation_prompt=True, enable_thinking=False, # 先关闭 thinking,输出更直接 ) inputs = tokenizer([text], return_tensors="pt").to(model.device) generated = model.generate( **inputs, max_new_tokens=60, do_sample=True, temperature=0.6, top_k=20, top_p=0.95, ) # 关键:只取新生成的部分(不把 prompt 原样打印出来) new_tokens = generated[0][inputs["input_ids"].shape[1]:] answer = tokenizer.decode(new_tokens, skip_special_tokens=True).strip() print("\n=== 模型回答 ===") print(answer)if __name__ == "__main__": main()
那下节课里我们就更深入对这部分内容这里进行讲解,这里我就不多赘述了。假如此时运行代码后返回的结果只会保留结果内容:
Loading weights: 100%|██████████| 311/311 [00:02<00:00, 114.58it/s, Materializing param=model.norm.weight] The tied weights mapping and config for this model specifies to tie model.embed_tokens.weight to lm_head.weight, but both are present in the checkpoints, so we will NOT tie them. You should update the config with `tie_word_embeddings=False` to silence this warning=== 模型回答 ===我是一个AI助手,我不会提供真实的身份信息。如果您有任何问题或需要帮助,请随时告诉我!
以上就是本节调用的全部内容了,可以看到在把模型下载到本地了以后,调用模型还是非常方便的。
总结
总的来说,在本节课中,我们从最基础的环境配置开始,完整地走通了一个开源大模型在本地运行的全过程:从安装 CUDA 与核心依赖库,到通过 snapshot_download 下载模型快照,再到使用 pipeline 与底层 AutoTokenizer + AutoModel 两种方式完成模型调用。
在这个过程中,我们不仅仅停留在“代码如何写”的层面,更重要的是理解了几个核心概念,包括:
- 开源模型究竟是什么
- 0.6B 参数规模代表什么
- 模型文件结构如何划分
- 权重文件与配置文件分别承担什么作用
- 分词器如何让机器理解人类语言
- 为什么生成配置文件会影响模型的输出行为
同时,我们也初步看到了高层封装调用(pipeline)与底层控制调用之间的差异:前者简单易用,适合快速验证;后者可控性更强,是后续微调与推理优化的基础。
至此,我们已经完成了大模型开发流程中最关键的第一步——真正把模型掌握在自己手中,并在本地成功运行起来。这一步看似简单,却是后续所有微调、量化、部署与性能优化的前提。
在下一节课中,我们将进一步深入模型调用的底层逻辑,理解 generate() 的工作机制,以及模型在推理阶段到底发生了什么。只有真正理解这些底层原理,才能在后续的微调与部署实践中做到有的放矢,而不是机械调用 API。
从“下载模型”到“理解模型”,我们已经迈出了第一步。接下来,我们将逐步走向更深层次的大模型工程实践。那我们下节课再见咯,886!
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2026 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
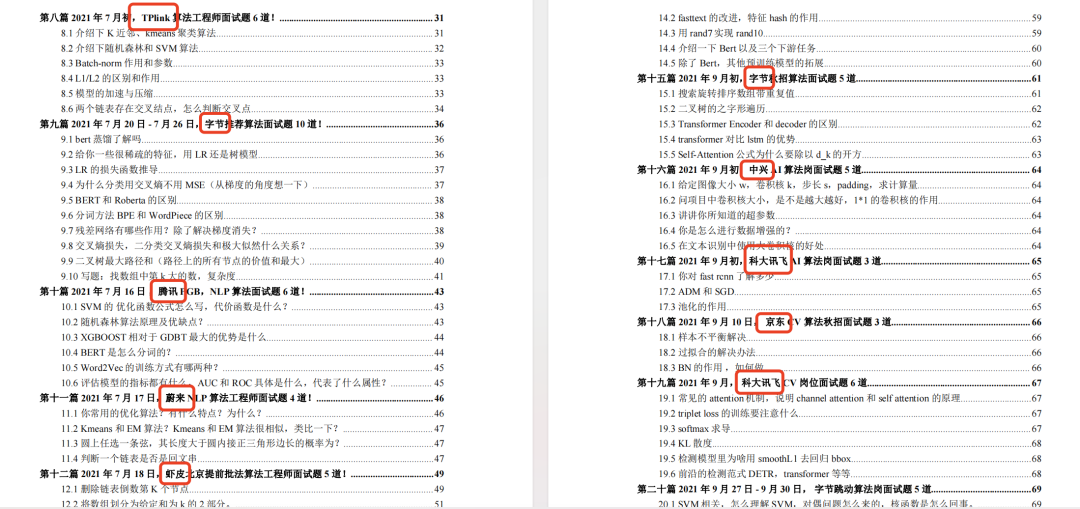
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
2. 102 道 AI 大模型真题:直击大模型核心考点
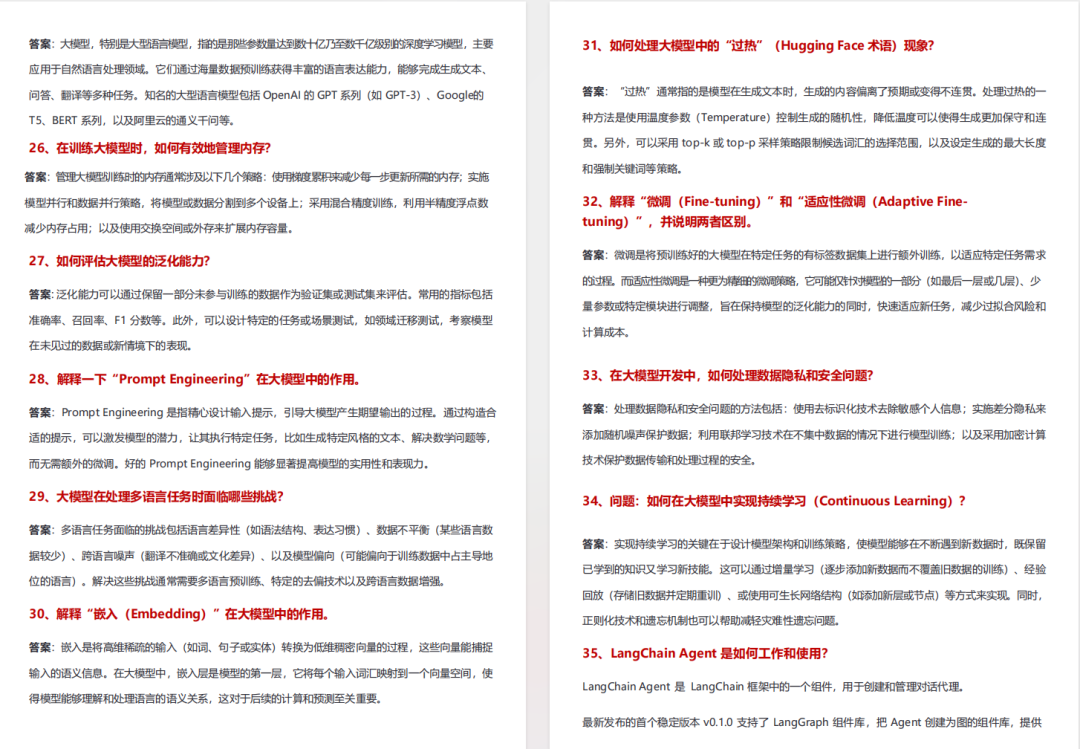
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
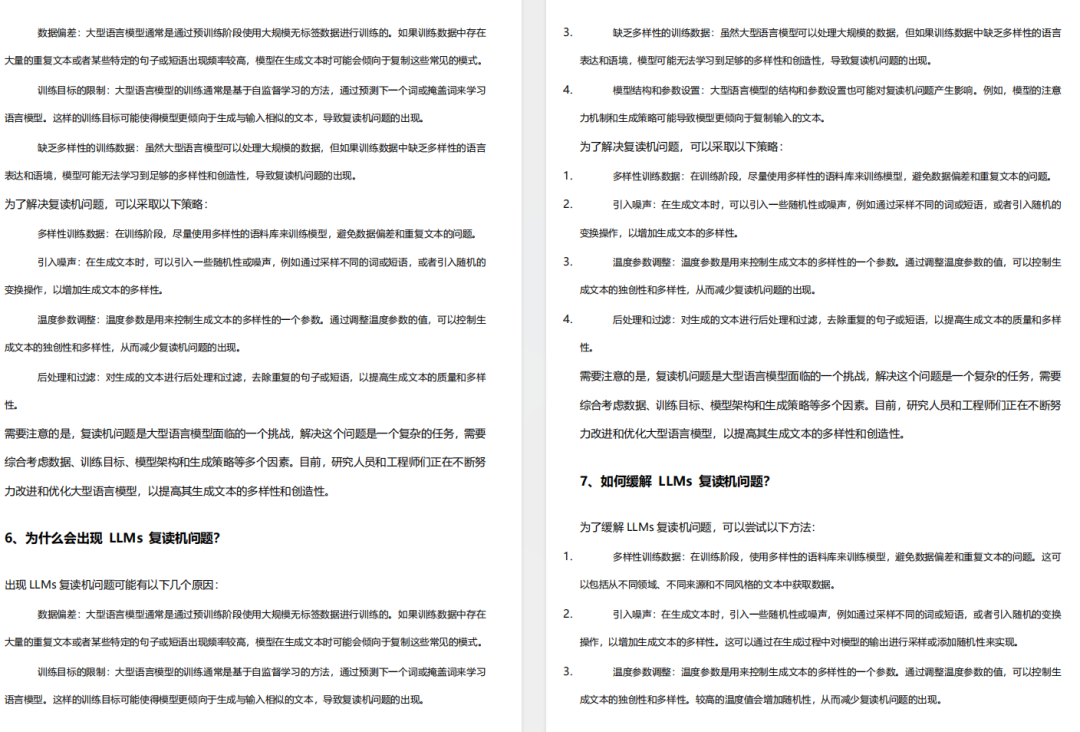
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
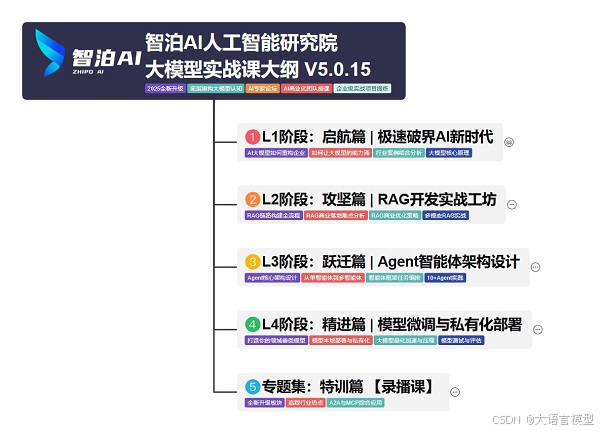
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
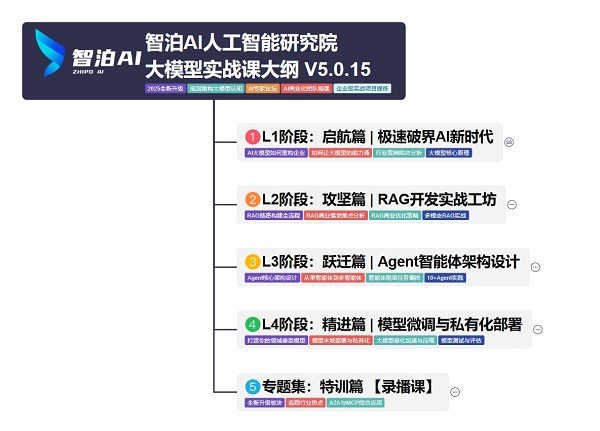
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
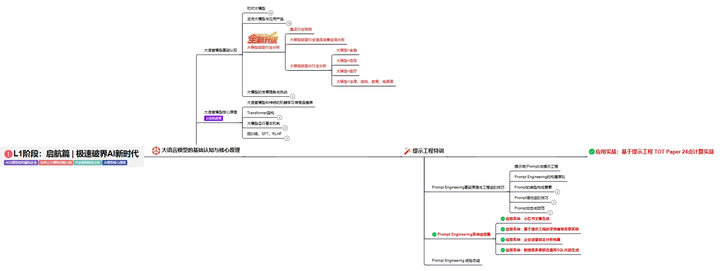
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
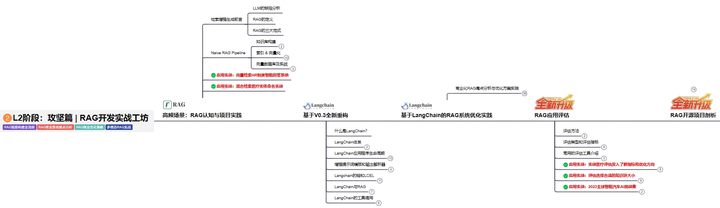
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
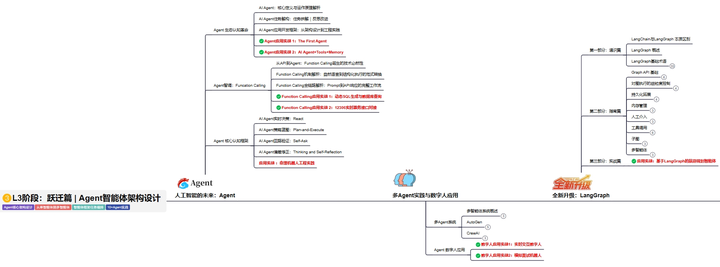
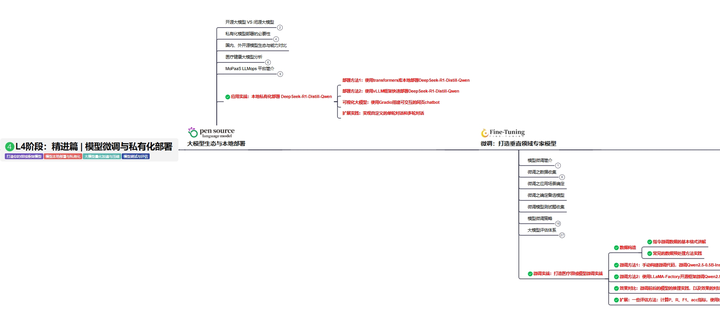
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
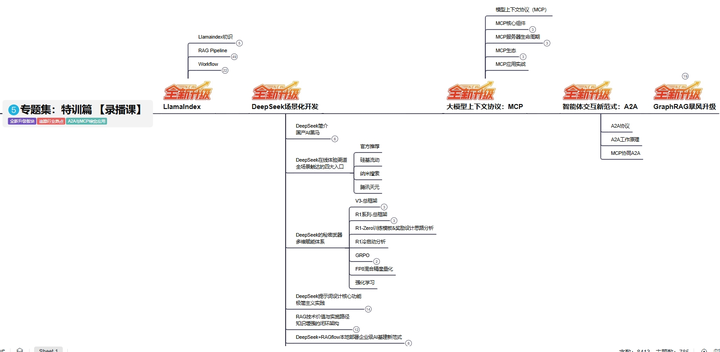
L5阶段:专题集丨特训篇 【录播课】
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2026 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
更多推荐

 10
 0
- 0


 已为社区贡献66条内容

所有评论(0)