


- @whqwhqwhqxaut


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
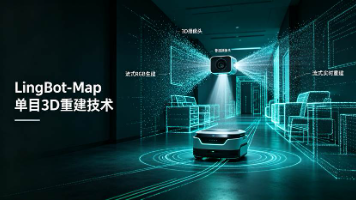
随着机器人一步步往前走,它周围的三维世界——墙壁、门框、办公桌、走廊尽头的窗户——在它的"大脑"中实时生长出来。本文将从LingBot-Map的核心设计理念出发,全面拆解其GCT(Geometric Context Transformer)架构的三大记忆池、分页KV缓存与FlashInfer加速机制、多基准性能测试结果、基于demo.py和batch_demo.py的部署方法,以及与COLMAP/
六阶段流水线——图像采集(工业相机+环形光源+遮光罩+多角度拍摄)→图像预处理(去噪+色彩校正+对比度增强+背景分割)→果实检测与分割(YOLOv8-seg/Mask R-CNN/SAM,从整串到单果)→成熟度识别(颜色特征+HSV/Lab分析+红色占比量化+CNN分类器ResNet/EfficientNet,四级成熟度)→缺陷检测与质量评估(目标检测/语义分割/异常检测,病虫害/损伤/腐烂/空串

基于开源ABot体系,一次典型的机器人侦查任务流程如下:①任务下发(云端或自然语言指令)→②自主导航(先验地图+实时SLAM定位,路径规划与动态避障)→③环境感知(多模态数据采集,三维建图与目标检测)→④数据采集(对重点目标近距多角度采集,红外/气体传感器补充)→⑤智能分析(VLA模型推理,异常判定与语义理解)→⑥结果上报(告警推送、巡检报告、云端同步)。①云端大脑-边缘响应两级设计:重模型(VL
在化工厂区、电力管廊、地下泵站、钢铁与水泥产线,大量巡检点位分布在台阶之上、管道之间、狭窄通道和高温、高噪、有气体风险的区域。对完全遮挡、密闭柜内设备,视觉同样无能为力。机器狗在运动、云台在转动、雷达在旋转,如果不标定,画面里的像素无法对应到狗身或世界坐标,仪表定位、热点叠加、机械臂近摄都会出错。一台完整的视觉巡检狗,典型负载包括:主巡检负载(双光谱云台)、导航感知(激光雷达/深度相机,部分机型已

相机以约 2m/s 的速度在室内移动,定位和建模都要在机载端实时完成,连续运行 10–15 分钟,最终输出能分辨门、窗、大件物体的稠密点云或三维模型。VIO 用高频 IMU 补视觉的不足、用视觉纠正 IMU 的漂移,实时输出带真实尺度的位姿。时间同步在 2m/s 下尤其关键——10ms 的时间戳误差就对应约 2cm 的位置误差,标定和同步没做好,后面全是系统性偏差。意味着视觉和IMU 在同一个优化

而以 Lely、DeLaval 为代表的自由进出式挤奶机器人(AMS,Automatic Milking System),则把挤奶从"集中排班"变成了"奶牛随时来、机器人随时挤"——奶牛一天可以挤 4–6 次,产奶量和奶牛福利都更好,但这对"自动套杯"的可靠性提出了极高要求。乳头定位 +自动吸奶,正是农业机器人里少有的"刚需、高频、能算清账"的场景——把这件事做扎实,牧场才真正从"靠人盯着挤奶"走

把 YOLO 从训练环境搬到国产算力上,真正难的不是跑通,而是把每一毫秒、每一分精度都榨出来。

上下料、装配、码垛、分拣这四类工序,机器人的作业精度往往卡在同一个地方——。视觉引导定位就是用相机测出工件的(X/Y/Z 三个位置 + 偏航/俯仰/横滚三个姿态角),再通过把像素坐标换算成机器人坐标,引导抓放。(来料偏差、姿态种类、精度、节拍)、(九点标定、eye-to-hand/eye-in-hand、OpenCV 代码)、(四种 3D 相机对照)、(误差链 RSS 合成、节拍预算、99% 成功

上下料、装配、码垛、分拣这四类工序,机器人的作业精度往往卡在同一个地方——。视觉引导定位就是用相机测出工件的(X/Y/Z 三个位置 + 偏航/俯仰/横滚三个姿态角),再通过把像素坐标换算成机器人坐标,引导抓放。(来料偏差、姿态种类、精度、节拍)、(九点标定、eye-to-hand/eye-in-hand、OpenCV 代码)、(四种 3D 相机对照)、(误差链 RSS 合成、节拍预算、99% 成功
从x86+GPU迁移到华为昇腾Atlas 300I Duo,你要面对的是一套完全不同的软件栈:驱动、固件、CANN工具包、ATC模型转换、OM格式推理……版本下载页面要注意选对三个条件:产品系列选"加速卡"、产品型号选"Atlas 300I Duo 推理卡"、CANN版本选8.5.0。PyTorch的.pt模型不能直接在NPU上跑,必须先转成ONNX,再用ATC工具转成昇腾专属的OM格式。open
