
OpenWhispr语音转文字听写应用:本地模型隐私优先
语音转文字(Speech-to-Text, STT)是人工智能最成熟的落地应用之一,从手机输入法到会议纪要、从字幕生成到语音助手,语音转文字已经深度嵌入我们的工作和生活。然而,主流语音转文字工具大多依赖云端处理——音频上传到云端服务器,经过大模型识别后返回文字。这种模式虽然方便,却存在三个绕不开的痛点:隐私泄露风险(敏感对话、商业机密、医疗信息的音频被上传到第三方服务器,一旦泄露后果严重)、网络依赖(断网/弱网环境下无法使用,网络延迟影响体验)、持续成本(云端转写按分钟计费,高频使用成本可观,还有账号、订阅、数据被平台留存的问题)。
OpenWhispr 正是针对这些痛点诞生的开源语音转文字听写应用——隐私优先、完全本地、跨平台。它让你按住一个热键说话,松开后文字自动出现在光标处,全程在设备本地完成,音频不出设备、无需联网、无需账号、无遥测数据。核心引擎基于 OpenAI Whisper(whisper.cpp 高性能 C/C++ 移植版)和 NVIDIA Parakeet(sherpa-onnx 推理框架),支持 99+ 种语言,从 tiny 到 turbo 多档模型自由切换,免费开源,适用于 macOS、Windows、Linux 三大平台。无论你是开发者、作家、记者、医生、律师还是普通办公用户,OpenWhispr 都能把"说话速度"变成"写作速度",同时守住数据隐私的底线。
本文将从项目背景与核心价值、技术架构与本地推理引擎、安装配置与模型管理、核心功能详解、开发集成、性能优化、产品对比、应用场景、挑战与未来趋势等维度,系统阐述 OpenWhispr 的完整使用与实战方法,为语音技术爱好者、隐私敏感型用户、开发者提供一份可落地的实操指南。
一、OpenWhispr是什么:项目背景与核心价值
1.1 项目背景
OpenWhispr 是 2025-2026 年快速崛起的一个开源语音转文字听写应用生态。它最初源于开发者对"本地化语音听写"的需求——当时主流的听写工具要么依赖云端(如 Otter.ai、Rev、讯飞听见),要么在本地体验糟糕(如操作系统自带听写的准确率和延迟问题)。同时,whisper.cpp 等本地推理引擎的成熟,让"在消费级设备上实时运行 Whisper 大模型"成为可能。OpenWhispr 把这些能力整合成一个即装即用的桌面应用:按热键说话,松开即出文字,光标处自动粘贴,支持任何应用。
OpenWhispr 生态包含两个相关联的开源项目:①open-whispr(GitHub 用户 nilsplum 维护):早期开源项目,聚焦"按住说话,松开出字"的极简核心体验,基于 whisper.cpp + Metal 加速,100% 本地处理,MIT 开源协议,无账号、无遥测、无订阅,体积小、理念纯粹;②openwhispr(openwhispr/openwhispr 主仓库):更完整的跨平台应用,在核心听写之上增加了 AI 智能体(AI Agents)、会议转写、笔记、音频文件转文本等能力,支持本地引擎(Whisper/Parakeet)与云端引擎(OpenWhispr Cloud)双模式,提供 macOS、Windows、Linux 桌面版与移动 App,核心功能免费,Pro 版(8美元/用户/月)解锁无限云端转写和更多会议时长。
OpenWhispr 的价值主张可以概括为四个关键词:隐私优先(本地处理,音频不出设备,无账号无遥测,开源可审计)、免费开源(MIT 协议,核心功能完全免费,可自行构建、修改、分发)、跨平台(macOS/Windows/Linux 全覆盖,一次配置处处可用)、模型自由(OpenAI Whisper 全系模型 + NVIDIA Parakeet 多语种模型自由切换,兼顾准确率与速度)。
1.2 核心价值:为什么选择本地语音转文字
在云端 AI 服务遍地开花的今天,OpenWhispr 坚持"本地优先"并不是逆潮流,而是解决了一批真实场景的刚需:
①数据隐私与合规:医生口述病历、律师起草法律文书、记者采访录音、金融从业者撰写报告、研发人员记录技术方案——这些场景的语音内容高度敏感,上传云端意味着把商业秘密和个人隐私交给第三方。本地处理让音频自始至终留在设备上,从物理上杜绝泄露路径。对于受 HIPAA(美国医疗隐私法案)、GDPR(欧盟数据保护条例)、《个人信息保护法》(中国)等法规约束的行业,本地处理是合规的硬性要求。OpenWhispr 的离线模式(air-gapped)甚至可以在完全不联网的隔离环境中运行,满足军工、政府、涉密单位的保密要求。
②零网络依赖:飞机上、地铁里、偏远地区、网络不稳定的场景,云端转写完全不可用;本地转写只要有电就能用。对于经常出差的商务人士、户外记者、驻场工程师,离线能力不是加分项而是必备项。同时,本地处理没有网络延迟——音频不经过上传-排队-识别-下载的往返链路,语音结束后几百毫秒内即可得到文字,体验更流畅。
③长期成本可控:云端转写通常按分钟或小时计费(如 0.6元/分钟),高频用户(每天听写 2 小时)每月成本数百元;本地转写只有一次性的硬件投入(模型运行在已有设备上),模型下载后永久免费使用。OpenWhispr 完全开源,连软件授权费都是零。
④模型自由与可控:云端服务只能使用平台提供的模型和参数;本地部署让你自由选择 Whisper tiny/base/small/medium/large/turbo 任何档位,在准确率和速度之间自主权衡,还可以针对特定领域(医学术语、法律术语、编程词汇)使用自定义词典优化识别,甚至接入 NVIDIA Parakeet、Qwen3、Mistral 等其他模型,完全掌控识别引擎。
⑤零账号零追踪:不需要注册账号、不采集遥测数据、不存储你的音频和文字。装上就能用,卸载不留痕。开源代码可以在 GitHub 上完整审计,没有黑箱。
⑥AI 智能体能力:OpenWhispr 不止于"语音转文字",还能通过可配置的 AI Agent 对转写文本做后处理——去掉语气词(um、uh、嗯、啊)、整理段落、生成会议纪要要点、翻译、润色、格式化,把"原始转写"升级为"可用成稿"。本地模型模式下,连 LLM 后处理都在本地完成,形成全链路隐私保护。
1.3 适用人群
①开发者/程序员:
语音写代码注释、口述技术文档、在终端/IDE/Slack/GitHub 中语音输入,一个热键全局可用,无需为每个编辑器装插件。开发者还可以基于开源代码二次开发,集成到自己的工具链。
②作家/内容创作者:
口述初稿(写小说/文章/剧本时先说后写),速度是打字的三到五倍,且更接近自然的思维流;本地处理保证未出版稿件永不离开设备。
③医疗/法律/金融从业者:
病历记录、法律文书起草、尽调报告撰写,语音输入+本地处理+自定义专业术语词典,兼顾效率与合规。
④记者/研究员:
采访录音转文字、会议纪要、讲座笔记,音频文件批量转文本,支持 MP3/WAV/M4A 等多种格式,离线可用。
⑤办公/商务人士:
邮件、报告、Slack/微信消息、PPT 备注,按住热键说话代替打字,多语言(中英日韩法等99+语言)自动识别。
⑥隐私敏感型用户:
任何不想让语音数据上云的用户——本地模型、无账号、无遥测,用开源代码自己审计。
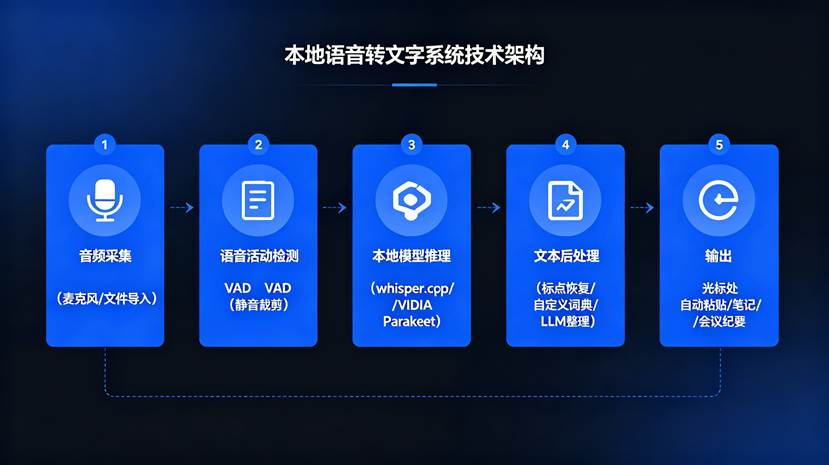
本地语音转文字系统技术架构流程图:音频采集→语音活动检测VAD(降噪/端点检测)→本地模型推理(whisper.cpp/Parakeet)→文本后处理(标点恢复/数字转换/LLM整理)→输出(原始文本/结构化标记/会议纪要)
OpenWhispr 的技术架构可以拆解为五个核心环节:音频采集 → 语音活动检测(VAD)→ 本地模型推理 → 文本后处理 → 输出。理解每一环节的技术原理,有助于你正确配置参数、诊断问题、优化体验。
2.1 音频采集:从麦克风到音频文件
音频采集是整个流程的起点。OpenWhispr 在按下热键时开始录音,松开热键时停止录音,将录音保存为临时音频文件。关键点:
①采样率与位深:
Whisper 系列模型要求的输入采样率是 16000Hz(16kHz 单声道),这是语音识别的标准采样率(语音主要能量集中在 300Hz-3400Hz)。OpenWhispr 在采集时会统一将麦克风输入重采样到 16kHz/16bit 单声道 WAV 格式,再送入识别引擎。即使你的麦克风采样率是 48kHz,也会自动降采样,保证输入格式与模型要求一致。
②麦克风选择与设备管理:
系统会枚举所有可用音频输入设备(内置麦克风、外接 USB 麦克风、耳机麦克风、专业声卡),可在设置中选择默认输入设备。对于追求转写质量的重度用户,推荐使用近讲式麦克风(如领夹麦、头戴麦)或高质量 USB 麦克风,减少环境噪声和混响;使用内置麦克风时尽量靠近声源(30cm 以内)。
③临时文件管理:
录音先写入临时文件(内存映射或磁盘临时目录),识别完成后立即删除。open-whispr 的早期版本设计是:音频进入临时文件→本地 Whisper 识别→文字输出→临时文件即刻删除,全程零网络请求。这样即使应用崩溃,也不会在磁盘上留下语音残留。
④音频文件导入:
除了实时麦克风听写,OpenWhispr 还支持拖拽音频文件转文本(音频转文字模式),支持 MP3、WAV、M4A、AAC、OGG、FLAC、WMA 等主流格式,自动解析时长、采样率、声道数,内部统一转码为 16kHz 单声道后识别。这个模式适合批量处理会议录音、采访录音、讲座音频、语音备忘录。
2.2 语音活动检测(VAD):端点检测与静音裁剪
VAD(Voice Activity Detection)用于判断"什么时候有人在说话"——找到语音的起点和终点,裁剪掉开头和结尾的静音,避免把环境噪声当作语音送入模型。VAD 的价值:①减少识别噪声:
静音段不送入模型,模型专注处理实际语音,降低环境噪声干扰和幻觉输出(Whisper 在纯静音/噪声输入下可能产生幻觉文本);②提升速度:裁剪后的音频更短,模型处理更快;③分段处理:长音频按静音切分为多个语音段,分段识别再拼接,支持任意长度的音频输入。
常用的 VAD 方案:①能量阈值法:
基于短时能量和过零率判断语音/静音,简单快速,适合噪声较小的环境,OpenWhispr 中用于快速端点检测;②WebRTC VAD:Google WebRTC 提供的经典 VAD(GMM 模型,支持 0-3 档灵敏度),计算量小、实时性好,广泛用于浏览器和桌面应用;③Silero VAD:基于 ONNX 的神经网络 VAD,精度高、抗噪能力强,支持流式处理,是 whisper.cpp/faster-whisper 生态常用的增强 VAD(可通过 --vad 参数启用);④能量+模型混合:先用能量阈值粗定位语音段,再用 Silero/WebRTC 精修边界,兼顾速度与精度。
VAD 参数配置直接影响听写体验:灵敏度太高会把安静环境中的轻微噪声当成语音(产生空白文字),灵敏度太低会裁掉语音首尾(丢字)。OpenWhispr 提供自动模式(根据环境噪声自适应),也允许手动调节灵敏度。对于持续说话的长段落(如口述文章),还可以关闭自动分段或调大静音阈值,避免把"思考停顿"误判为说话结束。
2.3 本地模型推理:whisper.cpp 与 NVIDIA Parakeet 双引擎
本地模型推理是 OpenWhispr 的核心,它支持两个主流推理引擎,分别对应两种模型生态:
①whisper.cpp(OpenAI Whisper 的 C/C++ 高性能移植版):
whisper.cpp 是 GitHub 上最活跃的 Whisper 推理实现之一(由 ggerganov 主导),零 Python 依赖、纯 C/C++ 实现,支持 CPU(AVX/AVX2/NEON SIMD 加速)、GPU(CUDA/OpenCL/Metal/Vulkan 后端)、Apple Silicon(Metal 加速)、甚至移动端和嵌入式设备。支持 GGML 量化格式(Q4_0/Q4_K/Q5_0/Q5_K/Q8_0),模型大小和内存占用大幅缩减(large-v3 原始 FP16 约 3GB,Q5_K 量化后约 1GB,Q4 约 500MB),在消费级硬件上即可实时运行。OpenWhispr 使用 whisper.cpp 作为默认引擎,通过 Metal 加速在 Mac 上获得极佳性能(Apple Silicon 上 large-v3 可达 5-10 倍实时速度),Windows/Linux 上则使用 CPU SIMD 或 CUDA/Vulkan GPU 加速。
②sherpa-onnx + NVIDIA Parakeet(多语种快速转写引擎):
NVIDIA Parakeet 是英伟达 2024-2025 年推出的新一代自动语音识别(ASR)模型系列(Parakeet TDT 0.6B v2 等),基于 FastConformer 架构,在多个基准上刷新 SOTA(如 LibriSpeech 词错误率 WER 低至 1.9% 左右),支持 25 种语言。sherpa-onnx 是 k2-fsa 社区推出的跨平台推理框架,支持 ONNX 格式 ASR 模型(包括 Parakeet、Zipformer、Whisper、SenseVoice 等),CPU/GPU 均可运行,无需 Python 环境。OpenWhispr 集成 sherpa-onnx 后,用户可以下载 Parakeet 模型,获得比 Whisper 更快的推理速度和更低的资源占用,特别适合对实时性要求高的场景(如会议实时转写)。
③其他本地模型(可选扩展):
OpenWhispr 的模型管理还支持通过 llama.cpp 运行 Qwen3(0.6B/1.7B/4B/8B/32B 多档)、Mistral 7B、LLaMA 等大语言模型,用于转写文本的 LLM 后处理(整理、润色、摘要)——这意味着不仅语音识别在本地,连文本整理也在本地完成,全链路离线。不同模型分工:Whisper/Parakeet 负责语音→文字,LLM 负责文字→结构化成稿。
④模型量化与推理优化:
本地推理的性能关键在于量化与加速:GGML 量化(Q4/Q5/Q8)在精度损失极小(WER 通常仅上升 0.1-0.5%)的情况下将模型体积和内存占用压缩 3-4 倍;计算图优化(whisper.cpp 的并行解码、KV 缓存、beam search 参数调优);硬件后端选择(Mac 用 Metal,NVIDIA GPU 用 CUDA,AMD/Intel GPU 用 Vulkan/OpenCL,纯 CPU 用 AVX2/AVX512/NEON)。模型档位与实时率:tiny 模型在普通 CPU 上即可达到 10-20 倍实时,base 约 5-10 倍,small 约 3-5 倍,medium 约 1-2 倍,large-v3 在无 GPU 时约为 0.5-1 倍(需要 GPU 或接受等待),turbo 模型(large-v3-turbo,2024 年发布)在精度接近 large 的同时速度快约 4-8 倍,是实时听写的最佳平衡点。
2.4 文本后处理:从原始转写到可用成稿
Whisper/Parakeet 输出的原始文本通常带有口语特征(语气词、重复、无标点或标点粗糙、数字格式不规范)。OpenWhispr 的文本后处理管道负责把这些原始转写变成干净的成稿:
①标点恢复与格式化:
Whisper 自带一定的标点能力(VTT/SRT 输出含标点),OpenWhispr 在此基础上做二次标点规范化——句号/逗号/问号/感叹号规则化、段落划分(按语义停顿分段落)、数字格式转换("一千二百三十四"→"1234"、"百分之十五"→"15%")、日期时间格式化、货币单位规范化。中文场景还会做中英文标点混排修正(全角/半角统一)。
②语气词与重复过滤:
过滤"嗯、啊、呃、那个、就是说"等填充词,去除句内重复("我今天今天去了"→"我今天去了"),让文字更干净。可配置过滤强度(严格/温和/不过滤),需要保留口语原始面貌的场合(如采访逐字稿)可以选择不过滤。
③自定义词典:
针对特定领域的高频专有名词(人名、地名、公司名、产品名、医学术语、法律术语、编程 API 名称)建立自定义词典,识别时优先匹配词典词条,显著降低专有名词的错字率。例如医疗场景添加"阿托伐他汀、心电图、冠状动脉",编程场景添加"PyTorch、Transformer、API、异步"等。词典以热词/替换规则形式注入推理过程(whisper.cpp 的 initial prompt / hotwords 机制)。
④AI 智能体后处理(Agent Mode):
OpenWhispr 的进阶能力——通过可配置的 System Prompt 让本地/云端 LLM 对转写文本做深度加工:生成会议纪要(要点提炼、待办事项、责任人)、文本润色(把口语转书面语、调整语气)、翻译(转写后直接翻译成目标语言)、结构化(把转写整理成 markdown 大纲/表格)、纠错(结合上下文修正同音错字)。Agent Mode 让"听写"升级为"口述文档生成",一句"帮我总结成三点"就能得到结构化输出。开发者场景下 System Prompt 完全自定义,可以针对自己的工具链定制输出格式(如直接输出 JSON、markdown 表格、代码块)。
2.5 输出:光标处自动粘贴与多端分发
转写完成的文字通过多种方式输出:
①自动粘贴(Push-to-Talk 核心体验):
识别完成后,文字自动"打字"到当前光标位置——不依赖剪贴板(或自动备份/恢复剪贴板),像键盘输入一样进入任何应用:VS Code、终端、浏览器、邮件客户端、Slack/微信、Office。按住热键说话、松开出字,全程手不离键盘。自动粘贴可开关,关闭后转写文本只显示在应用窗口,手动复制。
②应用内输出:
转写结果同时显示在 OpenWhispr 的悬浮窗/主窗口中,支持编辑、复制、保存为笔记(Note Recording 模式),笔记支持标签、搜索、导出(txt/markdown)。
③会议纪要输出:
会议转写模式(Meeting Transcription)实时生成逐字稿+纪要,支持多说话人场景(结合声纹/位置区分说话人,或由 LLM 根据语义推断分段),结束后一键导出完整纪要(含时间戳、要点、待办)。
④文件输出:
音频文件转写结果可导出为 TXT、Markdown、SRT(字幕)、VTT(Web 字幕)等格式,方便后续剪辑、发布、存档。
3.1 安装与首次启动
①下载与安装:
从 GitHub Releases 或官网(openwhispr.com)下载对应平台的安装包:macOS(Apple Silicon 建议下载 arm64 版,Intel Mac 下载 x64 版)、Windows(x64 安装包,支持 10/11)、Linux(AppImage/deb/tar.gz,支持 x86_64 和 arm64)。安装后首次启动会引导选择输入设备、模型档位和输出模式。
②隐私模式选择:
首次设置会询问处理模式——本地模式(Local,音频不出设备,推荐默认)或云端模式(Cloud,OpenWhispr Cloud 处理,更快但音频上云)。对隐私要求高的用户选择 Local,并在后续设置中保持默认。
③热键配置:
默认全局热键为按住说话(Push-to-Talk,默认 Fn 或自定义组合键),也支持切换模式(Toggle,按一下开始、再按一下结束,适合长时间口述)和静音模式。热键全局生效,在任意应用中响应。
④输出配置:
选择输出方式(自动粘贴/仅显示)、标点与格式化选项、语气词过滤强度、段落策略(每次听写是否新建段落)。
3.2 本地模型下载与切换
OpenWhispr 内置模型管理界面(Settings → Speech-to-Text → 选择模式),一键下载和切换本地模型:
|
模型档位 |
参数量 |
量化后体积(约) |
相对速度 |
适用场景 |
|
tiny |
39M |
75MB(Q5) |
10-30倍实时(CPU) |
极低配置设备、快速测试、多语言快速预览;准确率最低,嘈杂环境/口音下错字多 |
|
base |
74M |
142MB(Q5) |
5-10倍实时(CPU) |
低配设备日常听写;准确率比 tiny 明显提升,口音/术语仍有限 |
|
small |
244M |
466MB(Q5) |
2-4倍实时(CPU) |
主流推荐入门档:准确率显著提升(中文场景够用),CPU 可实时,资源占用适中 |
|
medium |
769M |
1.4GB(Q5) |
1-2倍实时(CPU)/实时(GPU) |
专业场景(法律/医疗/会议),准确率高;CPU 勉强实时,推荐 GPU/Apple Silicon |
|
large-v3 |
1.5B |
2.9GB(FP16)/1GB(Q5) |
0.5-1倍实时(CPU)/5-10倍(GPU) |
最高准确率档:多语言、复杂口音、噪声环境首选;需要 GPU 或 Apple Silicon 才能实时 |
|
large-v3-turbo |
809M |
1.6GB(Q8)/1.1GB(Q5) |
4-8倍实时(Apple Silicon/GPU) |
实时听写最佳平衡点:精度接近 large-v3,速度接近 small,Apple Silicon/GPU 上实时,推荐默认 |
模型选择建议:
①按硬件选:
Apple Silicon(M1-M4)用户直接上 large-v3-turbo 或 large-v3(Metal 加速轻松实时);NVIDIA GPU 用户 large-v3-turbo + CUDA;纯 CPU 用户 small(日常)或 medium(追求精度,接受略慢);低配/老旧设备用 base/tiny。
②按场景选:
多语言混说/口音重/环境嘈杂选 large-v3;中文普通话日常听写 small 以上即可;会议/法律/医疗等专业术语密集场景 medium 起步并配合自定义词典;实时性要求高(边说边出)选 turbo 或 Parakeet。
③按速度需求选:
听写是"说完等结果",batch 模式可接受 1-2 秒延迟;会议实时转写要求流式输出,需要小模型+流式引擎。模型可随时切换,先下载 small 用起来,再按体验升级。
3.3 NVIDIA Parakeet 模型配置
在 Speech-to-Text 设置中切换引擎为 Parakeet(sherpa-onnx),下载 Parakeet TDT 0.6B v2 模型(支持 25 种语言,ONNX 格式,约 1.3GB)。Parakeet 的优势:①推理速度显著快于同精度 Whisper(FastConformer 架构,实时率可达 10 倍以上);②多语种覆盖(25 种语言,含中英日韩法德西等);③资源占用低(CPU 即可实时,适合无 GPU 设备)。注意 Parakeet 不支持中文的某些方言/口音时,可切回 Whisper 大模型对比效果。
3.4 常见安装与配置问题排查
①麦克风无声音/识别为空:
检查系统麦克风权限(macOS 需要在系统设置-隐私-麦克风中授权,Windows 在设置-隐私-麦克风中授权);检查默认输入设备选择;用系统录音测试确认麦克风本身正常;检查热键是否被其他应用占用。
②模型下载失败/缓慢:
模型托管在 Hugging Face/GitHub,国内网络可能需要代理或镜像;可手动下载 GGML 模型文件放入模型目录(设置中可查看路径);下载中断可续传。
③转写速度慢:
确认使用的模型档位与硬件匹配(CPU 上跑 large-v3 会慢);启用 GPU 加速后端(Metal/CUDA/Vulkan);确认量化格式(Q4/Q5 比 FP16 快);关闭不必要的后台任务。
④转写结果含幻觉文本(噪声/静音下输出乱文):
启用 VAD(静音裁剪);降低麦克风增益减少底噪;使用更高档模型(大模型对噪声更鲁棒);关闭无语音输入时的自动识别。
⑤自动粘贴不生效:
确认系统剪贴板/辅助功能权限已授权(macOS 需要在系统设置-隐私-辅助功能中允许 OpenWhispr 模拟键盘输入;Linux 在 Wayland 下需要额外的输入模拟权限);确认目标应用支持键盘输入;切换为"仅显示"模式手动复制。
⑥中文识别质量差:
中文建议使用 large-v3 或 medium(小模型中文 WER 较高);确认语言自动检测或手动指定 zh;添加中文自定义词典(常见错词、专业术语);保持麦克风质量与距离。
4.1 听写模式(Dictation):Push-to-Talk 核心体验
听写模式是 OpenWhispr 的招牌功能——按住热键说话,松开热键文字出现在光标处,支持任何应用。完整流程:①按住热键(如 Fn 或自定义)→ 系统开始录音并显示悬浮提示(波形+音量);②说话(可长可短,一次听写从几秒到几分钟);③松开热键 → 录音停止 → 本地 VAD 裁剪 → 模型识别 → 文本后处理 → 自动粘贴到光标处;④手不离开键盘,继续写下一段。体验要点:
①按住模式(Push-to-Talk)vs 切换模式(Toggle):
按住模式适合短句/短段落(邮件、消息、代码注释);切换模式(按一下开始、再按一下结束)适合长时间口述(写文章、会议发言、笔记记录),避免长时间按住热键手指疲劳。
②多语言自动识别:
Whisper 支持 99+ 种语言,OpenWhispr 默认自动检测语言(语音内容自动判定),也支持手动指定语言(中文/英文/日文/韩文/法文/德文/西班牙文等),混说场景(中英混说)建议用 large 模型并开启多语言模式。
③光标上下文感知:
自动粘贴时智能判断光标处的上下文——在段落开头粘贴时自动处理首字母大小写(英文)、中文无需处理;粘贴前自动补空格/换行,保证与前后文字衔接自然。
④剪贴板保护:
自动粘贴不依赖剪贴板(直接模拟键盘输入),即使依赖剪贴板的实现也会在粘贴后恢复原始剪贴板内容,不影响你复制粘贴其他内容。
4.2 会议转写模式(Meeting Transcription)
会议转写是 OpenWhispr 面向办公场景的重要功能:
①实时转写:
会议中开启实时转写,说话内容即时上屏(流式识别,边说边出),参会人可实时看到字幕。
②说话人区分:
结合声纹特征(说话人嵌入)或音频位置(不同麦克风)区分不同说话人,转写文本按说话人分段,标注发言人("张三:这个方案我建议...")。无多麦克风时可启用 LLM 语义分段(根据内容语义推断段落边界)。
③会议纪要生成:
会议结束后一键生成纪要:要点提炼(LLM 从逐字稿提取核心结论)、待办事项(识别"我要/需要/记得"类语句生成 TODO 清单,标注责任人)、决策记录(识别"决定/确认/通过"类语句生成决策项)、时间轴(带时间戳的完整回顾)。
④本地录音文件转写:
已有录音文件(MP3/WAV/M4A)可直接拖入转写,同样生成逐字稿+纪要。批量处理多个文件,适合补录历史会议。
⑤多语言会议:
跨国会议支持多语言转写+翻译,Whisper 识别原文后由 LLM 翻译为指定语言,生成双语纪要。
4.3 音频文件转文本(Audio to Text)
拖拽音频文件即可获得完整转写文本,无需任何账号:①支持格式:MP3、WAV、M4A、AAC、OGG、FLAC、WMA 等主流格式;②处理方式:默认在设备本地处理(隐私优先),可选云端处理(OpenWhispr Cloud,更快、支持更大文件);③输出:完整转写文本(含时间戳可选)、SRT/VTT 字幕文件、Markdown/TXT 文档;④适用:会议录音、采访录音、讲座/课程录音、语音备忘录、播客节目、口述历史资料。
4.4 笔记模式(Note Recording)
笔记模式把听写与笔记管理结合:①语音笔记:按住热键口述笔记,自动保存为结构化笔记(标题+正文+标签);②笔记管理:内置笔记列表,支持搜索、标签、时间排序、导出(TXT/Markdown);③多端同步:Pro 版支持跨设备同步(端到端加密)。适合随手记灵感、会议速记、学习笔记。
4.5 AI 智能体(AI Agents)
OpenWhispr 的 AI Agent 模块允许为转写配置自定义处理流程,是区别于普通听写工具的核心能力:
①内置 Agent 模板:
会议纪要 Agent(转写→纪要)、翻译 Agent(转写→翻译)、润色 Agent(口语→书面语)、摘要 Agent(长文→要点)、格式化 Agent(转写→Markdown/JSON/表格)。
②自定义 System Prompt:
开发者可完全自定义 Agent 的 System Prompt,例如:"你是资深技术编辑,请将用户的语音转写整理为技术博客大纲,包含:背景、核心概念、代码示例建议、常见坑。" 转写文本作为 User Prompt 送入 LLM,输出即为加工结果。
③本地/云端 LLM 可选:
Agent 后处理可以使用本地 LLM(通过 llama.cpp 运行 Qwen3/Mistral/LLaMA,全离线)或云端 LLM(OpenWhispr Cloud/OpenAI 兼容接口)。隐私敏感场景选本地 LLM,形成"语音+文本"全链路不出设备。
④自动化触发:
Agent 可按规则自动触发(如"识别到会议类关键词自动执行纪要 Agent"),也可手动选择(听写完成后点击 Agent 按钮选择处理方式)。
4.6 自定义词典与热词
自定义词典显著提升专有名词识别准确率:①词条管理:添加单词/词组/专有名词(人名、地名、产品名、专业术语),支持替换规则(识别到的错误写法→正确写法);②注入机制:词条通过 whisper.cpp 的 initial prompt 或热词机制注入,识别时优先匹配;③场景词典:可按场景保存多套词典(医疗词典/法律词典/编程词典/公司内部词典),按需切换;④导入导出:词典支持 JSON 导入导出,便于团队共享。
OpenWhispr 的价值不止于开箱即用的桌面应用,它的开源特性和本地引擎能力让开发者可以深度集成到自己的系统。以下从几个层面介绍开发集成方法。
5.1 基于 whisper.cpp 的本地语音转文字核心代码
理解 whisper.cpp 的调用方式是集成 OpenWhispr 类应用的基础。以下是一个最简 C++ 示例(whisper.cpp 官方 API):
(以下代码使用普通段落展示,非代码块格式)
#include "whisper.h"
#include "common.h"
#include cstdio
#include string
#include vector
int main(int argc, char** argv) {
// 1. 初始化参数
struct whisper_context_params cparams = whisper_context_default_params();
// 2. 加载模型(GGML 量化模型文件)
struct whisper_context* ctx = whisper_init_from_file_with_params(
"models/ggml-small-q5_1.bin", cparams);
if (!ctx) { fprintf(stderr, "模型加载失败\n"); return 1; }
// 3. 读取音频(16kHz 单声道 WAV)
std::vector<float> pcmf32;
if (!read_wav("audio.wav", pcmf32)) {
fprintf(stderr, "音频读取失败\n"); return 1;
}
// 4. 识别参数:语言中文、启用标点(VAD 已预先裁剪)
whisper_full_params wparams = whisper_full_default_params(WHISPER_SAMPLING_GREEDY);
wparams.language = "zh";
wparams.print_realtime = true;
wparams.print_progress = true;
wparams.suppress_blank = true;
// 5. 执行识别(自动按静音分段,逐段输出)
if (whisper_full(ctx, wparams, pcmf32.data(), (int)pcmf32.size()) != 0) {
fprintf(stderr, "识别失败\n");
whisper_free(ctx);
return 1;
}
// 6. 遍历识别结果并打印
const int n_segments = whisper_full_n_segments(ctx);
for (int i = 0; i less_than n_segments; i++) {
const char* text = whisper_full_get_segment_text(ctx, i);
printf("[%02d:%02d] %s\n", i / 60, i % 60, text);
}
whisper_free(ctx);
return 0;
}
关键点解析:①whisper_init_from_file_with_params 加载 GGML 量化模型;②音频必须为 16kHz 单声道 float32 PCM(whisper.cpp 的标准输入格式);③whisper_full 一次处理完整音频,内部按 VAD/静音自动分段;④whisper_full_n_segments / whisper_full_get_segment_text 遍历各段文本;⑤生产环境建议启用 whisper_full_default_params(WHISPER_SAMPLING_BEAM_SEARCH) 的 beam search(精度更高)或 greedy(更快)。
5.2 Python 快速集成:faster-whisper 与 sherpa-onnx
Python 生态中,faster-whisper(基于 CTranslate2)是最常用的 Whisper 加速推理库,sherpa-onnx 是 OpenWhispr 集成 Parakeet 的引擎。以下是 faster-whisper 的听写示例:
(以下代码使用普通段落展示,非代码块格式)
from faster_whisper import WhisperModel
# 1. 加载模型:large-v3 + INT8 量化(CPU 上速度快 4 倍,精度损失极小)
# device="cuda" 可切换 GPU;compute_type="float16" 为 GPU 推荐
model = WhisperModel("large-v3", device="cpu", compute_type="int8")
# 2. 转写:返回生成器,支持流式
segments, info = model.transcribe(
"meeting.wav",
language="zh", # 指定语言,None 为自动检测
vad_filter=True, # 启用 VAD 裁剪静音,减少幻觉
vad_parameters={ # Silero VAD 参数
"min_silence_duration_ms": 500, # 最小静音段:500ms 切分
"threshold": 0.5, # VAD 灵敏度
},
beam_size=5, # beam search 宽度,越大越准越慢
word_timestamps=True, # 输出词级时间戳(字幕用)
initial_prompt="本次会议涉及:产品规划、市场推广、技术架构、预算审批。", # 热词/上下文
)
# 3. 输出:检测到的语言与置信度
print(f"检测语言: {info.language}, 概率: {info.language_probability:.2f}")
# 4. 逐段输出文本(含时间戳)
for segment in segments:
print(f"[{segment.start:.1f}s - {segment.end:.1f}s] {segment.text}")
sherpa-onnx 调用 Parakeet 的示例(跨平台、无 Python 依赖也可用):
(以下代码使用普通段落展示,非代码块格式)
import sherpa_onnx
# 1. 创建识别器(Parakeet TDT 0.6B v2,ONNX 模型)
recognizer = sherpa_onnx.OfflineRecognizer.from_parakeet(
model="parakeet-tdt-0.6b-v2.onnx",
tokens="tokens.txt",
num_threads=4,
sample_rate=16000,
feature_dim=80,
decoding_method="greedy_search",
)
# 2. 读取音频(16kHz 单声道)
import wave, numpy as np
with wave.open("audio.wav", "rb") as f:
data = np.frombuffer(f.readframes(f.getnframes()), dtype=np.int16)
# 3. 识别并输出
stream = recognizer.create_stream()
stream.accept_waveform(16000, data.astype(np.float32) / 32768.0)
recognizer.decode_stream(stream)
print(stream.result.text)
注意:以上代码为教学示例,OpenWhispr 应用内部已封装完整流程(音频采集、VAD、推理、后处理、粘贴),普通用户无需自行实现;开发者在构建自己的听写工具/服务时可以参考。
5.3 自定义词典与热词注入
在 whisper.cpp 中通过 initial_prompt 注入领域上下文是提升专有名词准确率的最简单方法:
(以下代码使用普通段落展示,非代码块格式)
# Python 示例:医疗场景热词注入
medical_prompt = ("以下为医疗口述病历。常用术语:冠状动脉粥样硬化、阿托伐他汀钙片、"
"心电图、超声心动图、冠状动脉造影、支架植入术、心功能分级、"
"高血压病、2型糖尿病、血脂异常、吸烟史、饮酒史。")
segments, _ = model.transcribe("medical_note.wav",
language="zh",
initial_prompt=medical_prompt)
要点:①热词列表要包含易错的专业术语(Whisper 对生僻专名容易谐音错字);②prompt 尽量使用自然语句而非纯词表(模型对上下文文本的引导效果更好);③不同场景切换不同 prompt 模板(医疗/法律/编程/会议);④OpenWhispr 应用内通过自定义词典界面管理,底层即此机制。
5.4 构建本地语音转文字服务(可选进阶)
对于需要批量转写或多人使用的场景,可基于以上引擎构建本地 ASR 服务:①用 FastAPI/Flask 封装 whisper 推理为 REST API(POST /transcribe,上传音频返回文本);②用 MQTT/WebSocket 实现流式转写(边说边出字幕);③结合 Silero VAD 做实时端点检测;④多模型热切换(小模型实时预览+大模型精修);⑤本地 LLM(llama.cpp/Qwen3)做纪要/润色后处理,全链路离线。OpenWhispr 桌面应用本身已经实现了完整的产品化封装,开发者构建服务时可以直接复用其模型管理与推理逻辑(开源代码可参考)。
5.5 隐私与安全配置最佳实践
①全本地模式:
设置中确认所有引擎为 Local(Whisper/Parakeet 本地 + LLM 本地),关闭任何云处理开关;②无遥测确认:开源项目默认无遥测,可从代码审计确认(搜索 network/telemetry/analytics 相关代码);③系统权限最小化:仅授予麦克风、辅助功能(模拟键盘输入)所需权限;④敏感环境:涉密环境使用完全离线的 air-gapped 模式(模型提前下载,后续断网使用);⑤数据清理:临时音频文件自动删除,定期清理笔记与转写历史(设置中可一键清空);⑥更新审计:更新软件时先看 changelog 与 diff,确认无新增遥测/云行为;也可以完全从源码自行构建(make build),杜绝供应链风险。
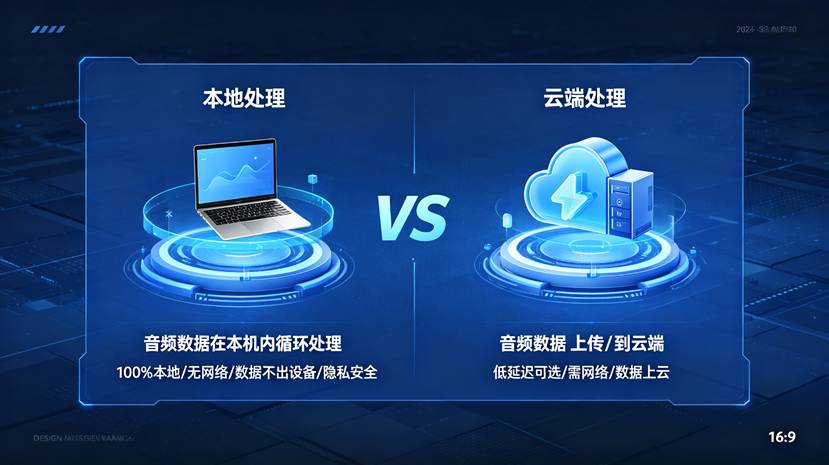
本地处理与云端处理对比示意图:左侧本地处理(音频数据在本机内循环,100%本地/无网络/数据不出设备/隐私安全),右侧云端处理(音频上传云端,需网络/数据上云),中间VS分隔
6.1 各硬件平台的性能基准与选型
OpenWhispr 的本地转写性能取决于模型档位与硬件平台的组合。以下为参考性能范围(基于 whisper.cpp 与 sherpa-onnx 在 2025-2026 年主流硬件上的实测,实时率=实时倍速,越大越快):
|
硬件平台 |
加速后端 |
small 实时率 |
large-v3-turbo 实时率 |
large-v3 实时率 |
|
Apple Silicon M1/M2(Mac) |
Metal |
8-15倍 |
4-8倍 |
2-5倍 |
|
Apple Silicon M3/M4 Pro(Mac) |
Metal |
15-25倍 |
6-12倍 |
3-6倍 |
|
NVIDIA RTX 3060/4060(Win/Linux) |
CUDA |
20-40倍 |
8-15倍 |
4-8倍 |
|
NVIDIA RTX 4080/4090 |
CUDA |
40-60倍 |
12-20倍 |
6-10倍 |
|
中端 x86 CPU(i5/R5) |
AVX2 |
2-4倍 |
0.5-1倍 |
0.2-0.5倍 |
|
高端 x86 CPU(i9/R9) |
AVX512 |
4-8倍 |
1-2倍 |
0.5-1倍 |
|
AMD GPU(Win/Linux) |
Vulkan |
10-20倍 |
3-6倍 |
1-3倍 |
|
无 GPU 笔记本(低功耗) |
CPU |
1-2倍 |
0.3-0.5倍 |
0.1-0.2倍 |
选型建议:①Mac 用户(Apple Silicon)体验最佳,large-v3-turbo 是默认推荐;②Windows/Linux 有 NVIDIA GPU 用户直接用 large-v3-turbo + CUDA;③无 GPU 用户建议 small(实时)或 medium(稍慢但更准),避免 large 系列(等待过久影响听写流);④Parakeet 引擎在 CPU 上的实时率约为 Whisper large 的 5-10 倍,无 GPU 用户优先尝试;⑤多语言/口音/噪声复杂场景,模型精度优先于速度,接受 1-3 秒等待。实时率数据为参考区间,实际值受模型量化档位、CPU/GPU 负载、音频长度影响。
6.2 识别精度优化
①麦克风与录音质量:
近讲麦克风+低噪声环境是精度的第一保障。增益适中(不过载不失真),距离 10-30cm,避免对着风扇/空调/键盘声。环境噪声大时启用降噪(OpenWhispr 集成 RNNoise/噪声抑制或依赖模型本身的鲁棒性)。
②模型档位与语言:
中文日常 small 够用,专业场景 medium/large-v3;多语言自动检测偶尔误判时手动指定语言;中英混说用 large 并开启多语言;口音重(方言、非母语口音)尽量用 large-v3。
③自定义词典与热词:
高频专有名词(人名/地名/术语/产品名)建立词典,可降低专名错字率 50-90%;initial_prompt 注入场景上下文("这是技术会议,涉及:API、数据库、微服务架构");词典按场景切换。
④VAD 与分段策略:
静音阈值调优(环境安静可提高阈值裁剪更彻底);长段落口述关闭过短静音切分,避免语义被切断;噪声环境启用 Silero VAD。
⑤后处理纠错:
开启语气词过滤+标点恢复;AI Agent 二次纠错(LLM 根据上下文修正同音错字);人工校对高频错词并加入词典(反馈闭环)。
⑥精度评估方法:
用 WER(词错误率)评估:准备一段已知文本的录音,转写后计算替换/删除/插入错误率。基准参考:large-v3 在清晰语音上 WER 2-5%(英文)、中文 5-10%(受口音/术语影响);small 中文 WER 约 10-20%。以实际场景实测为准。
6.3 性能与资源优化
①模型量化:
GGML Q4_K/Q5_K 量化在 WER 仅损失 0.1-0.5% 的情况下将模型体积和内存占用降低 3-4 倍,是本地部署的默认选择;内存充足且追求极致精度用 Q8_0 或 FP16。
②批处理与并发:
音频文件批量转写时启用批处理(whisper.cpp 支持多文件串行/并行),GPU 上并行 batch 提升吞吐;会议实时转写使用流式引擎(边说边出),避免整段等待。
③后台驻留:
OpenWhispr 常驻后台(菜单栏/托盘),热键唤醒,空闲时内存占用低(模型常驻内存约 0.1-1GB 视档位);关闭 GPU 时自动回退 CPU。
④长音频分段:
超长音频(1小时+)自动按 VAD 分段识别,避免上下文窗口溢出,同时保留时间戳。
6.4 常见故障排查
|
问题现象 |
可能原因 |
解决方法 |
|
热键无响应 |
权限未授权/热键冲突/后台被关闭 |
检查麦克风与辅助功能权限;更换热键组合;确认应用在后台运行;macOS 检查"输入监控"权限 |
|
识别结果为空 |
静音裁剪过度/增益过低/模型未加载 |
降低 VAD 灵敏度;提高麦克风增益;确认模型已下载并选中;测试系统录音 |
|
转写太慢 |
模型过大/无 GPU/量化档位不当 |
切换 turbo/small;启用 GPU 后端;确认 Q4/Q5 量化;关闭后台高负载任务 |
|
专有名词错字 |
词表未覆盖/模型档位低 |
添加自定义词典;注入场景 initial_prompt;升级模型档位 |
|
自动粘贴乱码 |
输入法/终端编码冲突 |
切换为剪贴板粘贴模式;调整输入法状态;Linux 检查 Wayland 输入模拟配置 |
|
模型下载失败 |
网络问题/镜像不可达 |
配置代理;手动下载模型放入模型目录;使用镜像源 |
OpenWhispr 所处的语音转文字赛道竞争激烈,从云端大厂到本地开源工具各有定位。以下从隐私、成本、精度、平台等维度对比主流产品:
|
产品/方案 |
处理模式 |
核心引擎 |
成本 |
特点与局限 |
|
OpenWhispr(开源本地听写) |
本地优先(可选云端) |
whisper.cpp + NVIDIA Parakeet(sherpa-onnx)+ 本地 LLM(llama.cpp) |
免费开源;Pro 8美元/用户/月(云端+移动端) |
隐私优先全本地、99+语言、模型自由切换、跨平台(macOS/Win/Linux)、AI Agent 后处理、开源可审计;需要自己管理模型(下载/切换)、本地精度受硬件限制 |
|
Whisper 原生/whisper.cpp/faster-whisper(命令行/库) |
纯本地 |
OpenAI Whisper(原始 Python 版/C++ 移植版/CT2 加速版) |
免费开源 |
灵活可编程、生态最大、99+语言、精度高(large-v3 SOTA);无 GUI、需要编程能力、无自动粘贴/热键等听写体验,适合开发集成 |
|
Buzz(开源转写 GUI) |
本地 |
whisper.cpp/faster-whisper |
免费开源 |
拖拽文件转文本+实时录音转写,跨平台免费;主要是文件转写工具,听写体验(热键/光标粘贴)弱于 OpenWhispr |
|
MacWhisper(Mac 转写应用) |
本地 |
Whisper(Metal 加速) |
免费层(tiny/base)+ 买断 Pro |
Mac 生态成熟、UI 精美、字幕导出完善;仅限 Mac、听写/热键能力弱于 OpenWhispr、Pro 需付费 |
|
Superwhisper(Mac 听写) |
本地 |
Whisper |
订阅(约12美元/月) |
Mac 上成熟的听写体验(热键/自动粘贴/语音命令)、UI 好;仅限 Mac、订阅制、闭源 |
|
SnailText(跨平台听写) |
本地 |
Whisper(Vulkan/Metal 加速) |
免费层+Pro 买断 |
Win+Mac 听写体验好、Windows GPU(Vulkan)支持、免费层无限;相对小众、生态较小 |
|
Vosk(开源轻量 ASR) |
本地 |
Kaldi 系轻量模型 |
免费开源 |
真正流式实时、模型极小(50-200MB)、支持约20种语言、嵌入式友好;精度低于 Whisper、无标点、语言覆盖少 |
|
系统自带听写(Apple Dictation/Windows 语音输入) |
本地+云端混合 |
厂商自研 |
系统免费 |
零安装即用、与系统集成好;精度/语言覆盖有限、高级功能少、部分处理仍上云、不可自定义模型 |
|
讯飞听见/搜狗听写(国内云端) |
云端 |
厂商自研大模型 |
按分钟计费/会员 |
中文精度高、方言支持好、服务完善(人工转写可选);音频上云有隐私风险、断网不可用、长期成本高 |
|
Otter.ai/Rev/Google Live Transcribe(海外云端) |
云端 |
厂商自研 |
订阅/按量计费 |
会议协作生态好(Otter 自动参会/纪要)、多语言;音频上云、订阅成本、网络依赖、数据留存平台 |
|
FunASR/SenseVoice(阿里开源) |
本地/服务端 |
Paraformer/SenseVoice(中文优化) |
免费开源 |
中文场景精度高、标点/说话人分离开箱即用、CPU 友好;英文/多语言覆盖弱于 Whisper、主要是库(需自行封装应用) |
选型建议:①隐私敏感/离线刚需/跨平台/开源可审计 → OpenWhispr(本地模式);②纯开发者集成/批量转写服务 → whisper.cpp/faster-whisper 库;③Mac 用户重听写体验且可付费 → Superwhisper/MacWhisper;④中文场景高精度 → FunASR/SenseVoice 或讯飞云端(接受上云);⑤嵌入式/流式实时 → Vosk;⑥零安装日常简单使用 → 系统自带听写。OpenWhispr 的差异化优势在于"本地+跨平台+热键听写+Agent 后处理+开源"的组合,是目前隐私优先听写场景最完整的一站式方案。
①软件开发与写代码:
语音写注释、口述技术方案/设计文档、在 IDE/终端/Slack/GitHub Review 中语音输入,一个热键全局可用;自定义编程词典(API 名、框架名、变量名);Agent 模式把口述整理为结构化的技术文档/会议纪要。特别适合配合 AI 编程助手使用——口述需求,AI 直接生成代码。
②医疗行业:
医生口述病历(临床记录、出院小结、手术记录),本地处理满足患者隐私保护与 HIPAA/《个人信息保护法》合规要求;医疗术语词典(药品名、疾病名、检查项目)提升专名准确率;离线可用(医院内网/断网环境);律师/法务同理(法律文书起草、案件记录,涉密内容不出设备)。
③内容创作与写作:
作家口述初稿(小说/剧本/文章,语速3-5倍于打字,保持思维流)、记者采访录音转写(本地批量处理、逐字稿+时间戳)、播客/视频创作者(录音转字幕 SRT/VTT,本地处理保护未发布素材)、公众号作者(口述成稿+Agent 润色成文)。
④商务办公:
邮件/报告/Slack/微信消息语音输入、会议实时转写+纪要生成(要点/待办/决策)、出差途中断网场景离线听写、多语言商务沟通(中英日韩法实时转写+翻译)。
⑤教育与学习:
学生课堂录音转笔记(讲座逐字稿+要点提炼)、研究人员文献口述笔记、语言学习者(语音转写检查发音、多语言对照)、网课/慕课笔记整理。
⑥记者/研究员田野场景:
采访现场离线录音+本地转写(不联网、不泄露受访者信息)、口述历史资料整理、田野笔记语音记录、多语种采访(少数民族语言/外语自动识别)。
⑦政府与涉密单位:
完全离线(air-gapped)环境下的语音转文字,模型预装、永不上网,满足保密要求;公文起草语音输入;会议纪要本地生成,数据零外流。开源代码可审计,供应链可控。
⑧无障碍与特殊人群:
行动不便者/打字困难者语音输入替代键盘、视障用户语音交互、老年用户语音发消息/写邮件、语言障碍者语音辅助。本地处理保障隐私,无网络也能用。
⑨企业本地化部署:
企业内网部署 OpenWhispr 作为全员听写工具(模型预装、数据不出内网);结合企业词典(内部术语/产品名/人员名)统一配置;与 OA/邮件/IM 集成(自动粘贴即用);管理员统一管理模型与词典(配置文件下发)。
9.1 当前挑战
①本地硬件性能门槛:
高精度模型(large-v3)在无 GPU/非 Apple Silicon 设备上难以实时,CPU 用户只能在小模型(精度有限)和大模型(等待久)之间妥协。本地推理的算力天花板限制了"高精度+实时"兼得。
②中文与方言识别精度:
Whisper 系列对中文的支持虽好(large-v3 中文 WER 5-10%),但方言(粤语、闽南语、四川话等)和口音重的中文识别仍有限;专有名词(人名/地名/术语)错字率偏高,依赖词典弥补。相比讯飞等深耕中文的厂商,中文场景精度仍有差距。
③长音频与上下文理解:
Whisper 是逐段识别(每段约 30 秒),长音频分段后缺乏全局上下文——同一术语在文档前部出现后,后部仍可能识别错;说话人区分(多说话人会议)能力弱于专用方案(需依赖 LLM 语义分段或声纹模型)。
④AI Agent 后处理的本地 LLM 资源开销:
本地运行 LLM(Qwen3-8B 等)做后处理需要 8-16GB 内存和较强算力,低配设备上会明显拖慢流程;云端 LLM 则牺牲隐私闭环。本地"STT+LLM"全链路需要中高端硬件。
⑤生态与认知度:
相比讯飞/Otter 等商业产品,OpenWhispr 作为新兴开源项目,文档/教程/社区支持还在完善中;普通用户对"本地模型"概念陌生(需要下载大文件、选择模型),入门门槛高于零配置的云端工具;Pro 订阅模式的长期可持续性待观察。
⑥实时流式转写体验:
Whisper 原生是"说完再识别"(batch),流式(边说边出)依赖 whisper.cpp 的流式模式或 Parakeet 流式引擎,体验与专用流式 ASR(如 Vosk、云服务流式接口)相比仍有差距;实时字幕场景需要额外优化。
9.2 未来趋势
①端侧模型持续进化:
Whisper 的下一代(OpenAI 持续更新)、Parakeet 系列迭代、以及更多高效 ASR 架构(FastConformer、Zipformer、Streaming 变体)将进一步提升本地精度与速度;量化与蒸馏技术(INT4/INT8、蒸馏小模型)让高精度模型在消费级硬件上实时运行成为常态。
②大模型驱动的语音理解:
多模态大模型(Qwen-Audio、GPT-4o 语音、Gemini 语音)把"语音转文字"升级为"语音理解"——不只是转写,还能理解意图、生成纪要、回答问题、执行任务。OpenWhispr 的 AI Agent 架构正是这个方向的雏形,未来本地小参数多模态模型将进一步增强本地语音智能。
③本地 AI 一体化:
"本地 STT + 本地 LLM + 本地向量库"的全本地 AI 栈趋势(隐私优先的企业 AI 部署)将推动 OpenWhispr 类工具成为本地 AI 工作流的关键一环——语音输入是本地 LLM 最自然的交互入口。Apple/Qualcomm/NVIDIA 的端侧 AI 芯片(NPU)持续升级,本地推理能力指数增长。
④场景化与行业化:
医疗、法律、金融、政务等行业的专业语音转写需求(专业词典、合规要求、私有化部署)将催生更多行业定制版本;OpenWhispr 的开源架构让行业集成(企业词典、私有模型、合规审计)成本更低。
⑤跨语言与实时翻译:
Whisper 的 99+ 语言能力+LLM 翻译的组合,使"边说边译"成为现实——实时同传、跨国会议、外语学习场景将受益;本地处理使隐私敏感的国际交流成为可能。
⑥开放生态与社区驱动:
开源社区将继续围绕 whisper.cpp、sherpa-onnx、llama.cpp 构建更完整的本地语音栈;OpenWhispr 类应用将成为社区能力的"产品化出口"——模型/引擎/后处理模块可插拔,用户按需组装,形成"本地语音应用商店"的生态雏形。
OpenWhispr 是语音转文字领域"本地优先、隐私第一"路线的代表产品,它用开源的方式把 OpenAI Whisper(whisper.cpp)、NVIDIA Parakeet(sherpa-onnx)等顶级本地语音模型包装成一个即装即用的跨平台听写应用:按住热键说话、松开即出文字、光标处自动粘贴、任何应用可用,全程音频不出设备、无需联网、无账号、无遥测。核心能力覆盖:Push-to-Talk 听写(任何应用语音输入)、会议实时转写与纪要生成、音频文件批量转文本(MP3/WAV/M4A 等)、语音笔记、AI Agent 后处理(LLM 整理/翻译/摘要/结构化,可本地可云端)、自定义词典与热词、99+ 语言支持、模型全档位自由切换(tiny 到 large-v3-turbo + Parakeet)。
技术架构上,OpenWhispr 的"音频采集→VAD 端点检测→本地模型推理(whisper.cpp/Parakeet)→文本后处理(标点/词典/Agent)→输出(自动粘贴/纪要/字幕)"五段流水线清晰可解,每一环都有成熟的工程实践:16kHz 单声道标准输入、Silero/WebRTC VAD 静音裁剪、GGML 量化模型(Q4/Q5,体积缩 3-4 倍精度损失极小)、Metal/CUDA/Vulkan 硬件加速、initial_prompt 热词注入、LLM Agent 二次加工。模型选型遵循"硬件决定档位、场景决定精度"的原则:Apple Silicon/NVIDIA GPU 用户首选 large-v3-turbo,无 GPU 用户用 small 或 Parakeet,专业术语密集场景 medium 起步+自定义词典。
与讯飞/Otter 等云端方案相比,OpenWhispr 的核心差异是数据主权——音频和文字从物理上不出设备,满足医疗(HIPAA)、法律、金融、政务、涉密单位等对隐私和合规有硬性要求的场景;与纯命令行库(whisper.cpp)相比,它提供了完整的听写产品体验(热键/粘贴/词典/Agent/多模式);与 MacWhisper/Superwhisper 等商业本地应用相比,它跨平台(macOS/Windows/Linux)且完全开源免费。短板同样明确:本地硬件门槛、中文方言与专名精度、长音频上下文、实时流式体验仍需改进。
更多推荐

 6
 0
- 0


 已为社区贡献8条内容

所有评论(0)