


- @weixin_53318497


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
动态规划(DP)涉及将问题,并使用的方法解决它们。对于具有重叠子问题和最优子结构的问题使用此模式。动态规划的核心是注意:有些问题(如 01 背包)需要逆序遍历容量以避免重复选择。
给定一个二叉树的根节点 root ,返回 它的 中序 遍历。示例 1:输入:root = [1,null,2,3]输出:[1,3,2]示例 2:输入:root = []输出:[]示例 3:输入:root = [1]输出:[1]提示:树中节点数目在范围 [0, 100] 内进阶: 递归算法很简单,你可以通过迭代算法完成吗?
给你二叉树的根节点 root ,返回其节点值的 层序遍历。(即逐层地,从左到右访问所有节点)。示例 1:输入:root = [3,9,20,null,null,15,7]输出:[[3],[9,20],[15,7]]示例 2:输入:root = [1]输出:[[1]]示例 3:输入:root = []输出:[]提示:树中节点数目在范围 [0, 2000] 内。
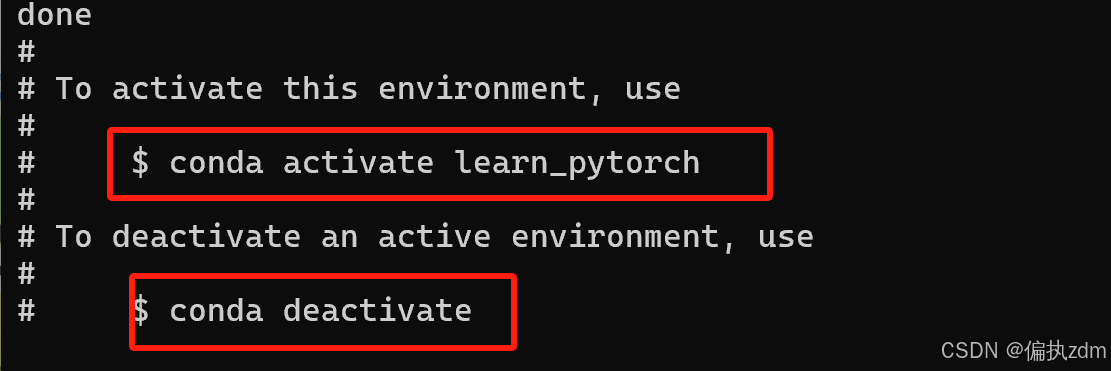
打开Anaconda Prompt一开始是在base环境,可以使用来进行创建一个新的环境。创建完毕之后如下图所示:使用激活环境接下来就是安装pytorch进入pytorch官网,如下图所示可以通过选择相关版本来生成命令进行安装(很不幸我的电脑并没有英伟达的独显,先用CPU跑着吧)接下来就将刚刚的命令输入进行安装。安装完毕就可以使用pip list来查看安装的包。到这里pytorch就安装完成了。
0penAI库是OpenAI官方推出的Python SDK,,无需手动处理HTTP请求、身份验证等底层细节。由于其发布较早且比较易用,现如今许多模型服务商(如阿里云百炼平台)均兼容0penAI SDK的调用。
当前金融领域信息化发展的时代,金融数据大量激增,许多投资者和研究者试图通过对这些数据进行深度分析而获得一些有效的决策和帮助,尽可能减少决策失误带来的损失。所以,针对金融数据的分析方法研究是目前十分有益且热门的话题。基于大模型完成:金融文本分类基于大模型完成:金融文本信息抽取基于大模型完成:金融文本匹配大模型选择:Qwen在线大模型(阿里云通义千问)基于 Few-Shot + Zero-Shot 的
LLM的知识不是实时的,模型训练好后不具备自动更新知识的能力,会导致部分信息滞后LLM领域知识是缺乏的,大模型的知识来源于训练数据,这些数据主要来自公开的互联网和开源数据集,无法覆盖特定领域或高度专业化的内部知识幻觉问题,LLM有时会在回答中生成看似合理但实际上是错误的信息数据安全性RAG(Petrieval-Augment Generation) 即检索增强生成,为大模型提供了从特定数据源检索到
本次项目以"某东商品衣服"为例,以衣服属性构建本地知识。使用者可以本地知识,用户问题的答案也是生成的。
给定一个长度为 n 的整数数组 height。有 n 条垂线,第 i 条线的两个端点是 (i, 0) 和 (i, height[i])。找出其中的两条线,使得它们与 x 轴共同构成的容器可以容纳最多的水。返回容器可以储存的最大水量。说明:你不能倾斜容器。示例 1:输入:[1,8,6,2,5,4,8,3,7]输出:49解释:图中垂直线代表输入数组 [1,8,6,2,5,4,8,3,7]。在此情况下,
智能体(Agent) 是一种能够自主规划、决策、执行任务的组件,核心是让大语言模型(LLM)根据任务需求,选择并调用工具,完成单靠模型自身无法解决的复杂问题。需求 -> 规划 -> 选择工具(提供行动力) (整个流程中,会保存记忆)核心特点:Agent的作用——例子与chain对比:Agent智能体=大语言模型(大脑)+工具集(手脚)+决策逻辑(思维),是让LLM从"只会回答"升级为"会做事(影响