

写文章


- @weixin_42799533


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
计算机视觉28:世界模型与视频扩散
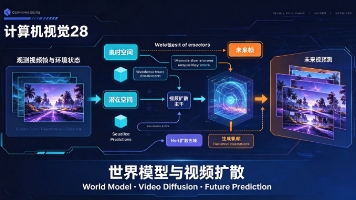
本课探讨视频扩散模型如何演变为可学习的世界模拟器。纯视频生成模型(如Sora 2)仅凭提示生成视频,而动作条件化世界模型(如Genie 3、GWM-1 Worlds)可通过动作预测未来帧,实现交互式模拟。核心架构采用时空3D分块与旋转位置编码,结合联合注意力机制。该范式已广泛应用于自动驾驶(如NVIDIA Cosmos-Drive)与机器人技术——通过VLM规划、视频模型模拟、逆动力学执行构成闭环
计算机视觉13:3D 视觉 — 点云与 NeRF
本文介绍3D视觉的两大核心表示:点云与NeRF。点云是传感器原始输出,通过PointNet的共享MLP与最大池化实现置换不变性,适用于分类与分割;NeRF则以神经网络学习体积场,结合位置编码与体渲染,从多视角图像重建3D场景。其后继者如Instant-NGP与3D高斯泼溅显著提升训练与渲染效率。两者共同解决“空间中什么在哪里”的问题,推动机器人、自动驾驶与AR/VR发展。
到底了